Kiểm thử tích hợp AI: vì sao nên xây tầng rẻ nhất trước
Assertion và contract rẻ, chạy nhanh, bắt lỗi sớm; eval và end-to-end để sau, với ít test hơn.
Tóm tắt nhanh
- Với agent, mỗi tầng của kim tự tháp thể hiện mức bất định bạn chấp nhận được, chứ không chỉ là một loại test.
- Hãy bắt đầu bằng assertion và contract, vì chúng rẻ, chạy nhanh và bắt được lỗi tích hợp với hệ thống của khách hàng.
- Eval nên khởi đầu từ 20-50 ca lỗi thật. Còn end-to-end thì chỉ giữ vài luồng quan trọng nhất.
Ở site khách hàng, bạn hiếm khi đủ thời gian xây mọi tầng test cho một tích hợp LLM ngay trong tuần đầu. Bạn phải chọn viết gì trước. Nếu chọn sai, bạn sẽ có một bộ test vừa chậm, vừa chập chờn, lại không bắt được những lỗi mà khách hàng sẽ phát hiện trước bạn.
Kim tự tháp kiểm thử, như Ham Vocke trình bày trong bài “The Practical Test Pyramid” trên blog của Martin Fowler, chỉ có một quy tắc chính: càng lên tầng cao, càng ít test. Khi bạn đưa một mô hình ngôn ngữ vào hệ thống của khách hàng, quy tắc này vẫn đúng. Cái thay đổi là ý nghĩa của từng tầng.
Đội kỹ sư của Block mô tả sự thay đổi đó rất gọn. Với agent, các tầng của kim tự tháp không còn chỉ là các loại test khác nhau. Chúng cho biết bạn sẵn sàng chấp nhận bao nhiêu bất định.
Bốn tầng, xếp theo mức bất định
Tầng dưới cùng là các assertion xác định. Hamel Husain, người viết nhiều về eval cho sản phẩm AI, gọi đây là Level 1 và nhấn mạnh rằng tuyệt đối không được bỏ qua bước này. Các assertion kiểm tra những gì code kiểm tra được: JSON có parse được không, đủ trường chưa, có lộ dữ liệu không được phép ra không.
Tầng thứ hai là contract. Bài của Vocke trên blog của Martin Fowler dựa vào consumer-driven contract, tức để bên gọi API quyết định contract cần có gì. Công cụ Pact gọi contract giữa consumer và provider là một “pact”.
Khi verify, Pact so phản hồi thật của provider với phản hồi tối thiểu mà test phía consumer đã ghi lại. Nhờ vậy test chỉ kiểm tra đúng những gì bạn thực sự dùng.
Block đưa ý tưởng này vào agent. Họ ghi lại tương tác thật với tool một lần, rồi dùng lại bản ghi đó cho mọi lần chạy sau, và assert trên chuỗi lời gọi tool.
Mô hình vẫn có thể diễn đạt khác đi giữa các lần chạy, nhưng thứ tự các lời gọi tới hệ thống bên ngoài thì được giữ cố định. Ví dụ bên dưới đi xa hơn Block một bước: kiểm tra cả tham số của lời gọi.
Tầng thứ ba là eval. Anthropic định nghĩa eval khá đơn giản: đưa cho hệ thống AI một đầu vào, rồi áp logic chấm điểm lên đầu ra. Với agent, logic chấm điểm thường kết hợp ba loại: chấm bằng code, chấm bằng mô hình và chấm bằng người. Vì vậy tầng này không còn hoàn toàn xác định.
Trên cùng là end-to-end. Bài trên blog của Martin Fowler cảnh báo loại test này nổi tiếng là chập chờn, hay hỏng vì những lý do không ai đoán trước được. Thêm một mô hình không xác định vào giữa thì độ chập chờn chỉ tăng chứ không giảm.
| Tầng | Kiểm tra gì | Khi hỏng, thường do |
|---|---|---|
| Assertion | Schema, trường bắt buộc, quy tắc cứng | Bug trong code hoặc prompt làm vỡ định dạng |
| Contract / replay | API của khách hàng và chuỗi lời gọi tool | Khách hàng đổi API, agent gọi sai thứ tự |
| Eval | Chất lượng đầu ra trên ca thật | Đổi prompt, đổi model, dữ liệu mới |
| End-to-end | Cả luồng từ người dùng tới hệ thống đích | Mạng, môi trường, độ trễ, mọi thứ ở trên |
Đi qua một tích hợp cụ thể
Lấy một ví dụ giả định. Bạn xây agent đọc hoá đơn PDF của nhà cung cấp, trích xuất số tiền và mã đơn hàng, rồi gọi API ERP của khách hàng để tạo bút toán. Lỗi có thể đến từ ba phía: mô hình đọc sai, code của bạn xử lý sai, hoặc API ERP trả về thứ bạn không lường trước.
Tầng assertion viết trong một buổi chiều và chạy dưới một giây:
def test_extraction_shape(extract):
    out = extract("fixtures/invoice_017.pdf")
    assert set(out) >= {"vendor_id", "amount", "currency", "po_number"}
    assert out["amount"] > 0
    assert out["currency"] in {"USD", "EUR", "VND"}
    assert out["po_number"].startswith("PO-")
Test này không quan tâm mô hình diễn đạt ra sao. Nó chỉ chặn những đầu ra mà code phía sau chắc chắn không xử lý được.
Tầng contract có giá trị nhất với FDE, vì API của khách hàng là thứ bạn không kiểm soát. Bạn ghi lại một lần gọi thật tới ERP trong môi trường staging, lưu vào file, rồi viết test replay:
def test_posting_flow(replay):
    calls = replay.run("cassettes/invoice_017.json")
    assert [c.tool for c in calls] == ["lookup_po", "create_journal_entry"]
    assert calls[1].args["amount"] == calls[0].result["open_amount"]
Nếu agent bỏ qua bước tra đơn hàng mà ghi thẳng bút toán, test replay sẽ đỏ. Nhưng cassette chỉ là bản ghi của lần gọi cũ. Nếu tuần sau đội IT của khách hàng đổi tên trường open_amount, replay vẫn xanh, vì nó không hề chạm vào API thật.
Lỗi đó cần một bước kiểm tra riêng ở phía provider, theo kiểu verify của Pact: lấy các phản hồi tối thiểu mà test phía consumer đã ghi, rồi so với phản hồi thật của API staging. Replay giữ cho agent gọi đúng thứ tự; verify phía provider báo cho bạn khi API của khách hàng đổi. Bạn cần cả hai.
Đến eval, Anthropic khuyên bắt đầu nhỏ: 20-50 tác vụ đơn giản lấy từ lỗi thật đã đủ tốt để khởi đầu. Hoá đơn hai trang, hoá đơn ghi số tiền theo kiểu châu Âu, hoá đơn thiếu mã đơn hàng đều là những ca nên có trong bộ đầu tiên. Bạn lấy chúng từ log và ticket, không ngồi tự nghĩ ra.
Vì sao 90% có thể là con số đánh lừa
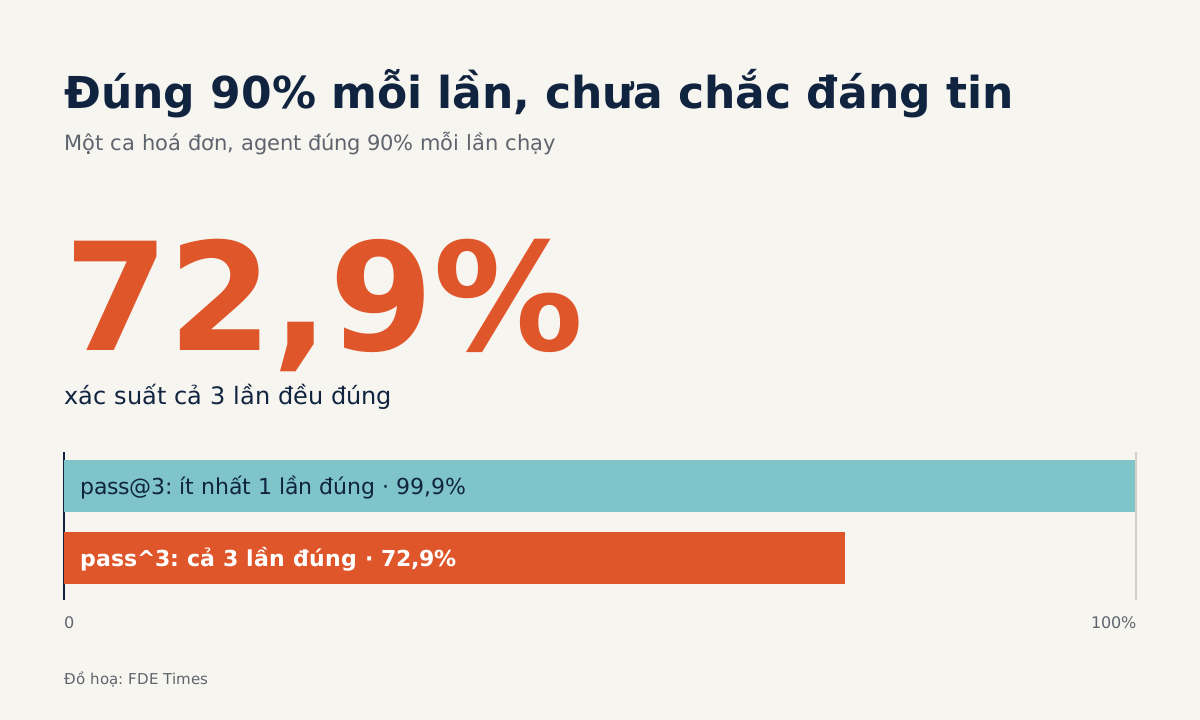
Anthropic phân biệt hai cách đo. pass@k là xác suất có ít nhất một trong k lần thử thành công. pass^k là xác suất cả k lần thử đều thành công, và đây mới là thước đo độ tin cậy.
Thử tính với một ca hoá đơn mà agent làm đúng 90% mỗi lần chạy. pass@3 bằng 1 − 0,1³, tức 99,9%, nhìn rất đẹp. pass^3 bằng 0,9³, tức 72,9%. Nếu agent tự động ghi sổ cho khách hàng thì con số bạn phải báo cáo là cái thứ hai.
Con số này không nhất thiết phải là 100%. Husain cho rằng tỉ lệ pass là một quyết định sản phẩm, tuỳ vào loại lỗi bạn chấp nhận được. Một luồng có người duyệt lại phía sau có thể chấp nhận mức 72,9%. Một luồng chuyển tiền tự động thì không.
Cũng vì thế, Block định nghĩa lại regression. Với hệ thống không xác định, đầu ra thay đổi chưa phải là regression. Regression là khi tỉ lệ thành công giảm. Khi đổi prompt, bạn so pass^k trước và sau, chứ không diff từng câu trả lời.
Xây theo thứ tự nào trong hai tuần đầu
Husain xếp các tầng theo chi phí: Level 3 đắt hơn Level 2, Level 2 đắt hơn Level 1. Lập luận đó đủ để quyết định thứ tự. Ngày đầu tiên, bạn viết assertion cho mọi đầu ra mà code phía sau dùng tới.
Tiếp theo, ngay khi có quyền truy cập staging của khách hàng, bạn ghi lại các lời gọi tool thật, dựng test replay và bước verify phía provider. Nên làm việc này sớm: cassette chỉ ghi được khi bạn còn vào được staging, và có nó trong tay thì phần lớn test sau đó chạy được mà không cần đụng tới hệ thống của khách hàng.
Sang tuần thứ hai, gom 20 ca lỗi đầu tiên thành bộ eval, chạy mỗi ca vài lần và ghi lại pass^k. End-to-end để sau cùng, chỉ vài luồng mà nếu hỏng thì khách hàng chắc chắn biết, và chạy theo lịch chứ không chặn mỗi lần merge.
Những lỗi hay gặp
Lỗi phổ biến nhất là đảo ngược kim tự tháp. Bạn có hàng chục test end-to-end gọi model thật và ERP thật, mỗi lần chạy mất mười phút và đỏ ngẫu nhiên. Sau vài tuần, cả đội quen với màu đỏ và không còn tin bộ test nữa.
Lỗi thứ hai là giao hết việc chấm điểm cho một mô hình khác, trong khi rất nhiều tiêu chí kiểm tra được bằng code. Chấm bằng code rẻ và xác định, nên dùng nó ở mọi chỗ có thể. Chấm bằng mô hình để dành cho những gì code không đánh giá được.
Lỗi thứ ba là đặt mục tiêu 100% cho eval rồi mắc kẹt ở đó, hoặc ngược lại, coi mọi thay đổi trong câu chữ là regression. Cả hai đều khiến bạn mất công sửa những dao động ngẫu nhiên, trong khi chất lượng thật của agent không hề nhúc nhích.
Về nghề nghiệp, kỹ năng này dễ thể hiện. Trong CV, thay vì viết “viết test cho hệ thống AI”, hãy ghi rõ bạn dựng tầng contract với API của khách hàng và theo dõi pass^k qua từng lần đổi prompt.
Khi phỏng vấn, nếu được hỏi cách biết agent đã sẵn sàng cho production, hãy vẽ kim tự tháp này và giải thích vì sao bạn xây tầng dưới trước.
Vào ngày đưa agent lên production, khách hàng thường chỉ quan tâm một điều: lần sau đổi model, làm sao biết nó không làm hỏng sổ sách của họ. Tầng contract và con số pass^k là câu trả lời bạn đưa ra được bằng dữ liệu.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
5 nguồn
- The Practical Test Pyramid · 2018-02-26
- How Pact works
- Your AI Product Needs Evals · 2024-03-29
- Demystifying evals for AI agents · 2026-01-09
- Testing Pyramid for AI Agents · 2026-01-12