HPE Private Cloud AI: năm lớp người triển khai phải nắm trước khi đến chỗ khách
Khách mua trọn bộ AI dựng sẵn chưa có nghĩa là bạn hết việc: phần khó nhất vẫn còn nguyên, đó là nối hệ thống với dữ liệu thật, đội ngũ thật và các ràng buộc bảo mật thật.

Tóm tắt nhanh
- Mua trọn gói chỉ rút ngắn khâu lắp đặt. Việc nối hệ thống với dữ liệu, con người và ràng buộc bảo mật của khách vẫn do người triển khai làm
- Chia stack thành năm lớp (phần cứng, dữ liệu, NVIDIA AI Enterprise, AI Essentials, vận hành) rồi hỏi khách đúng một câu then chốt ở mỗi lớp
- Đi từ ràng buộc đến tính năng: chốt air-gapped và multi-tenancy trước, rồi mới chọn mô hình và blueprint
Hợp đồng đã ký xong. Vài tuần nữa, một dàn máy chủ có GPU sẽ được đặt vào datacenter của khách, kèm lời hứa đây là “AI trong một chiếc hộp”. Còn bạn là người phải biến chiếc hộp đó thành một ứng dụng chạy trên dữ liệu thật của họ.
HPE Private Cloud AI là ví dụ điển hình cho kiểu dự án này. HPE và NVIDIA cùng phát triển stack này và bán nó theo bốn cấu hình được định cỡ sẵn cho các loại workload AI khác nhau.
Các nhà phân tích của Constellation Research nhận xét rằng một stack trọn gói như vậy rất hấp dẫn với giới lãnh đạo doanh nghiệp. Họ cũng cảnh báo rằng giai đoạn đầu sẽ khó bùng nổ, vì phần lớn khách hàng vẫn đang ở mức thử nghiệm.
Khoảng cách giữa “mua rồi” và “dùng được” chính là chỗ FDE kiếm sống. Bạn có thể làm ở hãng phần cứng, ở một đối tác tích hợp, hay ở một startup AI có sản phẩm phải chạy trên hạ tầng tại chỗ của khách.
Dù ở vị trí nào, kỹ năng cần có vẫn giống nhau: nhìn vào một sản phẩm trọn gói và chỉ ra những quyết định nào khách vẫn phải tự đưa ra.
Trọn gói chỉ có nghĩa là các mảnh đã khớp nhau
Sản phẩm trọn gói giải quyết được một việc: các thành phần đã được kiểm tra để chạy cùng nhau. Nó không trả lời được dữ liệu của khách nằm ở đâu, đội nào được dùng bao nhiêu GPU, hay mô hình được phép đi vào mạng nội bộ bằng đường nào. Những câu đó chỉ khách mới trả lời được, và bạn là người phải hỏi.
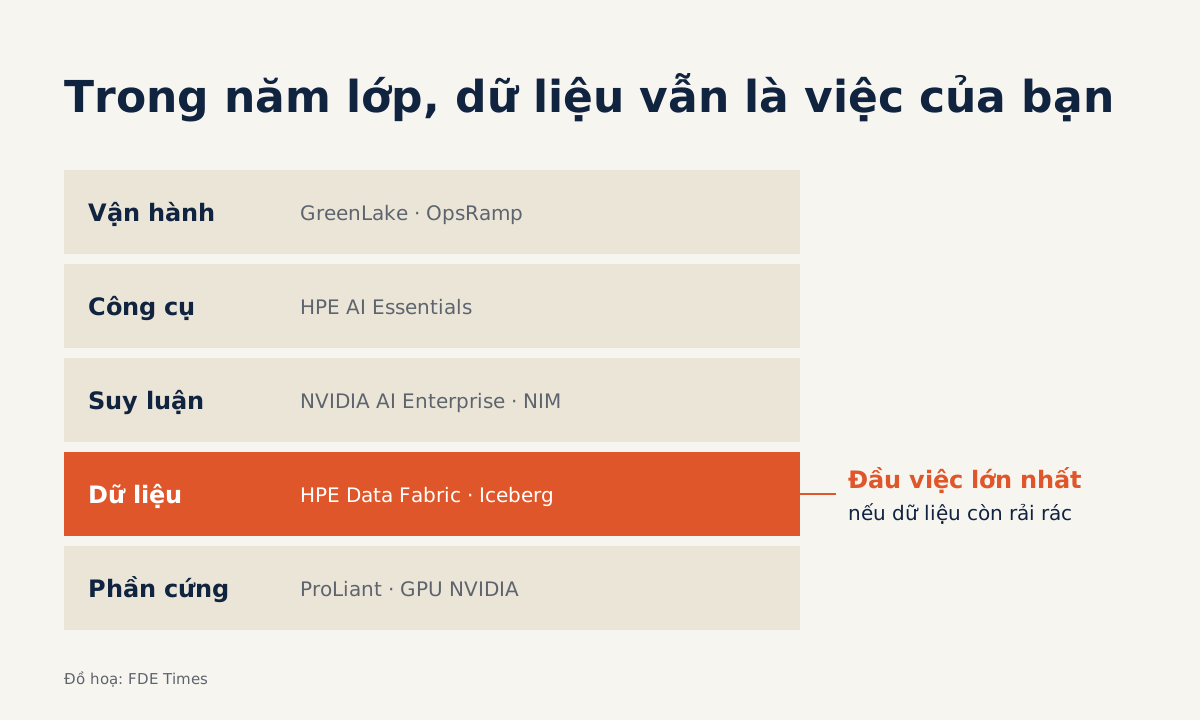
Muốn hỏi đúng, hãy tách stack ra thành từng lớp. Với HPE Private Cloud AI, lớp dưới cùng là máy chủ HPE ProLiant, hỗ trợ GPU NVIDIA L40S, H100 NVL và nền tảng GH200 NVL2.
Bên trên là NVIDIA AI Enterprise, trong đó có các microservice suy luận NIM. Tiếp theo là HPE AI Essentials, một bộ công cụ AI và dữ liệu được tuyển chọn sẵn, quản lý qua một control plane thống nhất.
Hai lớp còn lại dễ bị bỏ quên nhất. HPE Data Fabric là lớp dữ liệu, và từ bản phát hành tháng 3/2025 đã có thể làm Apache Iceberg endpoint cho công việc AI engineering. Việc vận hành đi qua HPE GreenLake, có thêm OpsRamp AI copilot hỗ trợ đội IT theo dõi hiệu quả workload.
Bản đồ năm lớp và câu hỏi đi kèm
Ở mỗi lớp trong bảng dưới đây, cột cuối là câu hỏi bạn nên mang vào buổi discovery.
| Lớp | Thành phần | Câu hỏi cho khách |
|---|---|---|
| Phần cứng | ProLiant, GPU L40S / H100 NVL / GH200 NVL2 | Workload chính là suy luận, tinh chỉnh hay cả hai? Đã chọn cấu hình nào trong bốn cấu hình? |
| Dữ liệu | HPE Data Fabric, Iceberg endpoint | Dữ liệu nguồn đã nằm trong lakehouse dạng Iceberg chưa, hay còn rải rác ở nhiều hệ thống? |
| Suy luận | NVIDIA AI Enterprise, NIM | Cần những mô hình nào, và mô hình được phép đưa vào mạng nội bộ bằng cách nào? |
| Công cụ | HPE AI Essentials, blueprint NVIDIA | Có blueprint dựng sẵn nào gần với use case không? |
| Vận hành | GreenLake, OpsRamp, air-gapped, multi-tenancy | Hệ thống có phải tách hẳn khỏi internet không? Bao nhiêu đội dùng chung? |
Thử hình dung: trợ lý tra cứu cho một ngân hàng
Đây là một kịch bản giả định. Một ngân hàng mua Private Cloud AI và muốn có trợ lý hỏi đáp trên tài liệu nội bộ. Hai đội sẽ dùng chung: đội quản lý rủi ro và đội chăm sóc khách hàng. Bộ phận bảo mật yêu cầu hệ thống không có đường ra internet.
Bạn bắt đầu từ ràng buộc cứng nhất. Bản phát hành tháng 6/2025 có chế độ quản trị air-gapped dành cho khách có yêu cầu nghiêm ngặt về quyền riêng tư dữ liệu.
Vì vậy kế hoạch phải liệt kê từ đầu những thứ thường được kéo từ bên ngoài, như trọng số mô hình, image của microservice hay bản cập nhật, rồi thống nhất với đội bảo mật của khách cách đưa từng thứ vào bên trong và ai là người ký duyệt.
Kế tiếp là điểm xuất phát. Nền tảng hỗ trợ các blueprint NVIDIA đã được kiểm định trước cho những workload phổ biến, nên bạn nên tìm một blueprint gần với bài toán hỏi đáp trên tài liệu thay vì tự dựng từ con số không. Blueprint giúp bạn có bản chạy được sớm. Thứ quyết định chất lượng vẫn là dữ liệu.
Ở lớp dữ liệu, giả sử tài liệu chính sách và biên bản rủi ro đã được ngân hàng đưa vào lakehouse dưới dạng bảng Iceberg. Data Fabric giờ có thể làm Iceberg endpoint, nên rất có thể bạn giảm bớt được việc sao chép dữ liệu sang chỗ khác. Đây là điều cần kiểm tra cùng đội dữ liệu của khách trước khi đưa vào kế hoạch.
Nếu dữ liệu còn nằm rải rác ở nhiều hệ thống, việc gom nó về một chỗ sẽ là đầu việc lớn nhất của dự án, và bạn nên báo điều đó cho khách ngay từ tuần đầu.
Cuối cùng là chia tài nguyên. Tính năng multi-tenancy cho phép doanh nghiệp phân vùng và cấp tài nguyên theo từng đội. Bạn cần thống nhất trước hạn mức cho mỗi đội và quy định đội chăm sóc khách hàng không được truy xuất biên bản rủi ro. Thiết kế sai từ đầu thì sau này sửa quyền truy cập trên một hệ thống đang chạy rất tốn công.
Làm theo thứ tự nào
Hãy đi từ ràng buộc đến tính năng. Đầu tiên chốt chính sách mạng (air-gapped hay không), tiếp theo chốt ranh giới giữa các tenant, sau đó mới đến chuyện chọn mô hình và blueprint. Đi ngược lại, bạn rất dễ dựng xong một bản demo đẹp rồi phát hiện nó không được phép kết nối với thứ nó cần.
Nếu khách còn đang thử nghiệm, đừng đẩy thẳng lên production. HPE có bản developer edition ra mắt tháng 3/2025, được định vị là điểm khởi đầu cho phát triển AI, đi kèm 32TB lưu trữ tích hợp.
Hãng cũng có chương trình dùng thử trước khi mua tại các trung tâm dữ liệu của Equinix. Dùng những lựa chọn này để kiểm chứng use case trước khi khách đặt cấu hình lớn.
Khi bàn chuyện mở rộng, nhớ rằng HPE cam kết nền tảng mở rộng được qua nhiều thế hệ GPU. Bạn vẫn nên ghi lại những phần của ứng dụng đang phụ thuộc vào một loại GPU cụ thể, để lần nâng cấp sau không trở thành một dự án mới.
Những lỗi hay gặp
Lỗi phổ biến nhất là tin vào chữ “trọn gói” và hứa ngày bàn giao trước khi biết dữ liệu đang nằm ở đâu. Lỗi thứ hai là chọn cấu hình GPU theo cảm tính, trong khi loại GPU quyết định cỡ hệ thống và workload nào chạy vừa.
Lỗi thứ ba là coi air-gapped như một ô đánh dấu, trong khi nó thay đổi cả quy trình cập nhật mô hình về sau. Lỗi thứ tư là để tất cả các đội dùng chung một vùng tài nguyên “cho nhanh”, rồi phải tách ra khi đã có người dùng thật.
Lỗi cuối cùng là bỏ qua lớp vận hành: nếu đội IT của khách không biết theo dõi hệ thống qua GreenLake, bạn sẽ là người bị gọi lúc nửa đêm.
Đưa kỹ năng này vào CV
Khi đọc mô tả công việc FDE, hãy để ý những từ như on-prem và air-gapped. Hai từ này gợi ý sản phẩm phải chạy trong hạ tầng của khách, có khi tách hẳn khỏi internet. Những từ như multi-tenant, NIM hay Iceberg thì cho bạn biết stack cụ thể mình sẽ phải làm việc cùng.
Trong CV, đừng ghi chung chung kiểu “triển khai giải pháp AI”. Hãy mô tả một ràng buộc cụ thể bạn đã xử lý, chẳng hạn đưa mô hình vào môi trường không có internet hoặc thiết kế hạn mức cho nhiều đội trên cùng một cụm GPU, và nói rõ bạn đã làm gì với nó.
Những khách hàng mua hộp AI đầu tiên thường chưa biết mình sẽ làm gì với nó. Người triển khai biết hỏi đúng năm câu ở năm lớp sẽ là người giúp họ trả lời câu hỏi đó.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
4 nguồn
- Hewlett Packard Enterprise and NVIDIA Announce Co-Developed AI Solutions · 2024-06-18
- HPE unveils Private Cloud AI, broad Nvidia partnership aimed at genAI workloads · 2024-06-18
- HPE, Nvidia broaden AI infrastructure lineup · 2025-03-19
- HPE Launches AI Factory Solutions Powered by Blackwell GPUs and Gen12 Servers · 2025-06-24