60 phút luyện vòng technical screen FDE: SQL, JSON và kiểm tra dữ liệu bằng Python
Cú pháp thì tra được. Cái bẫy thật sự là dữ liệu sai mà không hề báo lỗi, và sáu bài tập sau giúp bạn tập thói quen bắt được nó.

Tóm tắt nhanh
- Vòng screen FDE của Databricks kéo dài 45–60 phút, làm qua video và gồm nhiều câu hỏi ngắn, nên bạn phải viết các mẫu quen thuộc thật nhanh.
- COUNT(cột) bỏ qua NULL còn COUNT(*) đếm mọi dòng. Mọi phép kiểm tra chất lượng dữ liệu bằng SQL đều bắt đầu từ khác biệt này.
- json.loads không báo lỗi khi gặp khóa trùng hay NaN. Parse thành công chưa có nghĩa là dữ liệu đúng.
Ở Databricks, vòng technical screen cho vị trí forward deployed engineer chỉ kéo dài 45 đến 60 phút. Chừng đó thời gian được chia cho nhiều câu hỏi ngắn, và cả buổi diễn ra từ xa qua video. Với nhịp như vậy, bạn gần như không có thời gian tra cú pháp.
Hướng dẫn phỏng vấn của Aced đưa ra một câu SQL mẫu cho vòng này: viết truy vấn trả về những người dùng có nhiều hơn một giao dịch. Câu này dễ. Nhưng chính vì dễ, nó cho bạn cơ hội hỏi thêm về NULL, về bản ghi trùng và về định dạng dữ liệu đầu vào, thay vì gõ xong đáp án rồi dừng.
Bài này là một buổi luyện 60 phút gồm sáu bước. Bạn sẽ viết bốn mẫu SQL và một đoạn Python đọc JSON bẩn. Trên đường đi, bạn sẽ gặp hai lỗi mà module json của Python không hề báo.
Cần chuẩn bị gì trước khi bấm giờ?
Bạn cần Python 3 và một database hỗ trợ window function, chẳng hạn PostgreSQL. Tạo một bảng mẫu tên transactions với các cột user_id, txn_id, email, amount, created_at, rồi chèn khoảng hai chục dòng. Nhớ cố ý thêm vài dòng trùng txn_id và vài dòng có email là NULL.
Dữ liệu là tự bịa, nhưng phải bẩn có chủ đích. Bảng quá sạch thì chẳng dạy được gì cho vòng screen này, và cũng không giống dữ liệu bạn sẽ gặp khi đi làm.
Bước 1–2: đếm cho đúng rồi mới đếm cho nhanh
Bước 1 (10 phút). Giải câu hỏi mẫu của Databricks:
SELECT user_id, COUNT(*) AS n_txn
FROM transactions
GROUP BY user_id
HAVING COUNT(*) > 1;
Kiểm tra: đếm tay xem kết quả có khớp với số người dùng bạn cố ý cho nhiều giao dịch không. Sau đó tự hỏi: nếu cùng một txn_id bị ghi hai lần, người dùng đó có bị tính nhầm là “nhiều hơn một giao dịch” không? Có. Bước 3 sẽ xử lý chuyện này.
Bước 2 (10 phút). Đo tỷ lệ NULL. Tài liệu SQLite định nghĩa rõ: COUNT(X) chỉ đếm những dòng mà X khác NULL, còn COUNT(*) đếm mọi dòng trong nhóm. Lấy số thứ hai trừ số thứ nhất là ra số dòng thiếu dữ liệu.
SELECT COUNT(*)                AS total_rows,
       COUNT(email)            AS has_email,
       COUNT(*) - COUNT(email) AS missing_email
FROM transactions;
Thử hình dung bảng có 1.000 dòng và 940 dòng có email. Vậy 60 dòng thiếu email, tức 6%. Đừng dừng ở con số đó. Hãy nói thêm xem 6% này có làm hỏng phép tính nào ở các bước sau không.
Bước 3–4: khi nào cần đến window function?
Bước 3 (10 phút). Khử trùng lặp. Theo tài liệu PostgreSQL, ROW_NUMBER đánh số các dòng trong mỗi partition, bắt đầu từ 1. Bạn chia partition theo khóa nghiệp vụ, sắp xếp theo thời gian giảm dần, rồi giữ dòng số 1, tức bản ghi mới nhất.
WITH ranked AS (
  SELECT *,
         ROW_NUMBER() OVER (
           PARTITION BY txn_id
           ORDER BY created_at DESC
         ) AS rn
  FROM transactions
)
SELECT * FROM ranked WHERE rn = 1;
Kiểm tra: số dòng trả về phải bằng COUNT(DISTINCT txn_id) của bảng gốc. Sau đó chạy lại Bước 1 trên CTE này và đặt hai kết quả cạnh nhau. Người phỏng vấn sẽ thấy bạn tự kiểm chứng câu trả lời của chính mình.
Bước 4 (10 phút). Top-N theo nhóm. Điểm cần nắm là cách xử lý khi có đồng hạng. RANK để lại khoảng trống sau nhóm đồng hạng. DENSE_RANK thì không, vì nó đếm theo từng nhóm đồng hạng.
WITH ranked AS (
  SELECT user_id, txn_id, amount,
         RANK() OVER (
           PARTITION BY user_id ORDER BY amount DESC
         ) AS rnk,
         DENSE_RANK() OVER (
           PARTITION BY user_id ORDER BY amount DESC
         ) AS drnk
  FROM transactions
)
SELECT * FROM ranked WHERE rnk <= 2;
Với một người dùng có ba giao dịch, hai cột này cho kết quả như sau:
| amount | RANK | DENSE_RANK |
|---|---|---|
| 100 | 1 | 1 |
| 100 | 1 | 1 |
| 90 | 3 | 2 |
Giả sử câu hỏi là “lấy top 2 giao dịch lớn nhất của mỗi người dùng”. Lọc rnk <= 2 sẽ trả về hai dòng 100. Đổi thành drnk <= 2 thì trả về cả ba dòng. Không cách nào đúng tuyệt đối, nên câu trả lời tốt là hỏi lại người phỏng vấn muốn xử lý đồng hạng thế nào.
Bước 5: JSON bẩn không được làm sập vòng lặp
Theo tài liệu Python, json.loads nhận một str, bytes hoặc bytearray chứa tài liệu JSON và trả về đối tượng Python. Nếu dữ liệu không phải JSON hợp lệ, hàm ném JSONDecodeError, một lớp con của ValueError. Vì vậy, lần nào đọc dữ liệu từ bên ngoài cũng nên bọc trong try/except.
import json

lines = [
    '{"user_id": 1, "amount": 20.5}',
    '{"user_id": 2, "amount": NaN}',
    '{"user_id": 3, "user_id": 4, "amount": 5}',
    '{"user_id": 5, "amount": ',
]

good, bad = [], []
for i, line in enumerate(lines):
    try:
        good.append(json.loads(line))
    except json.JSONDecodeError as e:
        bad.append((i, str(e)))

print(len(good), len(bad))
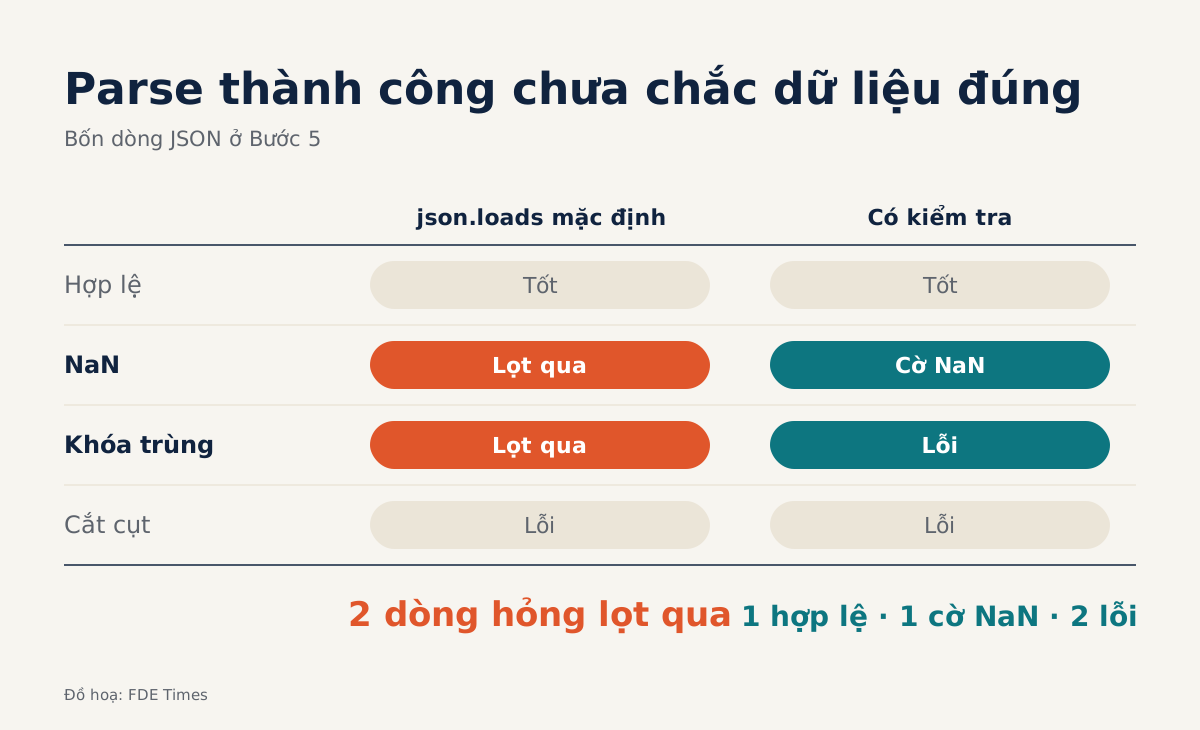
Kiểm tra: bạn sẽ thấy 3 dòng “tốt” và 1 dòng lỗi, chính là dòng bị cắt cụt ở cuối. Hãy giữ lại số dòng và thông báo lỗi, đừng pass cho qua. Khách hàng sẽ muốn biết chính xác dòng nào hỏng.
Bước 6: vì sao “3 dòng tốt” là con số sai?
In good ra xem. Dòng thứ hai có amount là nan. Lý do: theo tài liệu Python, module json mặc định chấp nhận Infinity, -Infinity và NaN như số JSON hợp lệ, dù chuẩn JSON không cho phép. Dòng thứ ba có user_id bằng 4, vì gặp khóa trùng thì module này không ném lỗi mà chỉ giữ cặp tên–giá trị cuối cùng.
Bắt NaN không cần thư viện nào thêm, vì NaN là giá trị duy nhất không bằng chính nó:
for rec in good:
    amt = rec.get("amount")
    if isinstance(amt, float) and amt != amt:
        print("NaN:", rec)
Khóa trùng khó bắt hơn, vì khi đã thành dict thì giá trị cũ mất rồi. Phiên bản dưới đây đã rút gọn, đủ để bạn dùng khi luyện tập:
def no_dup_keys(pairs):
    keys = [k for k, _ in pairs]
    if len(keys) != len(set(keys)):
        raise ValueError(f"khóa trùng: {keys}")
    return dict(pairs)

json.loads(line, object_pairs_hook=no_dup_keys)
Nếu đưa hook này vào vòng lặp ở Bước 5, hãy đổi except json.JSONDecodeError thành except ValueError. Vì JSONDecodeError là lớp con của ValueError, một khối except đó bắt được cả dòng bị cắt cụt lẫn dòng có khóa trùng. Chạy lại, bạn sẽ thấy 2 dòng tốt và 2 dòng lỗi, còn dòng NaN thì được bắt riêng bằng đoạn kiểm tra ở trên.
Những chỗ dễ trượt dù bạn biết làm
Một lỗi hay gặp là dùng COUNT(email) khi định đếm số dòng, hoặc ngược lại, rồi báo một con số sai mà không hề biết. Một lỗi khác là khử trùng lặp bằng DISTINCT trên mọi cột: hai bản ghi trùng txn_id thường lệch nhau ở created_at, nên DISTINCT không gộp được. Lỗi thứ ba là nuốt JSONDecodeError bằng một khối except trống.
Còn một rủi ro không nằm trong code: im lặng. Buổi phỏng vấn diễn ra qua video, nên người phỏng vấn chỉ biết bạn đang nghĩ gì khi bạn nói ra. Hãy nói giả định của mình trước khi gõ.
Ở chỗ khách hàng, đây là việc của tuần đầu
Sáu bước trên không chỉ để đi phỏng vấn. Khi khách hàng gửi file export đầu tiên, hãy làm ba việc trước khi dựng pipeline hay agent nào: chạy tỷ lệ NULL, đếm bản ghi trùng theo khóa nghiệp vụ, và đọc thử file JSON để lấy danh sách dòng lỗi.
Có trong tay ba con số đó, buổi họp đầu tiên với đội dữ liệu của khách sẽ xoay quanh dữ liệu thật thay vì phỏng đoán.
Khi viết CV, đừng ghi “thành thạo SQL”. Hãy viết một dòng cụ thể, chẳng hạn “phát hiện và loại bản ghi trùng theo mã giao dịch trước khi đưa dữ liệu vào báo cáo”, kèm con số thật từ dự án của bạn.
Cú pháp ROW_NUMBER tra một phút là ra. Thói quen nghi ngờ dữ liệu trước khi khách hàng nghi ngờ bạn thì phải luyện, và 60 phút này là để luyện nó.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!