Đừng sửa cột cũ: đổi schema của khách mà không dừng hệ thống
Chia một thay đổi phá vỡ thành nhiều lần deploy nhỏ, lùi lại được cho tới pha contract, và đừng bỏ bước dọn dẹp cuối.
Tóm tắt nhanh
- Đừng sửa thẳng cột đang dùng. Hãy thêm cấu trúc mới bên cạnh, ghi vào cả hai, rồi mới chuyển đường đọc.
- Mỗi bước là một lần deploy riêng, tương thích ngược với bước trước nên lùi lại được cho tới pha contract.
- Bỏ qua pha contract thì hệ thống có thể còn tệ hơn lúc chưa bắt đầu.
Thử hình dung bạn đang ở văn phòng của khách. Họ cần đẩy dữ liệu khách hàng sang một hệ thống mới, mà hệ thống ấy đòi họ và tên ở hai trường riêng. Bảng customers thì chỉ có một cột name, đang được đọc bởi app chính, một job báo cáo chạy mỗi đêm và một pipeline ETL do một đội khác giữ.
Cách làm ai cũng nghĩ ra đầu tiên là viết một migration: tách cột, đổi tên, sửa code, deploy một lần là xong. Nhưng trong lúc rolling deploy, các instance cũ của app vẫn đang chạy và vẫn tìm cột name. Job báo cáo đêm nay cũng chẳng biết gì về thay đổi của bạn.
Tình huống này đặc biệt khó với FDE. Bạn làm việc trên database của người khác, nơi bạn không biết hết ai đang đọc gì và không được phép bắt cả công ty dừng lại để chờ mình. Kỹ thuật cho tình huống này có tên là expand–contract.
Ý tưởng: đừng bao giờ đổi cái đang chạy
Martin Fowler gọi nó là parallel change: cách đưa một thay đổi phá vỡ tương thích ngược vào một interface mà vẫn an toàn. Schema database cũng là một interface, và mọi câu SQL đang chạy là client của nó.
Pattern có ba pha. Ở pha expand, bạn mở rộng interface để nó hỗ trợ cùng lúc cả bản cũ và bản mới. Ở pha migrate, bạn chuyển dần từng client đang dùng bản cũ sang bản mới. Ở pha contract, bạn gỡ bản cũ đi.
Pete Hodgson diễn đạt cái lợi rất rõ: thay vì một lần deploy rủi ro, bạn có một chuỗi deploy độc lập, và thay đổi nào trong chuỗi cũng giữ được tính tương thích.
Vì mỗi giai đoạn tương thích ngược với giai đoạn trước, các phần của hệ thống có thể đứng ở những giai đoạn khác nhau. App bản cũ và app bản mới chạy song song mà không làm nhau gãy.
Tách cột name qua từng lần deploy
Hướng dẫn của Prisma về expand–contract dùng đúng ví dụ này: khi cần tách name thành first_name và last_name, hãy thêm cả hai cột mới chứ đừng sửa cột name. Stripe, khi mô tả cách họ chạy migration trực tuyến ở quy mô lớn, chia việc thành bốn bước.
Họ ghi song song vào cấu trúc cũ và mới, chuyển mọi đường đọc sang cấu trúc mới, chỉ ghi vào cấu trúc mới, rồi xoá dữ liệu còn phụ thuộc vào mô hình cũ.
Áp vào bảng của khách, bước đầu tiên chỉ đụng tới schema:
-- Bước 1: expand. Chỉ thêm, không sửa, không xoá.
ALTER TABLE customers ADD COLUMN first_name text NULL;
ALTER TABLE customers ADD COLUMN last_name  text NULL;
Cột mới cho phép NULL nên app cũ vẫn insert được như thường. Nếu có gì bất ổn, bạn chỉ việc xoá hai cột vừa thêm, không ai bị ảnh hưởng.
Bước thứ hai sửa code ghi. Theo mô tả của Prisma, ở pha này client ghi vào cả cấu trúc gốc lẫn cấu trúc mới, còn đường đọc vẫn dùng cấu trúc gốc:
def save_customer(conn, cid, full_name, first, last):
    conn.execute(
        """UPDATE customers
           SET name = %s, first_name = %s, last_name = %s
           WHERE id = %s""",
        (full_name, first, last, cid),
    )
Dual write chỉ giữ cho các bản ghi mới đồng bộ. Hàng triệu dòng cũ vẫn có first_name rỗng. Stripe xử lý chỗ này bằng backfill: điền phần còn thiếu vào nơi lưu mới để hai bên giữ thông tin giống hệt nhau.
-- Bước 3 (deploy riêng hoặc một job riêng): backfill theo lô, lặp tới khi hết dòng
UPDATE customers
SET first_name = split_part(name, ' ', 1),
    last_name  = substr(name, length(split_part(name, ' ', 1)) + 2)
WHERE id IN (
  SELECT id FROM customers
  WHERE first_name IS NULL
  ORDER BY id LIMIT 5000
);
Câu SQL trên mặc định từ đầu tiên là tên, phần còn lại là họ. Với dữ liệu kiểu “Nguyễn Văn An”, quy tắc đó cho kết quả sai hoàn toàn. Đây không phải lỗi kỹ thuật mà là một quyết định nghiệp vụ, và người quyết định phải là khách, không phải bạn.
Kiểm tra trước khi chuyển đường đọc
Đường đọc là chỗ dễ sai nhất, vì lỗi ở đây hiện thẳng ra trước mắt người dùng. Stripe dùng thư viện Scientist của GitHub để kiểm chứng đường đọc trước khi chuyển. Bạn không cần đúng thư viện đó, chỉ cần giữ ý tưởng: đọc từ cả hai phía, so sánh, ghi log khi lệch nhau, nhưng vẫn trả kết quả từ phía cũ.
def display_name(row):
    old = row["name"]
    if row["first_name"] is None:
        return old  # dòng chưa backfill: chưa có gì để so, tránh log lệch giả
    new = f'{row["first_name"]} {row["last_name"] or ""}'.strip()
    if old != new:
        log.warning("name_mismatch", extra={"id": row["id"]})
    return old  # vẫn tin cấu trúc cũ cho tới khi log sạch
Cần nói thẳng giới hạn của hàm này. Ghép first_name với last_name gần như dựng lại đúng chuỗi gốc, nên nó không phát hiện được chuyện “Nguyễn” bị đặt nhầm vào ô tên. Nó chỉ bắt được lỗi kỹ thuật như mất ký tự, sai khoảng trắng hay dòng bị ghi đôi thiếu.
Để bắt lỗi nghiệp vụ, hãy so sánh với thứ khách đã duyệt: một mẫu vài trăm dòng mà người của khách tự tách họ và tên, hoặc quy tắc tách họ đã ký xác nhận. Lệch so với mẫu đó mới là tín hiệu rằng backfill đang sai nghĩa.
Chạy như vậy vài ngày trên traffic thật của khách. Khi log không còn lỗi lệch, hoặc mọi trường hợp lệch đều đã được giải thích, bạn mới deploy bản đọc từ first_name và last_name. Sau đó thêm một lần deploy nữa để chỉ ghi vào cột mới.
Bảng dưới đây là thứ nên dán vào tài liệu bàn giao cho khách. Nó cho biết ở từng bước, nếu phải lùi thì lùi thế nào:
| Bước | Ghi vào | Đọc từ | Cách lùi lại |
|---|---|---|---|
| 1. Expand | name |
name |
Xoá hai cột mới |
| 2. Dual write | cả hai | name |
Quay về code chỉ ghi name |
| 3. Backfill theo lô | cả hai | name |
Dừng job, dữ liệu cũ không bị đụng |
| 4. Đọc so sánh | cả hai | name, log khi lệch |
Tắt phần so sánh |
| 5. Chuyển đọc, rồi chỉ ghi cột mới | cả hai, sau đó cột mới | cột mới | Quay đường đọc về name khi còn ghi đôi |
| 6. Contract | cột mới | cột mới | Không còn đường lùi rẻ |
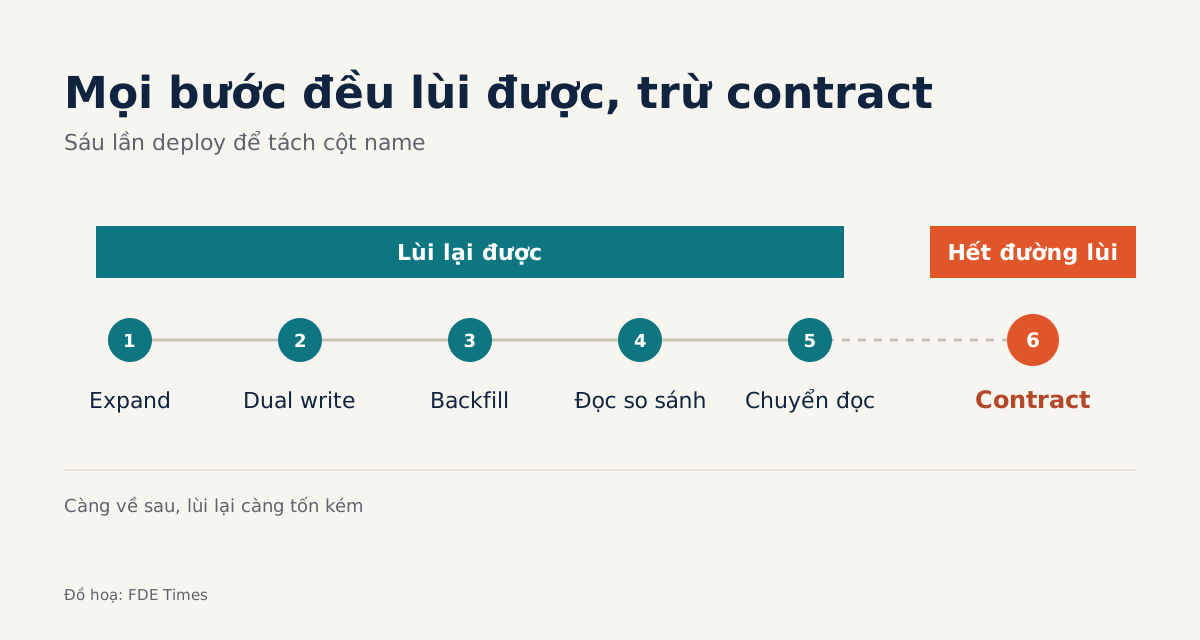
Càng xuống các bước sau, việc lùi lại càng tốn kém hơn, và tới bước contract thì gần như không còn đường lùi. Đó là lý do contract phải là bước sau cùng và cần được ký duyệt riêng.
Pha contract: bước hay bị quên nhất
Khi mọi thứ đã chạy ổn, cám dỗ lớn nhất là dừng ở đó. Fowler cảnh báo rằng nếu không làm pha contract, bạn có thể rơi vào trạng thái còn tệ hơn lúc bắt đầu. Hai cột song song, code ghi đôi, và một người kế nhiệm không biết nên tin cột nào.
-- Bước cuối: contract. Chỉ chạy khi không còn client nào đọc name.
ALTER TABLE customers DROP COLUMN name;
“Không còn client nào” là điều bạn phải chứng minh, không phải đoán. Ở môi trường của khách, hãy xem log truy vấn của database, hỏi đội giữ ETL, kiểm tra các dashboard. Job báo cáo đêm là thứ gãy đầu tiên vào sáng hôm sau.
Ở môi trường của khách, mọi thứ chậm hơn
Hodgson ước tính một đội deploy lên production bất cứ lúc nào, khi đã quen tay, có thể làm xong một vòng expand–contract trong một hai tiếng. Môi trường của khách thì hiếm khi như vậy: có thể có lịch release cố định, có change board, có đội khác giữ một nửa số client. Khi đó cả quy trình kéo dài hơn nhiều.
Vì thế, ngay buổi làm việc đầu tiên, hãy hỏi khách bao lâu thì được deploy một lần và ai duyệt. Câu trả lời quyết định bạn gói các bước thế nào. Nếu mỗi tháng chỉ có một cửa sổ release, có thể phải gộp expand và dual write vào cùng một đợt, nhưng tuyệt đối không gộp contract với bất kỳ bước nào.
Những lỗi hay gặp
Lỗi phổ biến nhất là ALTER COLUMN hoặc RENAME thẳng trên cột đang dùng, tức là bỏ hẳn pha expand. Lỗi thứ hai là backfill bằng một câu UPDATE duy nhất trên cả bảng, giữ khoá lâu và làm chậm chính hệ thống bạn đang cố không làm phiền. Lỗi thứ ba là chuyển đường đọc khi backfill chưa xong, khiến người dùng thấy tên rỗng.
Hai lỗi còn lại thường lộ ra muộn hơn. Một là quên những client không nằm trong repo của bạn. Hai là bỏ dở pha contract rồi rời dự án, để lại cho khách một schema khó hiểu hơn lúc bạn đến.
Về sự nghiệp, đây là kỹ năng nên ghi cụ thể trong CV. Thay vì “thực hiện migration database”, hãy viết rằng bạn đã đổi schema một bảng production của khách qua một chuỗi deploy tương thích ngược, có đọc so sánh và có kế hoạch lùi lại cho từng bước.
Khi phỏng vấn FDE hỏi về sự cố, đừng chỉ kể chuyện chữa cháy. Hãy chuẩn bị thêm một câu chuyện như thế này: bạn đã lên kế hoạch thế nào để thay đổi đi qua mà không cần dừng hệ thống, và mỗi bước lùi lại ra sao.
Bài tập cho tuần này: chọn một cột thật trong dự án bạn đang làm, viết kế hoạch theo đúng sáu bước của bảng trên, và đưa cho một đồng nghiệp đọc. Nếu họ không chỉ ra được ở bước nào thì hệ thống gãy, kế hoạch của bạn đã sẵn sàng để mang tới khách.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!