Data engineer sang FDE: khi dữ liệu thuộc về khách hàng
Ở công ty cũ, bạn quyết định schema. Ở chỗ khách hàng, schema đã có từ trước, và nó không quan tâm bạn thích gì.

Tóm tắt nhanh
- Dữ liệu của khách hàng không theo quy tắc của bạn, nên việc đầu tiên là tìm ra nó nằm ở đâu và vận hành theo luật gì.
- Pipeline cho khách hàng cần validation, retry và khả năng chạy tiếp khi một phần dữ liệu hỏng: nạp phần tốt, cách ly phần xấu, kèm lý do.
- Mapping và đối soát là việc vận hành lâu dài, và phần tốt nhất làm cho một khách hàng nên trở thành tính năng cho mọi khách hàng.
Thử hình dung tuần đầu tiên ở chỗ khách hàng. Bạn cần nạp dữ liệu hóa đơn nhà cung cấp, và bạn nhận được ba thứ cùng lúc: một bản export từ SAP, một file Excel phòng tài chính tự duy trì, và một thư mục PDF scan. Không có ai sở hữu schema, không có data contract, còn buổi demo cho ban giám đốc thì đã lên lịch.
Với một data engineer quen pipeline nội bộ, đây là cú sốc thật. Ở công ty cũ, bạn kiểm soát nguồn, kiểm soát định dạng, và nếu dữ liệu sai thì có ticket gửi cho team upstream. Ở đây thì không có upstream nào để đổ lỗi, vì upstream chính là khách hàng.
Tin vui là phần lớn kỹ năng của bạn vẫn dùng được. Chỉ có thứ tự ưu tiên thay đổi, và các tin tuyển FDE mô tả sự thay đổi đó rõ đến bất ngờ.
Việc đầu tiên là đi tìm dữ liệu, chưa phải viết pipeline
Tin tuyển FDE của Valdera viết rằng mỗi khách hàng một khác: dữ liệu nằm ở những hệ thống khác nhau, mang hình dạng khác nhau và chịu những luật lệ khác nhau. Hệ thống họ cần tích hợp là ERP, hệ thống mua hàng và tài chính của khách như SAP, Oracle, Coupa, Ariba. Đó không phải một data lake do team bạn quản lý.
Rowspace còn đi xa hơn. FDE của họ làm việc sau khi hợp đồng đã ký, ngồi cùng khách hàng, xây integration và pipeline ngay trên dữ liệu của khách, trong môi trường của khách.
Họ muốn người không ngại PDF, mô hình Excel và định dạng thiếu nhất quán. Vori, khi tuyển Forward Deployed Data Engineer, kể ra dải đầu vào từ CSV, EDI đến PDF, thậm chí giấy scan.
Vì thế, câu hỏi đầu tiên không phải “nên dùng Airflow hay dbt”. Bạn cần biết dữ liệu nằm ở đâu, ai đang sửa nó, và có những luật nghiệp vụ nào chưa ai ghi lại. Ví dụ, mã nhà cung cấp trong Excel có thể là mã cũ trước đợt chuyển SAP.
Pipeline nội bộ
- Bạn định nghĩa schema
- Dữ liệu hỏng thì job dừng và mở ticket
- Thiết kế kỹ trước, chạy sau
- Migration xong là xong
Dữ liệu của khách hàng
- Schema có sẵn và thường lệch nhau
- Nạp phần tốt, cách ly phần hỏng, báo lý do
- Prototype nhanh, gia cố phần thực sự được dùng
- Mapping và đối soát phải duy trì liên tục
Dữ liệu hỏng không được làm sập cả lần chạy
Valdera viết thẳng điều FDE phải xử lý: định dạng lộn xộn, schema không khớp, và mọi thứ cần validation, retry và graceful degradation. Ba từ đó chính là khác biệt lớn nhất so với thói quen nội bộ.
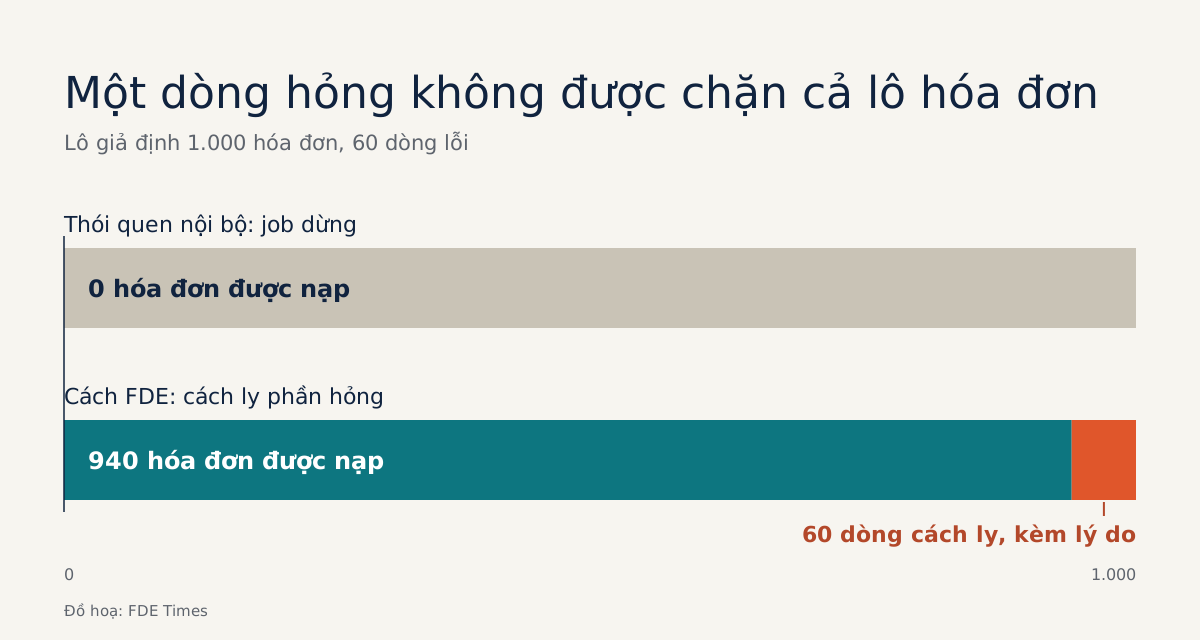
Thử làm phép tính. Giả sử lô đầu có 1.000 hóa đơn, trong đó 60 dòng thiếu mã nhà cung cấp hoặc có số tiền ghi kiểu “1.250,00” thay vì “1250.00”.
Theo thói quen nội bộ, assertion fail, job dừng và 0 hóa đơn được nạp. Buổi demo không có gì để chiếu. Theo cách của FDE, 940 dòng được nạp, 60 dòng vào vùng cách ly, mỗi dòng kèm lý do cụ thể để gửi cho phòng tài chính.
Đoạn code dưới đây là khung tối thiểu cho hai nguồn dạng bảng trong kịch bản trên: bản export SAP và file Excel của phòng tài chính, sau khi đã đọc thành từng dòng. Mỗi nguồn có một mapping riêng nằm ở cấu hình chứ không bị viết cứng vào code. Đó cũng là chỗ bạn sẽ sửa nhiều nhất trong những tuần đầu.
REQUIRED = ["vendor_id", "invoice_no", "amount", "currency"]

# One mapping per source; this is config, not code
SAP_MAPPING = {"vendor_id": "LIFNR", "invoice_no": "BELNR",
               "amount": "WRBTR", "currency": "WAERS"}

# Finance team's Excel: same targets, different column names
EXCEL_MAPPING = {"vendor_id": "Supplier Code", "invoice_no": "Invoice #",
                 "amount": "Total", "currency": "Curr"}

def normalize(row: dict, mapping: dict) -> dict:
    out = {target: row.get(src) for target, src in mapping.items()}
    amt = out.get("amount")
    if isinstance(amt, str):
        amt = amt.strip()
        if "," in amt and amt.rfind(",") > amt.rfind("."):
            amt = amt.replace(".", "").replace(",", ".")  # 1.250,00 -> 1250.00
        out["amount"] = amt.replace(",", "")
    return out

def validate(row: dict) -> list[str]:
    errors = [f"missing {f}" for f in REQUIRED if not row.get(f)]
    try:
        float(row.get("amount") or "x")
    except ValueError:
        errors.append(f"amount not numeric: {row.get('amount')!r}")
    return errors

def ingest(rows, mapping):
    good, quarantine = [], []
    for raw in rows:
        row = normalize(raw, mapping)
        errs = validate(row)
        if errs:
            quarantine.append({"raw": raw, "errors": errs})
        else:
            good.append(row)
    return good, quarantine

# Same function, two sources
sap_good, sap_bad = ingest(sap_rows, SAP_MAPPING)
xls_good, xls_bad = ingest(excel_rows, EXCEL_MAPPING)
Thư mục PDF scan không nằm trong khung này. Nó cần một bước trích xuất riêng để biến trang giấy thành từng dòng dữ liệu trước, rồi mới đi qua cùng hàm ingest với một mapping thứ ba. Điểm đáng giữ là cửa vào chung: nguồn nào cũng phải qua cùng một lớp validate và cách ly.
Retry thuộc về tầng gọi hệ thống, chẳng hạn khi API của ERP thỉnh thoảng timeout. Bạn bọc lời gọi đó bằng backoff và giới hạn số lần thử. Còn vùng cách ly thuộc về tầng dữ liệu. Đừng trộn hai thứ: retry một dòng sai định dạng mười lần cũng không làm nó đúng ra.
Prototype trước, gia cố sau, đối soát mãi mãi
Valdera mô tả nhịp làm việc là prototype thật nhanh, rồi gia cố phần nào thực sự được dùng thành giải pháp đủ vững để chạy production. Paraform xếp việc xây integration và pipeline tùy biến theo tiến độ do deployment quyết định vào nhóm trách nhiệm cốt lõi của FDE.
Với người quen thiết kế kỹ rồi mới chạy, nhịp này ban đầu sẽ thấy cẩu thả. Thật ra nó chỉ đảo thứ tự: bạn học luật của dữ liệu bằng cách chạy trên dữ liệu thật.
Lý do nằm ở chỗ demo không phản ánh thực tế. Bài hướng dẫn của Stackmatix cho rằng dữ liệu khách hàng lộn xộn, và pipeline thật đầy những edge case không bản demo nào cho thấy. Cũng theo bài đó, việc đánh giá diễn ra trong production: chưa chạy trên hệ thống thật thì chưa chứng minh được gì.
Sau khi gia cố, việc vẫn chưa kết thúc. Vori coi việc cấu hình và duy trì data mapping cùng đối soát là một phần của team vận hành, không phải một dự án migration làm một lần. Khách hàng đổi mã nhà cung cấp, phòng tài chính thêm một cột vào Excel, mapping của bạn phải theo kịp.
Rowspace thêm một vòng nữa: phần tốt nhất bạn làm cho một khách hàng nên trở thành tính năng cho tất cả. Hàm normalize có cấu hình mapping ở trên chính là mầm của một tính năng như thế.
Tự làm: năm bước cho nguồn dữ liệu mới
Khi gặp một nguồn dữ liệu lạ, hãy đi theo đúng thứ tự dưới đây.
Bước 1: Discovery. Viết một trang ghi rõ hệ thống nào giữ dữ liệu, ai sở hữu, định dạng gì, và những luật nghiệp vụ mà người dùng chỉ kể miệng.
Bước 2: Đo trước khi transform. Lấy một mẫu thật và đếm số dòng lỗi theo từng loại trước khi viết bất kỳ transform nào.
Bước 3: Prototype có vùng cách ly. Dựng bản prototype tách phần hợp lệ và phần cách ly ngay từ đầu, để có thứ chiếu cho khách trong vài ngày.
Bước 4: Đưa danh sách cách ly cho người sở hữu nghiệp vụ. Họ sửa được ở nguồn những lỗi mà bạn không đoán ra.
Bước 5: Gia cố và đóng gói mapping. Chỉ gia cố những đường đi khách hàng thực sự dùng, và đưa mapping vào cấu hình để lần sau tái sử dụng.
Những lỗi người chuyển nghề hay mắc
Lỗi phổ biến nhất là coi một dòng hỏng là lỗi của cả job, như cách giữ chất lượng ở công ty cũ. Lỗi thứ hai là đoán luật nghiệp vụ thay vì hỏi. Một cột “status” bỏ trống có thể có nghĩa là “đã thanh toán” trong quy trình của riêng phòng đó.
Lỗi thứ ba là dồn sức thiết kế kiến trúc đẹp trước khi chạm vào dữ liệu thật. Lỗi thứ tư thuộc về con người. Vori ghi rõ trong yêu cầu rằng ứng viên cần sự thấu cảm với khách hàng và giữ được bình tĩnh khi xử lý sự cố trong môi trường lộn xộn, áp lực cao.
Palantir, công ty khai sinh vai trò này, mô tả FDE thường làm việc trực tiếp tại chỗ khách hàng. Ở đó, cách bạn giải thích 60 dòng bị cách ly quan trọng không kém đoạn code tách chúng ra.
Biến kinh nghiệm cũ thành hồ sơ FDE
Palantir đưa việc xử lý dữ liệu quy mô cực lớn vào mô tả một ngày làm việc của FDE. Nghĩa là nền tảng data engineering là lợi thế thật, không phải thứ phải che đi. Paraform dẫn tin của Financial Times rằng số tin tuyển FDE tăng hơn 800% từ tháng 1 đến tháng 9/2025, nên nhu cầu cho đúng kỹ năng này đang có.
Nhưng CV phải nói đúng ngôn ngữ của vai trò. Thay vì “xây pipeline Spark xử lý 2 TB/ngày”, hãy kể một lần bạn tích hợp nguồn dữ liệu không do mình kiểm soát, bạn đã cách ly lỗi ra sao và đã ngồi với ai để làm rõ luật nghiệp vụ.
Lấy chính kịch bản 1.000 hóa đơn ở trên làm ví dụ giả định. Dòng CV kiểu cũ sẽ là: “Xây pipeline ETL nạp dữ liệu hóa đơn vào kho dữ liệu.” Câu đó đúng, nhưng nhà tuyển dụng FDE không thấy khách hàng, không thấy dữ liệu bẩn, cũng không thấy kết quả.
Viết lại theo ngôn ngữ FDE: “Tích hợp dữ liệu hóa đơn từ SAP và file Excel do phòng tài chính của khách quản lý; thiết kế vùng cách ly để nạp 940/1.000 dòng ngay lần chạy đầu, gửi 60 dòng lỗi kèm lý do cho phòng tài chính sửa tại nguồn; đóng gói mapping thành cấu hình dùng lại cho nguồn thứ hai.”
Dòng thứ hai gói đủ ba tín hiệu: dữ liệu không do bạn kiểm soát, graceful degradation có con số, và một thứ dùng lại được. Hãy viết theo khung đó cho dự án thật của bạn, với số liệu thật. Khi đọc tin tuyển, tìm các cụm như “messy data”, “reconciliation”, “post-sale”, “on site”: chúng cho biết bạn sẽ dành bao nhiêu thời gian bên khách hàng.
Pipeline nội bộ dạy bạn làm cho dữ liệu đúng. Dữ liệu của khách hàng dạy bạn làm cho hệ thống vẫn có ích khi dữ liệu chưa đúng, và đó mới là kỹ năng người ta trả tiền để mang đến tận nơi.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
6 nguồn
- Valdera - Forward Deployed Engineer
- Forward Deployed Engineer (Rowspace)
- Forward Deployed Data Engineer (Vori, San Francisco, CA)
- Palantir Technologies - Forward Deployed Software Engineer
- What Is a Forward Deployed Engineer? GTM Guide for Startups · 2026-09-03
- What is a forward deployed engineer? A complete guide · 2026-09-03