Thực hành: chọn ngưỡng cho model theo giá của từng lỗi, bỏ thói quen dùng 0.5
Trong ví dụ về tín dụng của scikit-learn, giữ nguyên model và chỉ dời ngưỡng quyết định đã giúp lợi ích kinh doanh tốt lên gần gấp đôi.
Tóm tắt nhanh
- Chọn precision hay recall thực chất là chọn loại lỗi mà model được tối ưu để tránh, nên câu trả lời nằm ở chi phí của khách.
- Ngưỡng 0.5 mặc định nhiều khả năng không tối ưu cho bài toán thật. Trong ví dụ của scikit-learn, chỉnh ngưỡng theo chi phí đưa lợi ích từ -209 lên -143.
- AUC dùng để so sánh model vì nó tính trên mọi ngưỡng. Muốn ra quyết định thì phải chọn một ngưỡng, và ngưỡng đó phải được chỉnh trên dữ liệu không dùng để train.
Trong một ví dụ về chấm điểm tín dụng, tài liệu scikit-learn giữ nguyên model và chỉ đổi đúng một con số là ngưỡng quyết định. Lợi ích kinh doanh từ -209 lên -143, tức tốt hơn gần gấp đôi. Không có feature mới, không train lại.
Nếu muốn làm FDE, đây là kỹ năng đáng luyện trước khi ra gặp khách. Data scientist thường báo cáo bằng AUC hoặc accuracy. Còn khách muốn biết model đúng là bao nhiêu thì vừa, và mỗi lần sai họ mất bao nhiêu tiền hay bao nhiêu giờ công. Bài này đi qua từng bước để bạn trả lời được câu hỏi đó bằng code, trên laptop của mình.
Bạn sẽ làm gì: viết một hàm chi phí, quét ngưỡng trên tập validation, chọn ngưỡng tốt nhất rồi kiểm tra trên tập test. Cần có: Python 3 và một model phân loại nhị phân bất kỳ có xuất điểm xác suất. Code bên dưới cố ý viết bằng Python thuần, không gọi thư viện, để bạn thấy rõ từng phép tính. Đây là bản đơn giản hóa phục vụ việc học.
Bạn đang chọn metric, hay đang chọn loại lỗi?
Hai định nghĩa cần nhớ: precision là tỷ lệ dự đoán dương mà thật sự dương, còn recall là tỷ lệ ca dương thật mà model bắt được. Từ điển data science của Domino chỉ ra điểm hay bị bỏ qua: ưu tiên precision hay recall sẽ thay đổi loại lỗi mà model được tối ưu để tránh.
Google ML Crash Course có một quy tắc dễ dùng. Ưu tiên recall khi false negative đắt hơn false positive. Ưu tiên precision khi dự đoán dương nhất định phải đúng. Với dữ liệu mất cân bằng thì không dùng accuracy.
Vì sao không dùng accuracy? Thử hình dung 1.000 hồ sơ vay, trong đó 100 hồ sơ là khách xấu. Một model “lười” đoán tất cả đều là khách tốt sẽ đạt accuracy 90% nhưng không bắt được khách xấu nào. Đó là lý do bước đầu tiên phải nói chuyện với khách, chưa phải viết code.
Bước 1: lấy giá của từng lỗi từ miệng khách
Trong ví dụ của scikit-learn, định nghĩa “dương” là khách xấu. Cho vay nhầm một khách xấu (false negative) tốn trung bình gấp năm lần so với từ chối nhầm một khách tốt (false positive). Ma trận lợi ích vì thế cho -1 điểm với mỗi FP và -5 điểm với mỗi FN.
COST_FP = 1   # từ chối nhầm khách tốt
COST_FN = 5   # cho vay nhầm khách xấu

def business_cost(tp, fp, tn, fn):
    return COST_FP * fp + COST_FN * fn
Kiểm tra: khách có đồng ý với tỷ lệ 1:5 không? Con số không cần chính xác tuyệt đối, nhưng phải do người nắm nghiệp vụ đưa ra. Kỹ sư không nên tự đoán.
Bước 2: biến điểm số thành nhãn
Model trả về xác suất. Muốn có nhãn thì phải chọn một xác suất làm mốc, gọi là classification threshold. Google lưu ý rằng mỗi ngưỡng khác nhau thường cho ra số TP, FP, TN, FN khác nhau.
def confusion_at(y_true, y_score, threshold):
    tp = fp = tn = fn = 0
    for y, s in zip(y_true, y_score):
        pred = 1 if s >= threshold else 0
        if pred == 1 and y == 1: tp += 1
        elif pred == 1 and y == 0: fp += 1
        elif pred == 0 and y == 0: tn += 1
        else: fn += 1
    return tp, fp, tn, fn
Kiểm tra: tổng tp + fp + tn + fn phải bằng số mẫu. Nếu lệch thì nhãn của bạn đang có giá trị khác 0 và 1.
Bước 3: quét ngưỡng thay vì tin vào 0.5
Tài liệu scikit-learn nói thẳng rằng chiến lược mặc định (ngưỡng 0.5) nhiều khả năng không tối ưu cho bài toán đang làm. Ngưỡng tối ưu là ngưỡng làm metric bạn chọn đạt giá trị tốt nhất. Ở đây metric đó là chi phí kinh doanh.
def sweep(y_true, y_score):
    rows = []
    for i in range(5, 96, 5):
        t = i / 100
        tp, fp, tn, fn = confusion_at(y_true, y_score, t)
        precision = tp / (tp + fp) if tp + fp else 0.0
        recall = tp / (tp + fn) if tp + fn else 0.0
        rows.append((t, business_cost(tp, fp, tn, fn), precision, recall))
    return sorted(rows, key=lambda r: r[1])
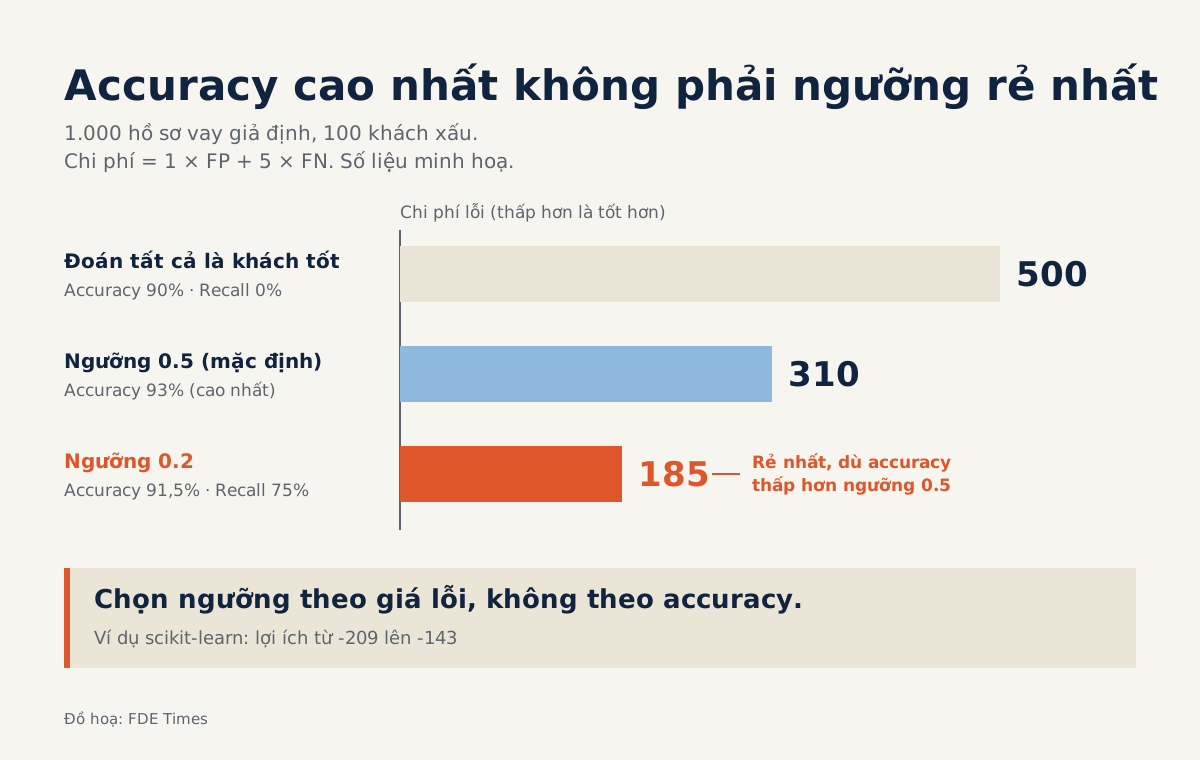
Để thấy kết quả trông thế nào, quay lại 1.000 hồ sơ giả định ở trên. Các con số trong bảng là ví dụ minh họa, không phải số đo thật.
| Cách phân loại | TP / FP / FN | Precision | Recall | Accuracy | Chi phí |
|---|---|---|---|---|---|
| Đoán tất cả là khách tốt | 0 / 0 / 100 | — | 0% | 90% | 500 |
| Ngưỡng 0.5 | 40 / 10 / 60 | 80% | 40% | 93% | 310 |
| Ngưỡng 0.2 | 75 / 60 / 25 | 55,6% | 75% | 91,5% | 185 |
Chi tiết đáng chú ý: từ 0.5 xuống 0.2, accuracy giảm còn chi phí giảm mạnh. Recall tăng, precision giảm. Đó cũng là kiểu đánh đổi scikit-learn ghi nhận khi chỉnh ngưỡng trong ví dụ tín dụng. Nếu bạn báo cáo bằng accuracy, bạn sẽ chọn sai ngưỡng.
Bước 4: đừng chỉnh ngưỡng trên dữ liệu đã dùng để train
Hướng dẫn của scikit-learn yêu cầu không bao giờ dùng cùng một tập dữ liệu để train classifier và để chỉnh ngưỡng, vì sẽ bị overfit. Trên tập train, model tự tin hơn thực tế, nên ngưỡng tìm được ở đó sẽ quá lạc quan.
Cách làm an toàn là chia dữ liệu thành ba phần: train để fit model, validation để chạy sweep, và test để đo chi phí lần cuối tại ngưỡng đã chọn. Nếu chi phí trên test cao hơn hẳn trên validation, ngưỡng của bạn đang bám vào nhiễu.
Kiểm tra: chạy confusion_at trên tập test với ngưỡng đã chọn rồi tính business_cost. Ghi con số này vào báo cáo, không ghi con số của tập validation.
Vậy AUC dùng vào việc gì?
AUC và đường ROC cho thấy model phân biệt hai lớp tốt đến đâu trên mọi ngưỡng có thể. Chính vì thế AUC không cho bạn biết nên đặt ngưỡng ở đâu. AUC hợp để so sánh hai model trước khi chọn ngưỡng, nhưng không thay thế được con số chi phí tại ngưỡng sẽ chạy thật.
Ở chỗ khách, kỹ năng này trông như thế nào?
Thử hình dung bạn deploy một model phát hiện giao dịch đáng ngờ cho một ngân hàng. Bên vận hành sẽ phàn nàn vì quá nhiều cảnh báo nhầm. Bên quản trị rủi ro thì lo vì bỏ sót. Cả hai đều đúng, và tranh cãi chỉ dừng lại khi có một con số chung là chi phí mỗi loại lỗi.
Việc đầu tiên nên làm là ngồi với cả hai bên và hỏi: bỏ sót một ca thì tốn gấp mấy lần so với báo nhầm một ca? Sau đó chạy sweep, đưa họ xem bảng giống bảng ở trên và để họ chọn dòng phù hợp. Ngưỡng lúc này là quyết định kinh doanh có căn cứ, không còn là tham số kỹ thuật bị giấu trong code.
Với CV và phỏng vấn, đừng chỉ viết “đạt AUC 0.9”. Hãy viết rằng bạn đã chuyển yêu cầu của khách thành hàm chi phí, chọn ngưỡng trên tập validation riêng và giảm được chi phí lỗi bao nhiêu phần trăm so với ngưỡng mặc định.
Khi đọc JD, nếu gặp yêu cầu kiểu chuyển nhu cầu kinh doanh thành metric, bạn có thể dùng chính ví dụ này để chứng minh mình làm được.
Model tốt nhất trong notebook vẫn có thể là model gây tốn kém nhất ngoài đời nếu ngưỡng đặt sai. Người kỹ sư chịu hỏi khách “lỗi nào đắt hơn” trước khi chạy code thường là người được mời quay lại.
5 nguồn
- What is Model Evaluation (Domino Data Science Dictionary)
- Thresholds and the confusion matrix (Google ML Crash Course) · 2026-01-12
- Accuracy, precision, and recall (Google ML Crash Course) · 2026-01-12
- Post-tuning the decision threshold for cost-sensitive learning (scikit-learn)
- Tuning the decision threshold for class prediction (scikit-learn User Guide)