Theo dõi agent trong production bằng bốn con số: tỷ lệ hoàn thành, lỗi tool, số bước và tỷ lệ chuyển cho người
Dashboard hạ tầng xanh hết mà khách hàng vẫn phàn nàn agent làm hỏng việc, vì bạn đang đo máy chạy chứ chưa đo việc có xong hay không.
Tóm tắt nhanh
- Latency và error rate của hạ tầng chỉ cho biết máy có chạy, chưa cho biết task có xong; tầng kết quả mới là tín hiệu chất lượng chính.
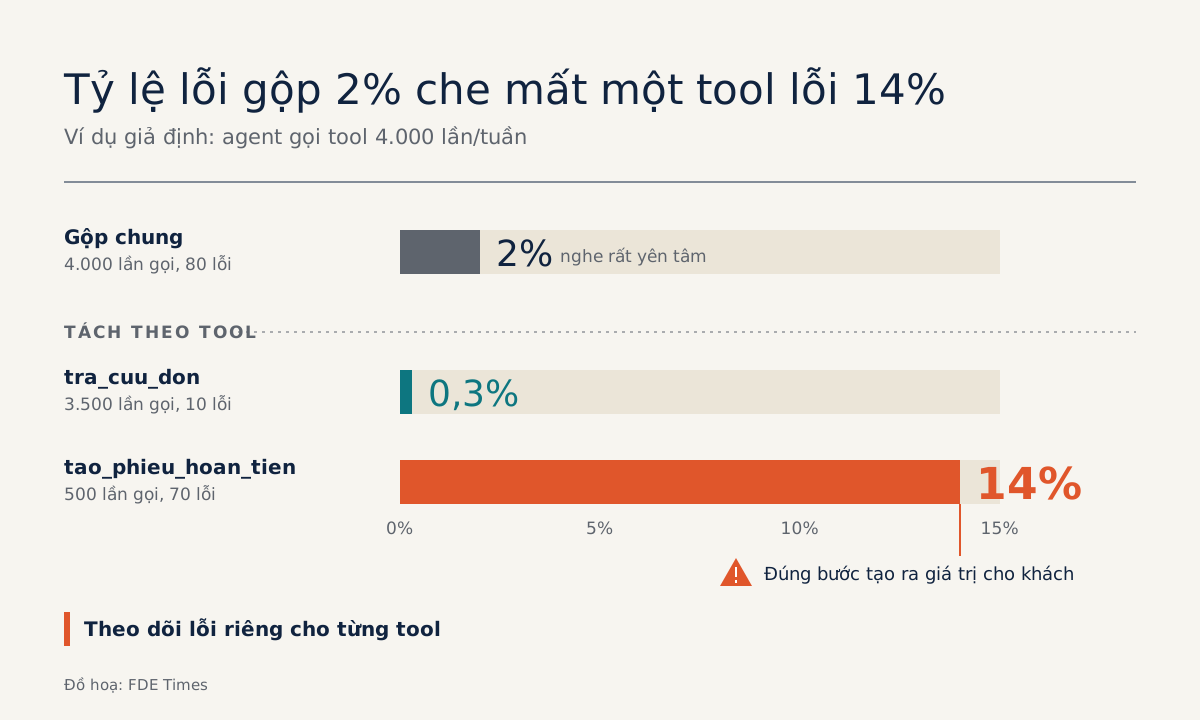
- Tỷ lệ lỗi tool phải tách theo từng tool: con số chung 2% có thể đang giấu một tool lỗi 14%.
- Số bước vượt xa mức thường là dấu hiệu agent lặp vòng; tỷ lệ chuyển cho người cần đọc kèm lý do chuyển.
Agent xử lý yêu cầu hoàn tiền đã chạy ở chỗ khách hàng được hai tuần. Dashboard toàn màu xanh: latency ổn định, server không báo lỗi, throughput đều. Vậy mà sáng thứ Hai, trưởng nhóm chăm sóc khách hàng gọi cho bạn: “Nhân viên của tôi đang phải làm lại một nửa số phiếu agent tạo ra.”
Tình huống này gần như chắc chắn sẽ đến với một FDE. Hệ thống không sập, nó chỉ làm sai việc một cách rất êm. Những gì bạn đang theo dõi là máy có chạy hay không, còn câu khách hỏi là việc có xong hay không.
Bài này dạy cách trả lời câu hỏi thứ hai bằng bốn con số: tỷ lệ hoàn thành, lỗi tool, số bước và tỷ lệ chuyển cho người. Bốn con số này đo được ngay từ tuần đầu deployment, và chúng biến những cuộc gọi phàn nàn mơ hồ thành một danh sách việc cần sửa.
Máy chạy tốt chưa có nghĩa là việc được làm xong
New Relic chia việc giám sát agent thành ba góc nhìn. Tầng vận hành gồm latency, lỗi, throughput và sức khỏe của các dependency, tức những gì dashboard hạ tầng đã có sẵn. Tầng hành vi gồm prompt, phản hồi của model, tool call, retry, lượng token và các lần handoff. Tầng kết quả gồm tỷ lệ hoàn thành task, số lần con người phải sửa và tỷ lệ escalation.
Agent hoàn tiền ở trên đạt điểm tuyệt đối ở tầng một và hỏng ở tầng ba. Blaxel coi tỷ lệ hoàn thành task là tín hiệu chất lượng chính, và mô tả rất thẳng: khi tỷ lệ này rơi từ 85% xuống 60%, bạn biết có thứ gì đó đã hỏng, dù hạ tầng vẫn bình thường.
Con số gộp chung là cái bẫy quen thuộc
Ai học machine learning đều từng gặp bẫy accuracy. Google ML Crash Course đưa ví dụ: trên dữ liệu mất cân bằng, một model lúc nào cũng đoán “âm tính” vẫn đạt 99% accuracy mà chẳng dùng được vào việc gì. Lời khuyên của Google là tránh dùng accuracy cho dữ liệu mất cân bằng và chọn thêm chỉ số khác.
Tỷ lệ lỗi tool gộp chung mắc đúng bệnh này, vì lượng tool call cũng mất cân bằng giữa các tool. Thử hình dung trong một tuần agent gọi tool 4.000 lần: tool tra_cuu_don chiếm 3.500 lần và lỗi 10 lần, tool tao_phieu_hoan_tien chỉ có 500 lần nhưng lỗi 70 lần. Gộp lại là 80 lỗi trên 4.000 lần gọi, tức 2%, nghe rất yên tâm.
Tách ra thì khác hẳn. Tool tra cứu lỗi khoảng 0,3%, còn tool tạo phiếu lỗi 14%, và đó lại đúng là bước tạo ra giá trị cho khách hàng. Vì thế Blaxel khuyên theo dõi tỷ lệ thành công của tool call cho từng tool trong hệ thống, đừng chỉ nhìn con số chung.
Mỗi run một bản ghi JSON
Muốn tách số theo tool, theo loại task, theo lý do chuyển cho người, bạn cần dữ liệu có cấu trúc ngay từ lúc ghi. Cloud Logging gọi đó là log có cấu trúc: payload là một object JSON nằm trong trường jsonPayload. Lợi ích là bạn truy vấn được theo từng đường dẫn JSON và đánh chỉ mục từng trường cụ thể.
Với agent hoàn tiền, một bản ghi cho mỗi run có thể trông như sau:
{
  "run_id": "r-8812",
  "task_type": "hoan_tien",
  "outcome": "escalated",
  "escalation_reason": "tool_error",
  "steps": 7,
  "tool_calls": [
    {"tool": "tra_cuu_don", "ok": true, "latency_ms": 320},
    {"tool": "tao_phieu_hoan_tien", "ok": false, "error": "timeout"}
  ],
  "tokens": 5400
}
Chỉ với bản ghi này, bạn đã có đủ dữ liệu cho cả bốn con số. outcome cho tỷ lệ hoàn thành và tỷ lệ chuyển cho người, tool_calls[].ok cho lỗi theo tool, steps cho số bước. Trên Cloud Logging, một truy vấn như jsonPayload.outcome="escalated" lọc ra mọi run bị chuyển cho người, sau đó bạn nhóm tiếp theo escalation_reason.
Nếu khách hàng đã có stack quan sát riêng, đừng ép họ dùng thêm một công cụ mới. OpenTelemetry là giao thức mở để gửi log, metric và trace từ hệ thống production, nên bạn không bị khóa vào một nhà cung cấp.
OpenLLMetry là dự án mã nguồn mở mở rộng OpenTelemetry cho ứng dụng LLM, thấy được cả prompt và vector DB, và xuất trace sang stack quan sát khách đang dùng.
Đọc bốn con số trên cùng một tuần
Tiếp tục ví dụ giả định: tuần đó có 1.000 run. Có 700 run kết thúc ở trạng thái completed, 200 run bị chuyển cho người, 100 run bỏ dở vì chạm giới hạn bước. Tỷ lệ hoàn thành là 70%, tỷ lệ chuyển cho người là 20%.
Con số 20% chưa nói lên tốt hay xấu, lý do chuyển mới quan trọng. Nếu phần lớn 200 run đó có escalation_reason là tool_error, vấn đề nằm ở tool tạo phiếu, và sửa timeout sẽ kéo tỷ lệ hoàn thành lên.
Nếu lý do là “yêu cầu vượt hạn mức hoàn tiền”, agent đang làm đúng việc của nó, và một agent không bao giờ chuyển cho người mới là thứ đáng lo.
Còn 100 run chạm giới hạn bước là tín hiệu riêng. Blaxel mô tả vòng lặp vô hạn là khi agent cứ thử lại một cách tiếp cận mà không tiến gần hơn tới đích.
Nếu phần lớn run xong trong khoảng 4 bước mà một nhóm run lên tới 15 bước, hãy mở trace của nhóm đó: rất có thể agent đang gọi lại tool tạo phiếu sau mỗi lần timeout.
Đến đây, ba con số đã chỉ về cùng một chỗ. Lỗi tool 14% sinh ra phần lớn số lần chuyển cho người và các vòng retry dài, và cả hai cùng kéo tỷ lệ hoàn thành xuống. Lúc gọi lại cho trưởng nhóm chăm sóc khách hàng, bạn không còn phải nói “chúng tôi đang điều tra”, bạn có một nguyên nhân và một kế hoạch sửa.
Năm bước để dựng từ đầu
Bước đầu tiên làm cùng khách hàng chứ không phải trong code. Các bước còn lại có thể dùng như một checklist:
- Thống nhất với khách hàng thế nào là “hoàn thành”. Với hoàn tiền, đó có thể là phiếu được tạo đúng và nhân viên không phải sửa, vì New Relic xếp số lần con người phải sửa vào tầng kết quả. Ghi định nghĩa này thành văn bản, nếu không mỗi bên sẽ đọc một kiểu.
Chốt schema JSON cho một run như ví dụ trên, kèm danh sách giá trị cố định cho outcome và escalation_reason.
3. Ghi log ở cuối mỗi run, kể cả run lỗi, vì những run bị bỏ sót thường chính là run hỏng.
4. Dựng một dashboard bốn ô, tách theo task_type và theo tool.
5.
Đặt ngưỡng cảnh báo cho tỷ lệ hoàn thành và cho số bước tối đa.
Khi đã ổn định, hãy thêm một con số nói được bằng ngôn ngữ của người ký hợp đồng. Blaxel gợi ý chi phí trên mỗi kết quả thành công, chỉ số nối chi phí hạ tầng với kết quả kinh doanh. Con số này dễ tính vì bản ghi đã có sẵn cả tokens lẫn outcome.
Những lỗi hay gặp
Lỗi phổ biến nhất là chỉ ghi log tầng vận hành vì công cụ có sẵn, rồi tưởng thế là đã giám sát agent. Lỗi thứ hai là báo cáo lỗi tool gộp chung, như phép tính 2% so với 14% ở trên. Lỗi thứ ba là ghi log bằng chuỗi văn bản tự do, đến lúc cần đếm theo trường thì phải viết regex trong lúc khách đang chờ.
Còn một lỗi tinh vi hơn: coi tỷ lệ chuyển cho người là thứ phải ép xuống bằng mọi giá. Nếu ép quá tay, agent sẽ tự xử lý cả những ca nó không nên đụng tới, tỷ lệ escalation đẹp lên còn số lần nhân viên phải sửa thì tăng.
Cách thể hiện kỹ năng này khi đi xin việc
Khi đọc JD cho vị trí FDE hay AI engineer, hãy để ý các từ observability, OpenTelemetry, tracing hoặc evaluation in production. Gặp những từ này, bạn nên chuẩn bị sẵn một câu chuyện cụ thể về cách mình đã đo một agent để kể trong buổi phỏng vấn.
Trong CV, một dòng như “thiết kế schema log cho agent, tách tỷ lệ lỗi theo từng tool, phát hiện tool gây ra phần lớn escalation” có sức nặng hơn nhiều so với “có kinh nghiệm LLM”.
Lần tới khi khách gọi báo agent làm sai, câu hỏi đầu tiên của bạn không nên là “lỗi ở đâu”, mà là “trong bản ghi của các run đó, trường nào sẽ cho tôi biết”.
6 nguồn
- Classification: Accuracy, recall, precision, and related metrics (Google ML Crash Course) · 2026-01-12
- Structured logging (Cloud Logging documentation) · 2026-10-06
- Introducing OpenLLMetry — Extending OpenTelemetry to LLMs · 2023-10
- What is OpenLLMetry? - traceloop
- A Production Monitoring Blueprint for AI Agents (New Relic)
- AI observability: How to monitor production agents safely (Blaxel) · 2026-01-28