Bộ eval cũ nói dối sau vài tháng: cách bắt kịp dữ liệu thật đã đổi của khách
Dashboard vẫn báo 97% trong khi hàng đợi khiếu nại của khách dài thêm mỗi tuần. Nhiều khả năng model không tệ đi, mà bộ test của bạn đã ngừng giống thực tế.

Tóm tắt nhanh
- Bộ eval là ảnh chụp lưu lượng tại một thời điểm, còn production thì liên tục thay đổi. Khi khách ra tính năng mới, intent mới xuất hiện mà bộ test không có ca nào.
- Một bộ eval đạt gần 100% chỉ còn bắt được regression và không còn chỉ ra chỗ cần cải thiện.
- Hãy duy trì eval như duy trì unit test: ghi log mọi thứ, đọc mẫu thật định kỳ, gắn hạn dùng cho từng ca và giao cho một người chịu trách nhiệm.
Sáng thứ Hai, bạn mở dashboard eval của agent chăm sóc khách hàng đã deploy cho khách từ ba tháng trước. Mọi thứ vẫn xanh, 97%, gần như không đổi so với ngày go-live. Mười phút sau, trưởng bộ phận vận hành phía khách chuyển tiếp cho bạn một chuỗi email với tiêu đề “bot trả lời sai nhiều quá”.
Cả hai đều có thể đúng. Bộ eval không sai trên những ca nó đang chứa. Vấn đề là các ca đó không còn giống những gì người dùng thật hỏi hằng ngày.
FDE nào nhận ra điều này sớm sẽ giữ được lòng tin của khách. Ai chỉ tin dashboard sẽ là người cuối cùng biết chuyện, và thường biết qua một cuộc họp khó chịu.
Vì sao một bộ test đúng lại cho ra con số sai?
Một tài liệu thực hành về drift của Futureagi tóm gọn vấn đề: golden set là ảnh chụp, còn production là một phân phối. Lúc bạn dựng bộ eval, ảnh chụp đó khá giống thực tế. Nhưng doanh nghiệp của khách vẫn tiếp tục thay đổi sau ngày go-live.
Theo cùng nguồn này, một nguyên nhân thường gặp là sản phẩm thêm tính năng mới, kéo theo những loại câu hỏi (intent) mà bộ dữ liệu chưa từng tính đến. Một bài trên blog tianpan.co diễn đạt gọn hơn: bộ eval không phải fixture cố định mà là một bộ mô phỏng. Rủi ro chính là điểm offline tăng trong khi chất lượng trên production lại giảm.
OpenAI cũng xếp việc dựng bộ eval không tái hiện đúng lưu lượng production vào nhóm lỗi thiết kế thiên lệch. Khi người dùng thay đổi mà bộ test giữ nguyên, bạn sẽ rơi vào đúng lỗi này dù không cố ý.
Làm thử với một con số
Thử hình dung khách của bạn là một công ty giao hàng. Lúc go-live, bộ eval có 150 ca, chia theo đúng lưu lượng khi đó: 60% tra cứu đơn, 25% đổi địa chỉ, 15% khiếu nại. Agent đạt 97%, và mọi người hài lòng.
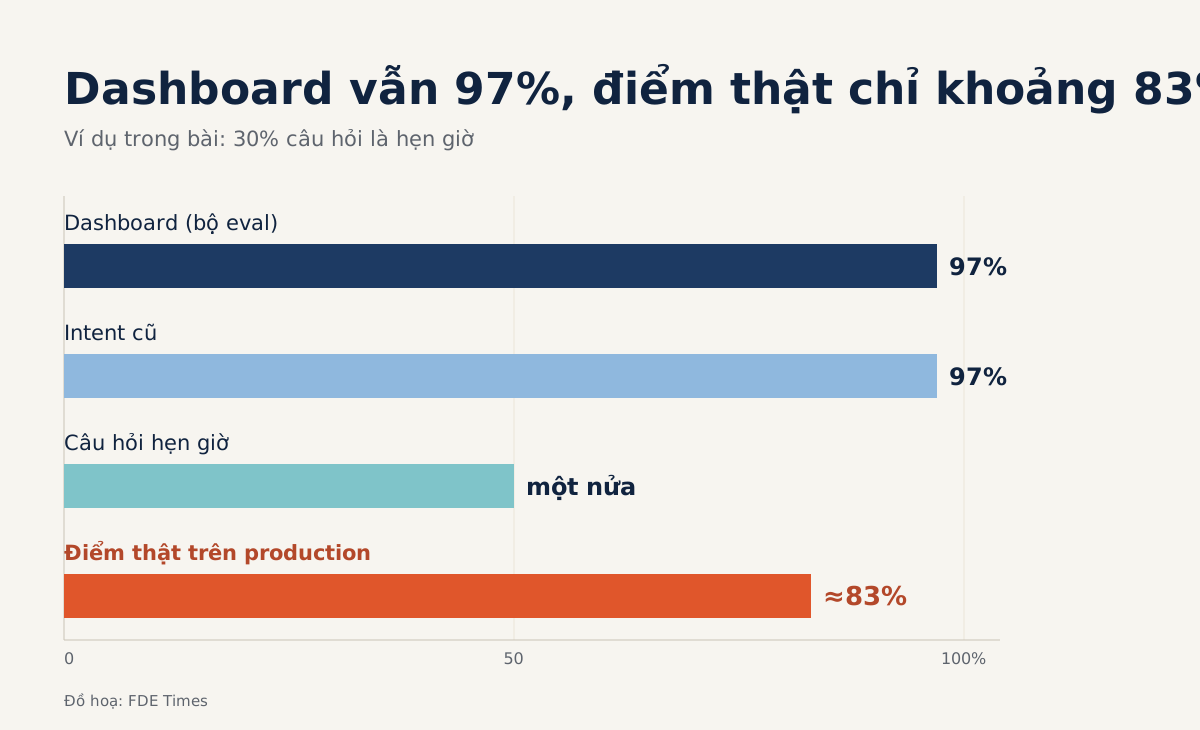
Tháng thứ hai, khách ra mắt tính năng giao hàng hẹn giờ. Đến tháng thứ ba, log cho thấy 30% câu hỏi liên quan đến hẹn giờ, chẳng hạn đổi khung giờ hay hỏi vì sao shipper đến trễ so với giờ đã hẹn. Bộ eval không có ca nào thuộc nhóm này, nên điểm vẫn là 97%.
Giả sử agent vẫn làm tốt 97% ở các intent cũ nhưng chỉ đúng một nửa số câu hỏi về hẹn giờ. Điểm thật trên lưu lượng production sẽ là 0,7 × 0,97 + 0,3 × 0,5, khoảng 83%. Không ai sửa model, không ai đổi prompt, nhưng cứ sáu người dùng thì có hơn một người nhận câu trả lời sai. Dashboard không cho thấy điều này.
Để phát hiện, bạn không cần công cụ phức tạp. Chỉ cần so tỷ lệ intent giữa bộ eval và một mẫu log gần đây:
from collections import Counter

def intent_gap(eval_cases, prod_samples, threshold=0.05):
    ev = Counter(c["intent"] for c in eval_cases)
    pr = Counter(s["intent"] for s in prod_samples)
    n_ev, n_pr = sum(ev.values()), sum(pr.values())
    gaps = []
    for intent in set(ev) | set(pr):
        share_prod = pr[intent] / n_pr
        share_eval = ev[intent] / n_ev
        if share_prod - share_eval > threshold:
            gaps.append((intent, round(share_prod, 2), round(share_eval, 2)))
    return sorted(gaps, key=lambda g: -g[1])

# Ví dụ kết quả: [("giao_hen_gio", 0.3, 0.0)]
Sau đó, tính điểm theo lưu lượng thật bằng cách nhân điểm của từng intent với tỷ lệ của intent đó trong production, rồi đặt con số này cạnh điểm offline trong báo cáo hằng tuần. Khi hai con số bắt đầu lệch nhau, bạn có lý do cụ thể để làm mới bộ eval, thay vì chỉ có cảm giác rằng có gì đó không ổn.
Quy trình làm mới, từng bước
Bước đầu tiên là có dữ liệu để so sánh. OpenAI khuyên ghi log mọi thứ ngay từ lúc phát triển để sau này lấy ra làm ca eval. Ở phía khách, điều này có nghĩa là bạn phải thỏa thuận trước quyền truy cập log, chính sách ẩn thông tin cá nhân và thời gian lưu trữ, ngay trong tuần đầu của dự án.
Bước thứ hai là đọc dữ liệu thật, không chỉ nhìn biểu đồ. Hamel Husain coi việc phân tích lỗi trên ví dụ thật là hoạt động đáng đầu tư nhất, vì không gì thay thế được những gì bạn học được khi xem từng ca cụ thể.
Ông cũng nhấn mạnh rằng test phải được cập nhật liên tục theo những gì bạn quan sát qua đánh giá thủ công và debug.
Bước thứ ba là chọn ca mới cho đúng. Theo Husain, test nên khó nhất có thể nhưng vẫn phải phản ánh cách người dùng thật tương tác với hệ thống. Vì vậy, hãy lấy câu hỏi thật về hẹn giờ, kể cả câu viết sai chính tả hay thiếu mã đơn, thay vì tự viết những câu gọn gàng mà người dùng không bao giờ gõ.
Bước thứ tư là gắn hạn dùng. Bài trên tianpan.co đề xuất mỗi ca eval có một hạn làm mới riêng. Futureagi lấy chu kỳ hằng tháng làm mặc định, và đây là điểm khởi đầu hợp lý cho đến khi bạn biết lưu lượng của khách thay đổi nhanh đến đâu.
Ca quá hạn không bị xóa ngay mà được đối chiếu lại với log mới, sau đó giữ, sửa hoặc chuyển sang bộ regression.
Bước cuối cùng là chỉ định người chịu trách nhiệm. Anthropic mô tả bộ eval là một thứ sống, cần được chăm sóc thường xuyên và có người sở hữu rõ ràng.
Họ cũng khuyên việc duy trì eval nên trở thành việc thường ngày giống như duy trì unit test. Khi bàn giao dự án, hãy ghi rõ tên người này vào runbook, vì “cả team cùng lo” thường có nghĩa là không ai làm.
Những cái bẫy thường gặp
Bẫy đầu tiên là coi 100% là đích đến. Anthropic lưu ý rằng một bộ eval đạt 100% chỉ còn theo dõi được regression và không còn chỉ ra chỗ nào cần cải thiện. Nếu bộ test của bạn đã bão hòa, đó là dấu hiệu cần thêm ca khó, không phải lý do để ăn mừng.
Bẫy thứ hai là tin LLM-as-judge mãi mãi. Husain cảnh báo rằng đánh giá tự động thường lệch dần khỏi kỳ vọng của con người.
Trong ví dụ trên, judge được hiệu chỉnh trên câu hỏi tra cứu đơn có thể chấm sai câu trả lời về khung giờ hẹn. Vì vậy, mỗi lần làm mới bộ eval, hãy để một người phía khách chấm lại một mẫu nhỏ và so với kết quả của judge.
Bẫy thứ ba là nghĩ rằng eval offline có thể thay thế giám sát. Anthropic xếp production monitoring thành một lớp riêng, chạy sau khi ra mắt để phát hiện distribution drift và những lỗi ngoài đời thực mà không ai lường trước. Eval cho biết hệ thống có làm đúng những gì bạn đã nghĩ tới hay không, còn monitoring cho biết những gì bạn chưa nghĩ tới.
Kể câu chuyện này trong hồ sơ thế nào?
Dựng một bộ eval mới là một nửa câu chuyện; nửa còn lại là bạn giữ nó đúng sau go-live ra sao. Trên CV, hãy viết theo kết quả, chẳng hạn: làm mới bộ eval hằng tháng từ log production và phát hiện một intent mới trước khi khách phải lên tiếng.
Trong phỏng vấn, khoảng cách giữa 97% và 83% là một câu chuyện cụ thể hơn mọi định nghĩa thuộc lòng.
Bài tập cho tuần này
Chọn một hệ thống bạn đang vận hành, hoặc một dự án cá nhân có log. Chạy hàm intent_gap trên log của 30 ngày gần nhất, tính điểm theo lưu lượng thật rồi đặt nó cạnh điểm offline.
Nếu hai con số gần nhau, bạn đã có bằng chứng để trả lời khách khi họ hỏi hệ thống còn tốt không. Nếu chúng lệch nhau, bạn vừa phát hiện vấn đề trước khi khách gửi email cho bạn.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
6 nguồn
- Demystifying evals for AI agents · 2026-01-09
- Your AI Product Needs Evals · 2024-03-29
- A Field Guide to Rapidly Improving AI Products · 2025-03-24
- Evaluation best practices
- The Eval-Set-as-Simulator Drift: When Offline Scores Improve and Production Gets Worse · 2026-04-27
- LLM Eval Data Drift Detection in 2026 · 2026-03-03