Batch API: xử lý 300.000 tài liệu của khách với nửa giá mà không vỡ hạn chót
Phần khó không nằm ở chỗ gọi API rẻ hơn, mà ở việc biết công việc nào chịu được chờ đợi, chia lô sao cho gọn và không để mất kết quả sau 29 ngày.

Tóm tắt nhanh
- Anthropic, OpenAI và Google Gemini đều giảm 50% cho batch. Với Anthropic và OpenAI, cái giá là chấp nhận chờ tối đa 24 giờ, dù phần lớn batch của Anthropic xong trong chưa đầy một giờ.
- 24 giờ là mức trần chứ không phải cam kết: batch chưa xong sẽ hết hạn. Hạn chót của khách vì thế cần đủ rộng để chạy lại một lượt.
- Kết quả batch trên Anthropic chỉ tải được trong 29 ngày, nên pipeline phải lưu ngay vào kho của khách.
Thứ Hai, khách hàng gửi bạn đường dẫn tới một bucket chứa 300.000 hợp đồng cũ. Họ muốn mỗi hợp đồng được gắn nhãn loại điều khoản và rủi ro trước buổi họp hội đồng vào thứ Sáu. Bản demo tuần trước chạy rất mượt, vì mỗi lần nó chỉ gọi mô hình cho một tài liệu.
Gọi 300.000 lần theo kiểu đó sẽ đụng rate limit, giành quota với tính năng chat mà người dùng của khách đang dùng hằng ngày, và tốn gấp đôi mức cần thiết. Những công việc như thế này là lý do các nhà cung cấp làm ra Batch API. Một FDE giỏi phải biết lúc nào nên dùng nó, và quan trọng không kém là lúc nào không nên.
Đổi thời gian lấy nửa giá
Message Batches API của Anthropic được làm cho việc xử lý hàng loạt theo kiểu bất đồng bộ. Toàn bộ lượng token trong batch, cả đầu vào lẫn đầu ra, đều tính bằng 50% giá API chuẩn. Theo tài liệu của hãng, phần lớn batch xong trong chưa đầy một giờ.
Ưu đãi này không riêng gì Anthropic. Simon Willison ghi nhận OpenAI và Google Gemini cũng giảm 50% cho batch. Batch API của OpenAI hoàn tất trong 24 giờ, và cửa sổ hoàn tất duy nhất được chấp nhận là 24 giờ. Cái bạn bỏ ra để đổi lấy nửa giá là quyền có kết quả ngay.
Vì thế câu hỏi quyết định không nằm ở kỹ thuật mà ở sản phẩm: có ai đang ngồi chờ kết quả không? Anthropic liệt kê những việc hợp với batch là chạy eval, kiểm duyệt nội dung, phân tích dữ liệu và sinh nội dung hàng loạt. Điểm chung của chúng là không có người dùng nào đang nhìn vào ô chat.
Nên chạy batch
- Gắn nhãn kho tài liệu tồn đọng
- Chạy lại bộ eval sau mỗi lần sửa prompt
- Kiểm duyệt nội dung người dùng đã đăng
- Tóm tắt báo cáo, xong trước sáng hôm sau
Phải chạy real-time
- Chatbot, trợ lý trả lời người dùng
- Agent phải ra quyết định ngay trong một quy trình
- Duyệt giao dịch cần chặn tức thì
- Mọi màn hình có người bấm nút rồi chờ
Một product manager của Quora từng nói gọn trải nghiệm này: gửi batch đi rồi tải kết quả về trong vòng 24 giờ là rất tiện. Chữ “tiện” chỉ đúng khi quy trình của khách vốn đã tính theo ngày chứ không phải theo giây.
24 giờ là mức trần, đừng biến nó thành cam kết với khách
Đây là chỗ nhiều kỹ sư làm sai. Lúc ra mắt ngày 8/10/2024, Anthropic mô tả mỗi batch được xử lý trong chưa đầy 24 giờ. Tài liệu hiện tại thì nói rõ hơn: batch chưa xử lý xong trong 24 giờ sẽ hết hạn, và khi nhu cầu tăng cao, số batch hết hạn có thể nhiều lên.
Nếu bạn hứa với khách “kết quả có sau 24 giờ” thì bạn đang hứa một điều mà nhà cung cấp không hứa với bạn. Quy tắc nên dùng là hạn chót của khách phải đủ chỗ cho ít nhất hai cửa sổ: một lượt chạy chính và một lượt chạy lại phần hết hạn hoặc lỗi.
Hạn thứ Sáu mà dữ liệu sẵn sàng từ thứ Hai thì thoải mái. Dữ liệu tối thứ Năm mới có thì nên chạy real-time cho phần gấp.
Bài toán mẫu: chia 300.000 hợp đồng
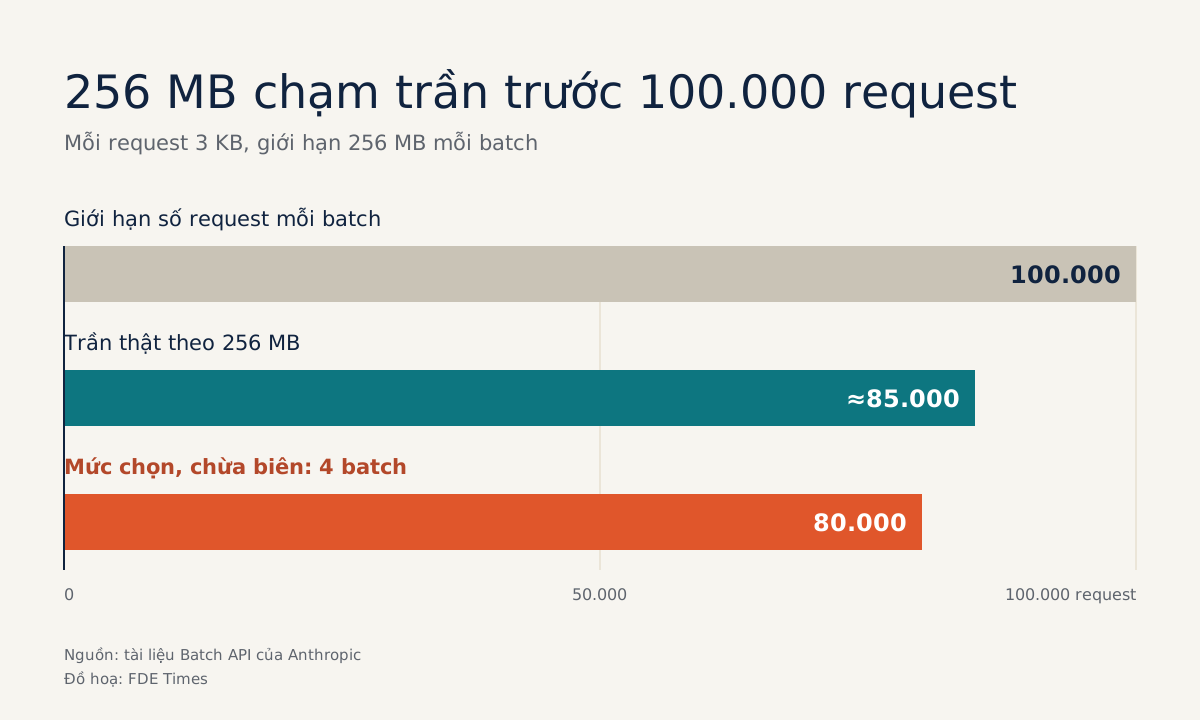
Giới hạn của Anthropic là 100.000 request hoặc 256 MB mỗi batch, chạm mức nào trước thì tính mức đó. Đọc nhanh thì 300.000 tài liệu chỉ cần 3 batch. Nhưng hợp đồng thường dài, và giới hạn dung lượng sẽ chặn bạn trước giới hạn số lượng.
Giả sử mỗi request, gồm văn bản hợp đồng và prompt, nặng trung bình 3 KB. Khi đó 100.000 request là khoảng 300 MB, vượt 256 MB. Chia 256 MB cho 3 KB được khoảng 85.000 request.
Chừa biên an toàn cho những hợp đồng dài bất thường, bạn đặt mức 80.000 request mỗi batch và có 4 batch. Nếu khách dùng OpenAI, giới hạn là 50.000 request và file đầu vào 200 MB, nên con số phải tính lại từ đầu.
Điểm thứ hai cần thiết kế là custom_id. Đó là sợi dây duy nhất nối kết quả về đúng tài liệu, nên hãy dùng khóa chính trong hệ thống của khách chứ đừng dùng số thứ tự vòng lặp. Đoạn mã dưới đây phác họa luồng xử lý với SDK Python của Anthropic:
import anthropic

client = anthropic.Anthropic()

# Prompt hệ thống dùng chung cho mọi hợp đồng, nên cache 1 giờ
SYSTEM = [{
    "type": "text",
    "text": HUONG_DAN_GAN_NHAN,  # chuẩn phân loại dài, dùng chung
    "cache_control": {"type": "ephemeral", "ttl": "1h"},
}]

def to_request(doc):
    return {
        "custom_id": doc.contract_id,  # khóa chính của khách
        "params": {
            "model": MODEL,
            "max_tokens": 1024,
            "system": SYSTEM,
            "messages": [{"role": "user", "content": doc.text}],
        },
    }

batch = client.messages.batches.create(
    requests=[to_request(d) for d in chunk]  # chunk tối đa 80.000 tài liệu
)

# Sau khi processing_status == "ended":
for entry in client.messages.batches.results(batch.id):
    if entry.result.type == "succeeded":
        save_to_customer_store(entry.custom_id, entry.result.message)
    else:  # "errored" hoặc "expired"
        queue_for_retry(entry.custom_id, entry.result.type)
Dòng cache_control không phải trang trí. Batch có thể chạy lâu hơn 5 phút, nên Anthropic khuyên dùng thời hạn cache 1 giờ để phần ngữ cảnh dùng chung như bản hướng dẫn gắn nhãn dài được cache trúng nhiều hơn.
Ngày 15/10/2024, Willison tính rằng kết hợp prompt caching với batch có thể giảm gần 95% chi phí token của Claude 3.5 Sonnet. Mức thực tế phụ thuộc vào tỷ lệ prompt dùng chung trong mỗi request, nhưng hướng đi thì rõ.
Kết quả không nằm ở đó mãi
Kết quả batch trên Anthropic chỉ tải về được trong 29 ngày kể từ lúc tạo. Sau đó bạn vẫn xem được batch nhưng không còn lấy được kết quả. Với một dự án mà khách có thể quay lại hỏi “hợp đồng số này được gắn nhãn thế nào” sau ba tháng, đó là một lỗ hổng.
Vì vậy bước save_to_customer_store phải chạy ngay khi batch kết thúc và ghi vào kho do khách sở hữu, kèm phiên bản prompt và mô hình đã dùng.
Nếu khách đang có tính năng real-time chạy song song, OpenAI có thêm một điểm cộng nên nhắc với khách: rate limit của batch tách riêng khỏi rate limit theo từng mô hình, nên một job lớn không lấy mất quota của lưu lượng thật.
Quy trình triển khai và những lỗi hay gặp
Trình tự nên theo khi gặp một kho tài liệu lớn là: xác nhận không ai cần kết quả theo thời gian thực, đo kích thước request trung bình, chạy thử một batch nhỏ khoảng 1.000 tài liệu, chia phần còn lại theo cả hai giới hạn, rồi dựng vòng chạy lại cho request lỗi và hết hạn trước khi gửi batch lớn.
Batch thử cho bạn số liệu thật về thời gian và tỷ lệ lỗi, để báo với khách bằng con số chứ không bằng phỏng đoán.
Lỗi phổ biến nhất là coi 24 giờ như SLA. Kế đến là chỉ chia batch theo số request, rồi phát hiện vượt giới hạn dung lượng khi gửi. Lỗi thứ ba khó thấy hơn: dùng custom_id không ánh xạ được về hệ thống của khách, khiến 300.000 kết quả trả về mà không biết dòng nào thuộc hợp đồng nào.
Hai lỗi còn lại liên quan đến vận hành. Một là để kết quả nằm trên nền tảng của nhà cung cấp và quên tải về trước ngày thứ 29. Hai là không xử lý các trường hợp errored và expired, nên báo cáo cho khách lặng lẽ thiếu vài phần trăm dữ liệu mà không ai biết.
Ghi nó vào CV thế nào
Khi đọc JD của một vị trí FDE, bạn nên dò xem công việc có nhắc tới xử lý khối lượng lớn tài liệu, chạy eval định kỳ hay kiểm soát chi phí mô hình không. Nếu có, kinh nghiệm với batch là thứ đáng mang vào buổi phỏng vấn.
Trên CV, một dòng như “chuyển pipeline gắn nhãn N tài liệu từ real-time sang batch, giảm một nửa chi phí, có cơ chế chạy lại và lưu kết quả vào kho của khách” cho người tuyển dụng thấy bạn hiểu cả chi phí, độ tin cậy lẫn quyền sở hữu dữ liệu.
Khách hàng hiếm khi hỏi bạn về Batch API. Họ hỏi vì sao hóa đơn tháng này cao, hoặc vì sao chatbot chậm đúng hôm chạy job lớn. FDE nào nhận ra sớm rằng một nửa khối lượng công việc vốn không cần trả lời ngay thường sẽ là người trả lời được cả hai câu.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!