RAG cho kỹ sư vận hành: để trợ lý trả lời đúng máy, đúng bản SOP
Chỉ cần một đoạn manual mất tên model, một SOP đã hết hiệu lực hoặc một mã lỗi mà embedding không nhận ra là kỹ thuật viên ca đêm đã thôi tin trợ lý.

Tóm tắt nhanh
- Pipeline RAG chia theo số token rồi embed sẽ làm chunk mất ngữ cảnh, cắt đôi bảng và dễ trượt mã lỗi, trong khi manual thiết bị và câu hỏi của kỹ thuật viên lại đầy bảng và mã lỗi.
- Hãy chia chunk theo cấu trúc tài liệu, gắn ngữ cảnh, tìm kiếm lai BM25 cộng vector, lọc riêng cho từng loại tài liệu và lần nào trả lời cũng dẫn nguồn.
- Bắt đầu bằng một workflow cố định. Chỉ chuyển sang agent khi câu hỏi thật sự cần mô hình tự chọn công cụ.
Hai giờ sáng, một kỹ thuật viên gõ vào trợ lý mà đội bạn vừa deploy mã cảnh báo đang nháy trên màn hình máy nén. Câu trả lời trôi chảy, các bước rõ ràng, nhưng được lấy từ manual của một model khác và từ một bản SOP đã bị thay thế.
Đây là một tình huống giả định, nhưng pipeline RAG nào dựng vội trên tài liệu kỹ thuật cũng rất dễ mắc đúng kiểu lỗi này.
Bản demo chạy trên mười câu hỏi đẹp thì thường ổn. Đến khi lên site, nó gặp manual dày đặc bảng biểu, SOP có nhiều phiên bản và hàng nghìn work order viết vội.
Cái khó không nằm ở việc chọn mô hình, mà ở việc thiết kế retrieval cho ba loại tài liệu khác hẳn nhau. Các phần dưới đi qua từng bước, bám theo một mã cảnh báo từ lúc chia chunk đến lúc trả lời.
Vì sao RAG kiểu cũ hỏng trên manual thiết bị?
Thử nghĩ đến một đoạn như “Xả hết áp trước khi tháo van an toàn”. Khi bị tách khỏi tài liệu gốc, đoạn này không còn cho biết nó áp dụng cho máy nào, model nào.
Cách chia chunk theo kích thước cố định còn gây hại nặng hơn. Một bài phân tích trên VentureBeat lấy ví dụ một bảng thông số bị cắt sao cho tiêu đề “voltage limit” nằm ở chunk này còn giá trị “240V” rơi sang chunk khác. Theo tác giả, cách chia đó ổn với văn xuôi nhưng phá nát logic của manual kỹ thuật.
Vấn đề thứ ba nằm ở cách người vận hành đặt câu hỏi. Họ gõ mã cảnh báo, mã linh kiện, số hiệu tài sản. Anthropic lưu ý rằng BM25 đặc biệt hiệu quả với truy vấn có định danh riêng hoặc thuật ngữ kỹ thuật.
Tài liệu Azure AI Search của Microsoft cũng nói rằng mã sản phẩm, biệt ngữ chuyên ngành, ngày tháng và tên người được tìm tốt hơn bằng keyword search vì nó khớp chính xác.
Ba loại tài liệu, ba cách xử lý
| Nguồn | Chia chunk theo | Metadata bắt buộc | Rủi ro chính |
|---|---|---|---|
| Manual thiết bị | Chương, mục, giữ nguyên bảng | model, chương, trang | Chunk mất tên model, bảng bị cắt |
| SOP | Từng quy trình hoặc từng bước lớn | revision, status, ngày hiệu lực | Trả về bản đã bị thay thế |
| Work order đã đóng | Mỗi work order một chunk | asset_id, mã lỗi, ngày đóng | Ghi chép vội, thiếu chuẩn hoá |
Rủi ro phiên bản không phải chuyện lý thuyết. Nhóm tác giả VersionRAG trên arXiv đo được rằng các cách tiếp cận hiện có chỉ đạt 58-64% độ chính xác với câu hỏi phụ thuộc phiên bản. Nguyên nhân họ chỉ ra là retriever lấy nội dung giống về ngữ nghĩa mà không kiểm tra nó còn hiệu lực hay không.
Các nhà cung cấp phần mềm bảo trì như OxMaint mô tả việc lọc kết quả tìm kiếm theo hãng, model, site và lịch sử bảo trì của chính tài sản đang hỏi. Đây là lời giới thiệu sản phẩm, chưa có đo lường độc lập, nhưng nó mô tả khá sát yêu cầu “đúng máy” mà đội vận hành cần.
Theo chân mã E-217 qua năm bước
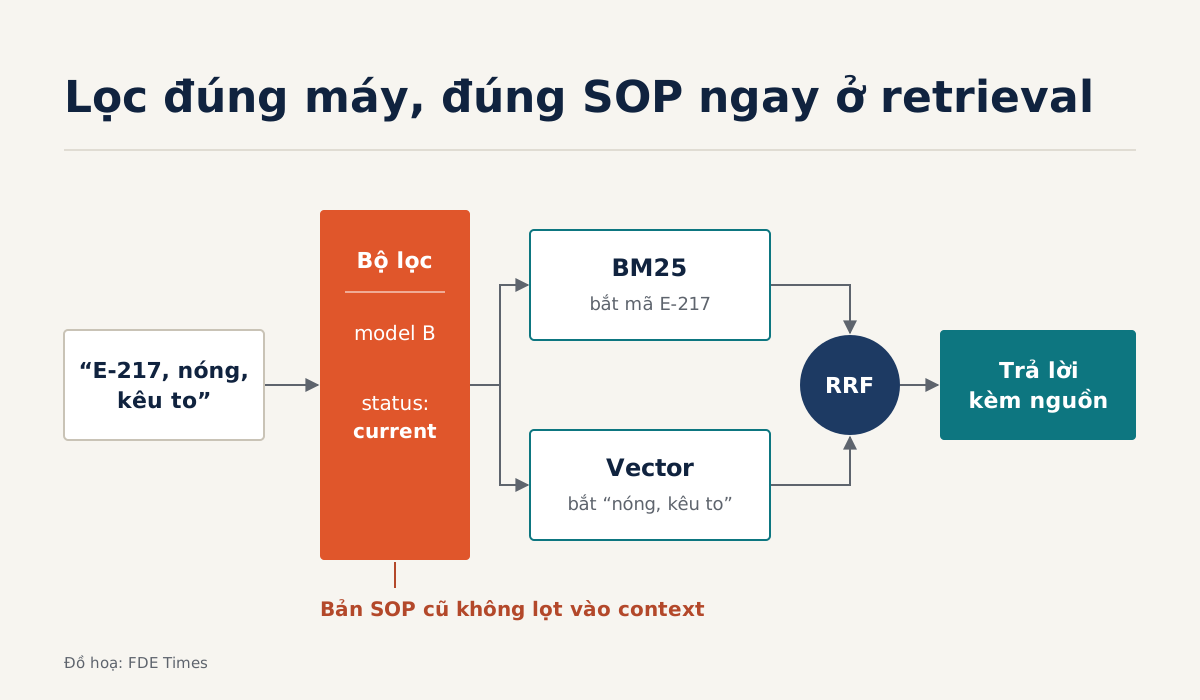
Thử hình dung một nhà máy có hai dòng máy nén là model A và model B. Cả hai dùng chung mã cảnh báo “E-217” nhưng ý nghĩa khác nhau. Một kỹ thuật viên đang đứng trước máy model B và hỏi: “E-217, máy nóng và kêu to, xử lý sao?”.
Bước một là chia chunk theo cấu trúc tài liệu: theo chương, mục và đoạn chứ không theo số token. Mỗi mục trong chương “Xử lý cảnh báo” của manual model B thành một chunk, và bảng mã lỗi được giữ nguyên để tiêu đề cột không bao giờ rời khỏi giá trị.
Bước hai là gắn ngữ cảnh trước khi encode. Cách rẻ nhất là ghép một dòng header từ metadata sẵn có:
def contextualize(chunk, doc):
    header = (f"[{doc.doc_type} | model {doc.model} | "
              f"{doc.section_path} | rev {doc.revision}]")
    return header + "\n" + chunk.text  # đưa vào cả embedding lẫn BM25
Dòng header này chỉ là phương án thay thế rẻ, không phải kỹ thuật contextual embeddings mà Anthropic dùng khi đo kết quả ở phần sau. Nó giúp chunk giữ được tên model, nhưng đừng kỳ vọng nó tự mang lại đúng con số đó.
Bước ba là tìm kiếm lai. Microsoft mô tả cách làm: chạy song song truy vấn full-text và truy vấn vector, rồi hợp nhất hai danh sách bằng Reciprocal Rank Fusion (RRF). Pipeline của Anthropic cũng gộp và khử trùng lặp kết quả BM25 với embedding theo cách tương tự.
def rrf(ranked_lists, k=60):
    # k: hằng số làm mượt; 60 là giá trị mặc định thường gặp
    scores = {}
    for ranked in ranked_lists:
        for rank, doc_id in enumerate(ranked, start=1):
            scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank)
    return sorted(scores, key=scores.get, reverse=True)

def doc_filter(asset):
    # mỗi loại tài liệu một điều kiện riêng, nối bằng OR
    return {"$or": [
        {"doc_type": "manual", "model": asset.model},
        {"doc_type": "sop", "status": "current"},
        {"doc_type": "work_order", "asset_id": asset.asset_id},
    ]}

def retrieve(query, asset, top_n, k=60):
    f = doc_filter(asset)
    lexical = bm25.search(query, filter=f, top=top_n)
    semantic = vectors.search(embed(query), filter=f, top=top_n)
    return rrf([lexical, semantic], k)
Bộ lọc được viết riêng cho từng loại tài liệu vì metadata của chúng khác nhau. Nếu áp một điều kiện chung kiểu “model B và status hiện hành” cho mọi thứ, các work order đã đóng, vốn không có trường status, sẽ bị loại sạch, dù đó lại là nguồn sát nhất với chiếc máy đang hỏng.
RRF hợp với bài toán này vì nó bỏ qua điểm thô và chỉ dùng thứ hạng, nên không cần chuẩn hoá điểm BM25 và điểm cosine về cùng thang. Mỗi chunk nhận 1/(k + rank) ở từng danh sách, rồi cộng lại.
Tính thử với k = 60. Giả sử work order E-217 trên chính máy này đứng hạng 2 ở cả hai danh sách: 1/62 + 1/62 ≈ 0,0323. Bảng E-217 trong manual model B đứng hạng 1 ở BM25 và hạng 4 ở vector: 1/61 + 1/64 ≈ 0,0320.
Còn một đoạn chung chung về “máy quá nhiệt” đứng hạng 1 ở vector nhưng không có mặt ở BM25 chỉ được 1/61 ≈ 0,0164. Bài học: chunk mà cả BM25 lẫn vector cùng xếp cao sẽ vượt lên trên chunk chỉ được một bên xếp đầu.
Bước bốn là điều kiện status: current dành riêng cho SOP. OxMaint mô tả yêu cầu chỉ mục luôn trả về phiên bản SOP hiện hành và tự động loại các quy trình đã bị thay thế. Đặt điều kiện này ở tầng retrieval thay vì nhắc mô hình trong prompt thì bản cũ sẽ không bao giờ lọt vào context.
Bước năm là trả lời kèm nguồn. Câu trả lời tốt nên gồm bước xử lý lấy từ SOP hiện hành, đoạn manual của model B và các work order gần nhất có E-217 trên cùng tài sản, mỗi phần có một link để kỹ thuật viên tự kiểm chứng.
Đo trước khi tin bất kỳ con số nào
Theo Anthropic, kết hợp contextual embeddings với contextual BM25 giảm 49% tỷ lệ truy xuất thất bại ở top-20 chunk. Đó là kết quả trên dữ liệu của họ, với kỹ thuật của họ, không phải trên manual của khách hàng bạn với một dòng header ghép từ metadata.
Vì vậy, việc đầu tiên khi đến site là gom câu hỏi thật từ sổ giao ca và ticket. Ghi lại tài liệu và mục đúng cho từng câu, rồi đếm bao nhiêu câu không có đáp án đúng trong top-20.
Con số đó là baseline. Mọi thay đổi về chunking, BM25, giá trị k hay bộ lọc đều phải được đánh giá lại trên chính bộ câu hỏi này.
Workflow trước, agent sau
Khi retrieval đã đúng, mới đến câu hỏi kiến trúc. Anthropic định nghĩa workflow là hệ thống điều phối mô hình và công cụ qua các luồng code định sẵn, phân biệt với agent. Họ khuyên tìm giải pháp đơn giản nhất và chỉ tăng độ phức tạp khi thật sự cần.
Với đội vận hành, phần lớn câu hỏi có cùng một dạng: “máy này báo mã kia, làm gì tiếp?”. Pipeline năm bước ở trên là đủ cho dạng này.
Bạn chỉ nên chuyển sang agent khi câu hỏi buộc mô hình tự quyết định gọi hệ thống nào trước, chẳng hạn tra CMMS xem máy vừa thay linh kiện gì rồi mới quay lại đọc manual. Khi đó, tầng retrieval đã dựng không bị bỏ đi: nó trở thành một công cụ mà agent gọi, kèm sẵn bộ lọc đúng máy và đúng bản SOP.
Năm cái bẫy khi dựng trợ lý vận hành
Cái bẫy đầu tiên là giữ cách chia chunk theo token từ bản demo rồi đi chỉnh prompt khi câu trả lời sai, trong khi thủ phạm là bảng bị cắt đôi. Kế đến là chỉ dùng vector search, nên truy vấn có mã lỗi hay mã linh kiện trượt mà không ai hiểu vì sao.
Nạp mọi phiên bản SOP vào cùng một chỉ mục mà không có trường status cũng nguy hiểm không kém, vì bản cũ vẫn có thể lọt vào context. Trả lời không dẫn nguồn thì người vận hành không có cách nào phân biệt câu đúng với câu bịa.
Cái bẫy cuối cùng là dựng agent đa công cụ ngay từ ngày đầu, trong khi một workflow cố định có thể đã giải quyết được phần lớn câu hỏi.
Dòng CV nào cho thấy bạn làm được việc này?
“Xây chatbot RAG cho đội vận hành” không nói gì với nhà tuyển dụng. Hãy nêu kỹ năng cụ thể: chia chunk theo cấu trúc, tìm kiếm lai hợp nhất bằng RRF, lọc SOP theo revision.
Rồi thêm kết quả: số câu trượt top-20 giảm từ X xuống Y trên bộ câu hỏi lấy từ sổ giao ca. X và Y phải là con số bạn tự đo. Nếu mô tả công việc có nhắc đến tài liệu kỹ thuật, CMMS hay evaluation, hãy đặt dòng này ở đầu phần kinh nghiệm.
Đội vận hành không cần một trợ lý biết mọi thứ. Họ cần một trợ lý biết rõ mình đang nói về máy nào, theo bản SOP nào, và lần nào cũng chỉ ra được nguồn.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
7 nguồn
- Introducing Contextual Retrieval · 2024-09-19
- Hybrid Search Overview - Azure AI Search | Microsoft Learn · 2026-08-31
- Most RAG systems don't understand sophisticated documents — they shred them · 2026-01-31
- Retrieval-Augmented Generation (RAG) for Maintenance Knowledge Management · 2026-05-31
- Building effective agents · 2024-12-19
- VersionRAG: Version-Aware Retrieval-Augmented Generation for Evolving Documents · 2025-10-09
- Hybrid Search: Keywords and Vectors Cover Each Other's Blind Spots