616 trang Building Microservices, FDE chỉ cần đọc kỹ năm chương
Chọn đúng chương, bạn học cách đọc chuỗi gọi đồng bộ, hợp đồng API và sự cố chậm trong hệ thống người khác dựng.
Tóm tắt nhanh
- Sách dày khoảng 616 trang, nhưng FDE nên đọc kỹ năm chương trước: 4, 5, 12, 10 và 2
- Ba ý nên giữ: chuỗi gọi đồng bộ dài là rủi ro, event có thể đến trùng, dịch vụ phản hồi chậm là một trong những kiểu hỏng tệ nhất
- Sách là điểm khởi đầu chứ chưa đủ để bạn vận hành microservices trong production
Building Microservices bản 2 của Sam Newman dày khoảng 616 trang và có 16 chương. Một FDE sắp phải nối sản phẩm của mình vào hệ thống hàng chục dịch vụ của khách thì không có thời gian đọc hết trước buổi kickoff. Nhưng để bắt đầu đọc được hệ thống của người khác, bạn chỉ cần đọc kỹ năm chương.
Phần lớn sách viết cho người xây microservices, còn việc của FDE thường là đọc và nối vào một hệ thống mà người khác đã dựng, đôi khi dựng không khéo. Nếu đọc đúng chương, bạn sẽ có từ vựng và vài quy tắc để chẩn đoán nhanh hơn, ngay trong tuần đầu ở chỗ khách.
Bản 2 khác gì và đáng tin đến đâu?
Newman cho biết bản 2 là bản làm lại toàn bộ: từng trang của bản đầu đều được xem lại và viết lại khi cần. Các ý tưởng gốc vẫn còn, nhưng phần lớn câu chữ là mới.
Ông cũng dành nhiều thời gian hơn cho tác động của container, Kubernetes và serverless. Trang của Helion, nơi bán lại bản ebook của O’Reilly Media, còn liệt kê thêm phần mới về giao diện người dùng, điều phối container và bảo mật.
Sách chia làm ba phần. Phần I, Foundation, gồm các chương 1 đến 4: microservices là gì, cách mô hình hoá dịch vụ, cách tách monolith và các kiểu giao tiếp giữa dịch vụ.
Phần II, Implementation, gồm các chương 5 đến 13: giao tiếp, workflow, build, deployment, testing, observability, bảo mật, khả năng chịu lỗi và mở rộng. Phần III, People, bàn về giao diện người dùng, cơ cấu tổ chức và vai trò của evolutionary architect, người giúp kiến trúc thay đổi dần theo thời gian.
Sách cũng không tô hồng microservices. Một bài review của người làm nghề nhận xét sách cho thấy microservices không phải viên đạn bạc và có những nhược điểm riêng.
Ngay từ năm 2015, Newman đã viết trên blog rằng vẽ sai ranh giới dịch vụ có thể phải trả giá đắt. Thái độ thận trọng này rất hợp với FDE, vì bạn sẽ thường gặp những hệ thống mà ranh giới đã bị vẽ sai.
Chương 4 và 12: vì sao một dịch vụ chậm nguy hiểm hơn một dịch vụ chết?
Hãy bắt đầu từ chương 4. Ghi chú của Dan Lebrero về chương này rút ra một quy tắc: với giao tiếp đồng bộ kiểu blocking, hãy cảnh giác với chuỗi gọi dài. Quy tắc đi kèm là đặt logic ở các endpoint chứ không đặt ở middleware.
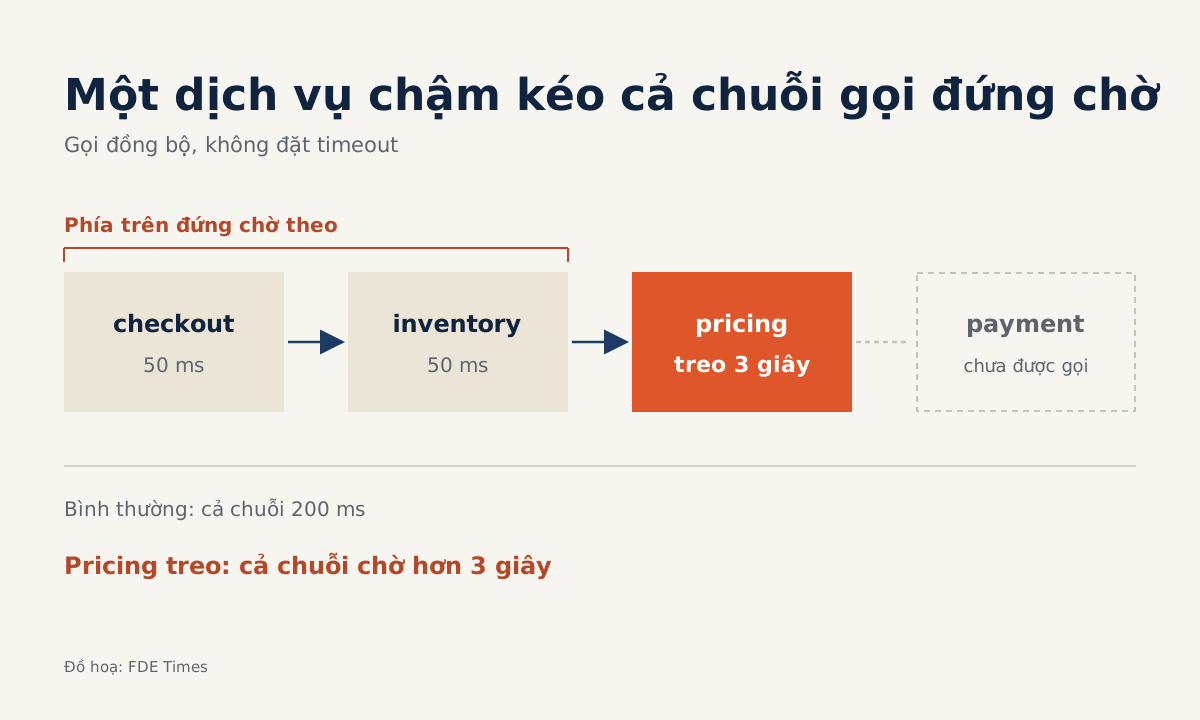
Thử hình dung luồng thanh toán của một khách bán lẻ. Checkout gọi inventory, inventory gọi pricing, pricing gọi payment, và tất cả đều gọi đồng bộ. Nếu mỗi dịch vụ mất 50 ms thì cả chuỗi mất 200 ms. Nhưng chỉ cần pricing bị treo 3 giây mà không ai đặt timeout, mọi request phía trên sẽ giữ kết nối và đứng chờ theo.
Chương 12 gọi đúng tên hiện tượng đó. Theo ghi chú của Lebrero, phản hồi rất chậm là một trong những kiểu hỏng tệ nhất mà bạn có thể gặp. Một dịch vụ chết hẳn sẽ báo lỗi ngay. Một dịch vụ chậm thì âm thầm làm cạn tài nguyên của mọi thứ đang gọi nó.
Ở chỗ khách, việc đầu tiên nên làm là vẽ lại chuỗi gọi của đúng luồng mà sản phẩm của bạn sẽ chạm vào. Sau đó hỏi họ timeout của từng chặng là bao nhiêu.
Chương 5: hợp đồng và message trùng
Chương 5 là chương bạn sẽ dùng nhiều nhất khi viết code tích hợp. Ghi chú của Lebrero tóm hai lời khuyên: dùng schema để bắt các thay đổi làm vỡ cấu trúc, và tránh kiểu deployment mà hai bên phải phát hành cùng lúc.
Áp vào việc của FDE, bạn nên đòi file schema của API khách sớm, rồi kiểm tra tự động trên schema đó, thay vì đoán cấu trúc dữ liệu từ vài response mẫu.
Lời khuyên tiếp theo khó nhận ra hơn. Đảm bảo giao nhận message là chuyện tinh vi, và tốt nhất hãy coi như sẽ có message trùng. Thử hình dung một agent của bạn nghe event “đơn đã thanh toán” để gửi email xác nhận.
Nếu broker gửi lại event đó hai lần, khách hàng của khách sẽ nhận hai email, hoặc tệ hơn là được cộng điểm thưởng hai lần. Cách xử lý là gắn idempotency key và kiểm tra key đó trước khi thực hiện tác vụ.
Chương 10 và 2: chẩn đoán hệ thống không phải của mình
Chương 10 đổi tên từ monitoring sang observability. Theo ghi chú của Lebrero về chương này, observability là mức độ bạn hiểu được trạng thái bên trong hệ thống từ những gì nó phát ra bên ngoài.
Khi debug hệ thống của người khác, bạn không đọc được hết code. Log, metric và trace là thứ duy nhất bạn có, nên hãy hỏi khách có distributed tracing hay không trước khi hứa thời hạn sửa lỗi.
Chương 2 cho bạn một phép thử ranh giới đơn giản, và ghi chú của Lebrero cho thấy ý này còn được nhắc lại ở chương 7: nếu lúc nào bạn cũng phải sửa nhiều dịch vụ cùng một lúc thì ranh giới đã sai.
Ở chỗ khách, hãy hỏi một tính năng gần đây phải sửa bao nhiêu repo. Câu trả lời sẽ cho bạn biết tích hợp của mình sẽ gặp ma sát ở đâu.
Ba lỗi dễ mắc nhất khi nối vào hệ thống khách
Lỗi đầu tiên là tin vài response mẫu hơn schema. Response mẫu chỉ cho bạn thấy dữ liệu hôm nay trông thế nào; khi khách đổi một trường, code tích hợp sẽ vỡ mà không ai báo trước, trong khi một bước kiểm tra trên schema sẽ bắt được thay đổi đó.
Lỗi thứ hai là mặc định mỗi message chỉ đến đúng một lần. Ghi chú chương 5 đã cảnh báo giao nhận message rất tinh vi, nên mọi handler nhận event hay webhook nên được viết như thể cùng một message sẽ quay lại.
Lỗi thứ ba là gọi đồng bộ sang dịch vụ của khách mà không đặt timeout. Như ví dụ checkout ở trên, chính lời gọi của bạn có thể trở thành một chặng nữa trong chuỗi đứng chờ.
Ai nên đọc, và đọc theo thứ tự nào?
Nếu bạn đã quen viết API nhưng chưa phải gỡ lỗi trên một hệ thống phân tán lớn, năm chương này là lối vào ngắn nhất. Thứ tự nên đọc là chương 4, rồi 5, 12, 10, cuối cùng là chương 2.
Phần III có thể để dành cho lúc bạn dẫn dắt cả một engagement. Bài review của người làm nghề chọn các chương 2, 6, 9 và 10 là hay nhất, nên chương 6 về workflow và chương 9 về testing là hai chương hợp lý để đọc sau năm chương trên.
Cũng chính người viết bài review đó nhắc rằng đọc xong bạn chưa sẵn sàng hoàn toàn để xây và vận hành microservices trong production. Vì thế, đọc xong hãy làm một việc cụ thể và ghi lại. Trong CV, đừng chỉ ghi “có kinh nghiệm hệ thống phân tán”.
Hãy viết rằng bạn đã vẽ lại chuỗi gọi trong hệ thống của khách, đặt timeout cho các lời gọi, và thêm idempotency cho tích hợp event-driven. Khi một tin tuyển dụng FDE nhắc đến integration hay observability, hãy đưa những dòng này lên đầu.
Năm chương này không biến bạn thành kiến trúc sư microservices. Chúng giúp bạn làm được việc mà khách cần ở FDE trong tuần đầu: chỉ ra hệ thống của họ có thể hỏng ở đâu, trước khi nó hỏng thật.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!