Bảy chương của Automate the Boring Stuff dành cho việc ở site khách
Sách có 24 chương, nhưng FDE chỉ cần bảy chương về file, Excel, CSV và web, và nên đọc theo đúng thứ tự.
Tóm tắt nhanh
- Ấn bản thứ ba của No Starch Press (5/2025) đọc miễn phí online theo giấy phép Creative Commons
- Chương 10, 11, 14, 18 lo phần file và bảng tính; chương 13 lo web, có cả Playwright
- Ba thói quen đáng giữ: lường kích thước file, sao lưu trước khi đụng vào, gọi API trước rồi mới tự động hóa trình duyệt
Trên trang chính thức của cuốn sách, Al Sweigart viết rằng phần hay nhất của lập trình là cảm giác chiến thắng khi thấy cái máy làm được một việc có ích. Với FDE, khoảnh khắc ấy hay đến vào tuần đầu ở chỗ khách: ai đó gửi một thư mục đầy Excel, PDF và CSV, rồi hỏi có làm gì được với đống này không.
Automate the Boring Stuff with Python đã có ấn bản thứ ba, được giới thiệu là “fully revised”, do No Starch Press phát hành tháng 5/2025. Sách đọc miễn phí trên trang chính thức theo giấy phép Creative Commons BY-NC-SA 3.0, và trang này cũng dẫn link mua bản in từ nhà xuất bản. Toàn bộ sách có 24 chương và hai phụ lục.
Bạn không cần đọc hết. Có bảy chương nói đúng về những việc đầu tiên ở một deployment: đọc file, dọn thư mục, mở bảng tính, chuyển định dạng, lấy dữ liệu từ web. Demo không cần tới những việc này, nhưng deployment thật thì không tránh được.
Vì sao sách về “việc nhàm chán” lại hợp với FDE?
Một agent hay một pipeline RAG chỉ tốt bằng dữ liệu đưa vào nó, mà dữ liệu của khách hiếm khi nằm sẵn trong một API gọn gàng.
Thường thì nó là báo cáo Excel do kế toán xuất ra mỗi tháng, hợp đồng dạng PDF và Word, hoặc một cổng web nội bộ không có tài liệu nào. Muốn sang được phần thú vị thì bạn phải qua phần này trước.
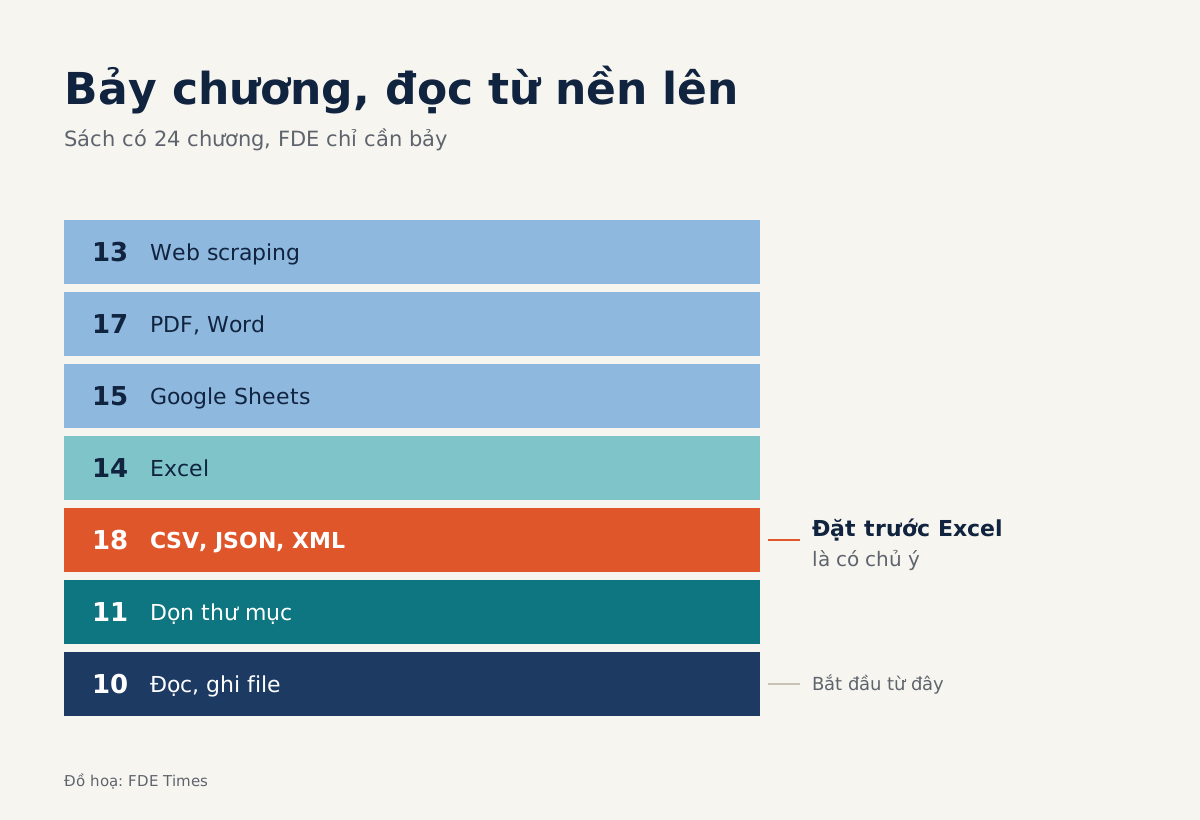
Sách của Sweigart dạy đúng phần đó, theo kiểu làm project cụ thể chứ không giảng lý thuyết. Vì vậy nên coi bảy chương dưới đây như một bộ công cụ cho tuần đầu, và đọc theo thứ tự từ nền lên.
| Chương | Nội dung chính | Việc ở chỗ khách |
|---|---|---|
| 10. Reading and Writing Files | Đường dẫn, đọc/ghi, module shelve | Đọc mọi file khách gửi, lưu trạng thái tạm |
| 11. Organizing Files | shutil, duyệt cây thư mục, zipfile | Xử lý hàng loạt thư mục khách đổ sang |
| 18. CSV, JSON, and XML | Ba định dạng văn bản, bỏ header CSV, chuyển Excel sang CSV | Chuẩn hóa dữ liệu trước khi nạp vào hệ thống |
| 14. Excel Spreadsheets | openpyxl, công thức, freeze pane, biểu đồ | Đọc và sửa báo cáo của các phòng ban |
| 15. Google Sheets | Bảng tính trên cloud | Khi khách làm việc trên Google Workspace |
| 17. PDF and Word Documents | Tài liệu văn phòng | Hợp đồng, quy trình, tài liệu cho RAG |
| 13. Web Scraping | requests, API, Beautiful Soup, Selenium, Playwright | Lấy dữ liệu từ cổng web không có export |
Chương 18 được đưa lên trước chương 14 là có chủ ý. Khi đã quen ý rằng CSV, JSON và XML chỉ là văn bản thuần, bạn sẽ thấy việc làm với Excel chủ yếu là đưa dữ liệu ra khỏi Excel.
Thử một bài toán: 40 file của 40 chi nhánh
Thử hình dung khách là một chuỗi bán lẻ, gửi sang 40 file Excel doanh số, mỗi chi nhánh một file. Họ muốn có một bảng tổng để đưa vào hệ thống phân tích. Nếu làm tay, bạn mở 40 lần, copy 40 lần, và chắc chắn sẽ sai ít nhất một lần.
Với ba chương trong sách, việc này thành một script ngắn. Chương 11 cho bạn cách duyệt cả cây thư mục để gom đủ 40 file, kể cả file nằm sâu trong thư mục con. Chương 14 dùng openpyxl để đọc từng sheet, và hai project trong chương, thống kê dữ liệu điều tra dân số và cập nhật một bảng tính, gần như đúng dạng bài toán này.
Chương 18 ghi kết quả ra một file CSV duy nhất, giống bài tập chuyển Excel sang CSV ở cuối chương. Ghép lại, phác thảo dưới đây giả định mỗi file có dòng tiêu đề ở hàng đầu và dữ liệu nằm ở sheet đang mở:
import csv, os, shutil
from pathlib import Path
import openpyxl

SRC = Path('du_lieu_khach')

# Bước 0: sao lưu nguyên trạng trước khi đụng vào bất cứ file nào
shutil.make_archive('ban_goc', 'zip', SRC)

with open('tong_hop.csv', 'w', newline='', encoding='utf-8') as out:
    writer = csv.writer(out)
    for folder, _, files in os.walk(SRC):      # chương 11: duyệt cả thư mục con
        for name in files:
            if not name.endswith('.xlsx'):
                continue
            wb = openpyxl.load_workbook(Path(folder) / name, data_only=True)  # chương 14
            ws = wb.active
            for row in ws.iter_rows(min_row=2, values_only=True):  # bỏ dòng tiêu đề
                writer.writerow([name, *row])   # chương 18: ghi thêm cột tên file
Cột tên file ở đầu mỗi dòng là chi tiết nhỏ nhưng đáng giữ. Khi khách hỏi vì sao số của một chi nhánh lệch, bạn lần ngược được ngay về file gốc thay vì mở lại cả 40 file.
Việc đầu tiên bạn nên làm ở chỗ khách không phải là viết vòng lặp. Hãy nén nguyên thư mục gốc thành một file ZIP, đúng như project sao lưu ở chương 11, rồi mới đụng vào file nào.
Ba ý đáng giữ lại
Ý đầu tiên nằm ở chương 10: Sweigart bảo hãy coi nội dung một file như một chuỗi duy nhất, có khi nặng tới hàng gigabyte. Câu này nhắc bạn hỏi khách file lớn cỡ nào trước khi đọc hết vào bộ nhớ. Một script chạy tốt trên file mẫu vẫn có thể sập khi gặp bản xuất dữ liệu cả năm.
Ý tiếp theo là sao lưu trước khi làm hàng loạt. Thao tác trên cả cây thư mục rất mạnh, nhưng cũng chính vì vậy mà dễ gây hại. Một bản ZIP giữ nguyên trạng là cách rẻ nhất để giữ được lòng tin của khách khi script chạy sai.
Ý cuối đến từ cách chương 13 sắp xếp công cụ: requests và một ví dụ dùng API đi trước, rồi mới tới Beautiful Soup, Selenium và Playwright. Ở chỗ khách, thứ tự này nên là thói quen: hỏi có API hay nút export không, sau đó mới parse HTML, và chỉ tự động hóa trình duyệt khi không còn cách nào khác.
Những lỗi hay gặp khi mang bài tập ra chỗ khách
Lỗi phổ biến nhất là thử script trên hai file mẫu rồi chạy thẳng lên bản xuất dữ liệu cả năm, đọc trọn vào bộ nhớ. Hãy hỏi kích thước và số dòng trước, rồi chạy thử trên một thư mục nhỏ.
Lỗi thứ hai là lao vào scraping một cổng web trong khi người dùng bên khách có sẵn nút export mà không ai hỏi tới. Một câu hỏi trong buổi customer discovery có thể tiết kiệm cho bạn cả tuần viết code Playwright.
Lỗi cuối là không đối chiếu kết quả. Sau khi gom 40 file, tổng số dòng trong CSV phải khớp với tổng số dòng dữ liệu của từng file; nếu không khớp, đừng gửi cho khách.
Ai nên đọc, và cách đưa nó vào CV
Nếu bạn đã viết Python hằng ngày, đọc lướt chương 10 rồi vào thẳng chương 11, 18 và 14. Nếu bạn đến từ frontend hay Java, đọc kỹ cả bảy chương theo thứ tự ở bảng trên. Chương 15 và 17 có thể để lại đến khi khách thật sự dùng Google Sheets hay có một kho hợp đồng.
Để đưa vào CV, đừng ghi “đã đọc Automate the Boring Stuff”. Hãy làm lại một bài tập trên dữ liệu công khai, đẩy lên GitHub kèm README ghi số file đã xử lý và thời gian tiết kiệm được, rồi viết thành một dòng thành tích.
Khi tin tuyển dụng FDE nhắc đến dữ liệu khách hàng lộn xộn hay hệ thống cũ, dòng đó cho nhà tuyển dụng thấy bạn đã từng làm đúng loại việc ấy.
Ở chỗ khách, người đầu tiên biến 40 file Excel thành một bảng sạch thường cũng là người được tin giao phần việc tiếp theo.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!