Machine Learning Specialization của Andrew Ng: ba khoá nhập môn, đọc bằng con mắt FDE
Bản làm lại sau 10 năm đã chuyển sang Python. Với developer muốn làm FDE, giá trị lớn nhất của khoá này là giúp bạn hiểu mô hình đủ sâu để giải thích nó với khách hàng.
Tóm tắt nhanh
- Gồm 3 khoá nhập môn của DeepLearning.AI và Stanford Online, Coursera ước tính mất 2 tháng nếu học 10 giờ/tuần
- Bản mới thiết kế lại bài giảng và bài tập bằng Python thay cho Octave của khoá gốc, gần với công cụ bạn sẽ dùng ở chỗ khách hàng
- Với FDE, khoá 1 và khoá 2 là phần cốt lõi; khoá 3 nên học có chọn lọc, ưu tiên phần recommender
Mười năm sau khi khoá Machine Learning gốc ra mắt, DeepLearning.AI thiết kế lại bài giảng và bài tập. Đội ngũ giải thích trên blog rằng lĩnh vực này đã tiến xa đáng kể kể từ ngày khoá học ra đời. Thay đổi dễ thấy nhất là bài giảng và bài tập giờ dùng Python, thay cho Octave của khoá gốc.
Chi tiết đó có vẻ nhỏ, nhưng với người muốn làm FDE thì nó quan trọng. Ở chỗ khách hàng, bạn sẽ hiếm khi gặp Octave; thứ bạn mở ra nhiều khả năng là notebook Python với NumPy, scikit-learn hay TensorFlow. Học bản mới này cũng là tập dượt luôn với những công cụ bạn sẽ dùng trong tuần đầu của một dự án.
Một chương trình nhập môn thật sự
Tên chính thức là Machine Learning Specialization, do DeepLearning.AI và Stanford Online hợp tác xây dựng, đăng trên Coursera.
Chương trình gồm 3 khoá, được Coursera xếp ở mức người mới bắt đầu, với thời lượng ước tính 2 tháng nếu học 10 giờ mỗi tuần. Nhịp đó vừa sức một developer đang đi làm toàn thời gian, miễn là bạn giữ lịch đều.
DeepLearning.AI gọi đây là chương trình ba khoá thân thiện với người mới. Họ cũng nói rõ là không cần nền toán nặng: điều quan trọng nhất là bạn muốn học AI và ML, còn lại họ sẽ cùng bạn bù dần. Với một developer đã lâu không đụng tới đại số tuyến tính, đây là lối vào ít ma sát nhất.
Đi theo thứ tự nào?
Cứ học theo đúng thứ tự 1, 2, 3, nhưng đừng chia thời gian đều cho cả ba. Khoá 1 dạy xây mô hình ML bằng NumPy và scikit-learn. Khoá 2 dạy huấn luyện mạng nơ-ron bằng TensorFlow cho bài toán phân loại đa lớp.
Khoá 3 mang tên Unsupervised Learning, Recommenders, Reinforcement Learning, trong đó có phần xây mô hình học tăng cường sâu. Nếu mục tiêu là FDE, nên dồn phần lớn thời gian vào khoá 1 và 2.
Ở khoá 3, phần recommender đáng học kỹ vì bài toán gợi ý là yêu cầu quen thuộc ở các doanh nghiệp thương mại; học tăng cường thì cứ nắm khái niệm, đừng sa lầy.
Phần NumPy là chỗ không nên đi tắt
Khoá 1 dùng cả NumPy lẫn scikit-learn. Lời khuyên là đừng lướt qua phần NumPy để đến thẳng thư viện: chính những dòng tính toán thủ công đó giúp bạn hiểu mô hình làm gì bên trong. Khi khách hỏi vì sao mô hình đưa ra dự đoán này, bạn cần trả lời bằng cơ chế, chứ không phải bằng tên hàm.
Còn scikit-learn là thứ giúp bạn có kết quả nhanh. Việc nên làm đầu tiên ở khách hàng là dựng một baseline ngay trong buổi chiều đầu tiên, làm mốc để mọi đề xuất phức tạp hơn phải vượt qua.
Accuracy 70% có thể chẳng nói lên điều gì
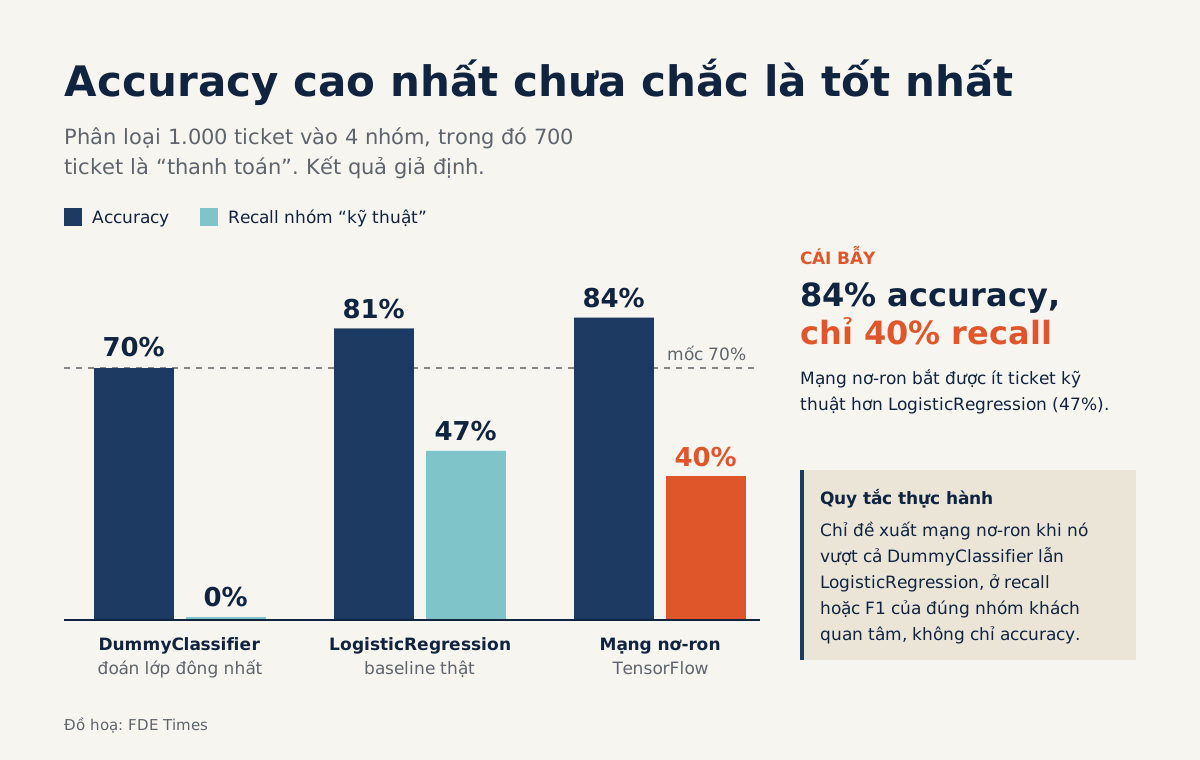
Khoá 2 dạy phân loại đa lớp bằng TensorFlow, một dạng bài toán rất hay gặp khi đi triển khai. Thử hình dung một công ty cần tự động phân loại 1.000 ticket hỗ trợ vào 4 nhóm, trong đó 700 ticket thuộc nhóm “thanh toán”.
Một mô hình lười, ticket nào cũng đoán là “thanh toán”, vẫn đạt 70% accuracy mà không phân loại đúng nổi một ticket kỹ thuật nào. Trong scikit-learn, bạn dựng mô hình lười đó, một baseline thật bằng logistic regression, và in recall của từng nhóm chỉ với vài dòng:
from sklearn.dummy import DummyClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report

lazy = DummyClassifier(strategy="most_frequent").fit(X_train, y_train)
print(lazy.score(X_test, y_test))   # ~0.70: vạch xuất phát

model = LogisticRegression(max_iter=1000).fit(X_train, y_train)
print(classification_report(y_test, model.predict(X_test)))  # recall, F1 từng nhóm
Bảng dưới là một kết quả giả định để thấy cái bẫy. Mạng nơ-ron có accuracy cao nhất, nhưng lại bắt được ít ticket kỹ thuật hơn logistic regression.
| Mô hình (giả định) | Accuracy | Recall nhóm “thanh toán” | Recall nhóm “kỹ thuật” |
|---|---|---|---|
| DummyClassifier (đoán lớp đông nhất) | 70% | 100% | 0% |
| LogisticRegression | 81% | 93% | 47% |
| Mạng nơ-ron TensorFlow | 84% | 97% | 40% |
Nếu khách cần ticket kỹ thuật được chuyển đúng người, mạng nơ-ron trong bảng này là lựa chọn tệ hơn, dù con số accuracy đẹp hơn. Vì thế, câu hỏi FDE phải đặt trước tiên là phân bố giữa các lớp ra sao, và khách thực sự cần đúng ở nhóm nào.
Quy tắc thực hành: chỉ đề xuất mạng nơ-ron khi nó vượt cả DummyClassifier lẫn LogisticRegression, không chỉ ở accuracy mà ở recall hoặc F1 của đúng nhóm khách quan tâm. Khoá học cho bạn công cụ để huấn luyện mạng; bảng so sánh này là phần việc của bạn.
Recommender là bài toán khách hàng hay mang tới
Phần recommender ở khoá 3 nối lý thuyết với những yêu cầu kiểu “gợi ý sản phẩm cho người dùng” mà FDE dễ gặp.
Việc đầu tiên khi gặp yêu cầu gợi ý là xin xem dữ liệu tương tác thật, trước khi hứa hẹn bất cứ mô hình nào.
Ai nên học, và đưa nó vào CV thế nào?
Khoá này hợp với backend hay full-stack developer muốn chuyển sang FDE mà chưa từng huấn luyện mô hình nào. Người đã làm ML vài năm thì chỉ cần lướt qua. Đừng ghi chứng chỉ trơn trọi vào CV.
Thay vào đó, hãy viết một dòng như “Phân loại 4 nhóm ticket bằng TensorFlow, so với baseline scikit-learn”, kèm accuracy và recall của nhóm quan trọng nhất. Dòng đó cho thấy bạn không chỉ chạy được mô hình mà còn biết đánh giá nó so với một mốc tối thiểu.
Khoá học không biến bạn thành nhà khoa học dữ liệu. Nó cho bạn đủ nền để không lúng túng khi ngồi với khách, và với một FDE thì đó đã là lợi thế lớn.