Khoá AI evals lớn nhất Maven dạy đọc output trước khi dạy công cụ
Hamel Husain và Shreya Shankar cho rằng tiêu chí eval chỉ lộ ra khi con người chấm output, nên FDE phải tự tìm; cái giá là học phí 4.200 USD.
Tóm tắt nhanh
- Khoá 'AI Evals For Engineers & PMs' trên Maven dạy vòng lặp: xây agent thật, tìm chỗ hỏng, sửa bằng evals đáng tin
- Quan điểm cốt lõi: error analysis là hoạt động quan trọng nhất; tiêu chí eval xuất hiện khi con người chấm output, không định sẵn từ trước
- Không dành cho người mới; đọc Field Guide và FAQ miễn phí trên hamel.dev trước, chỉ trả tiền khi đã có sản phẩm đang chạy
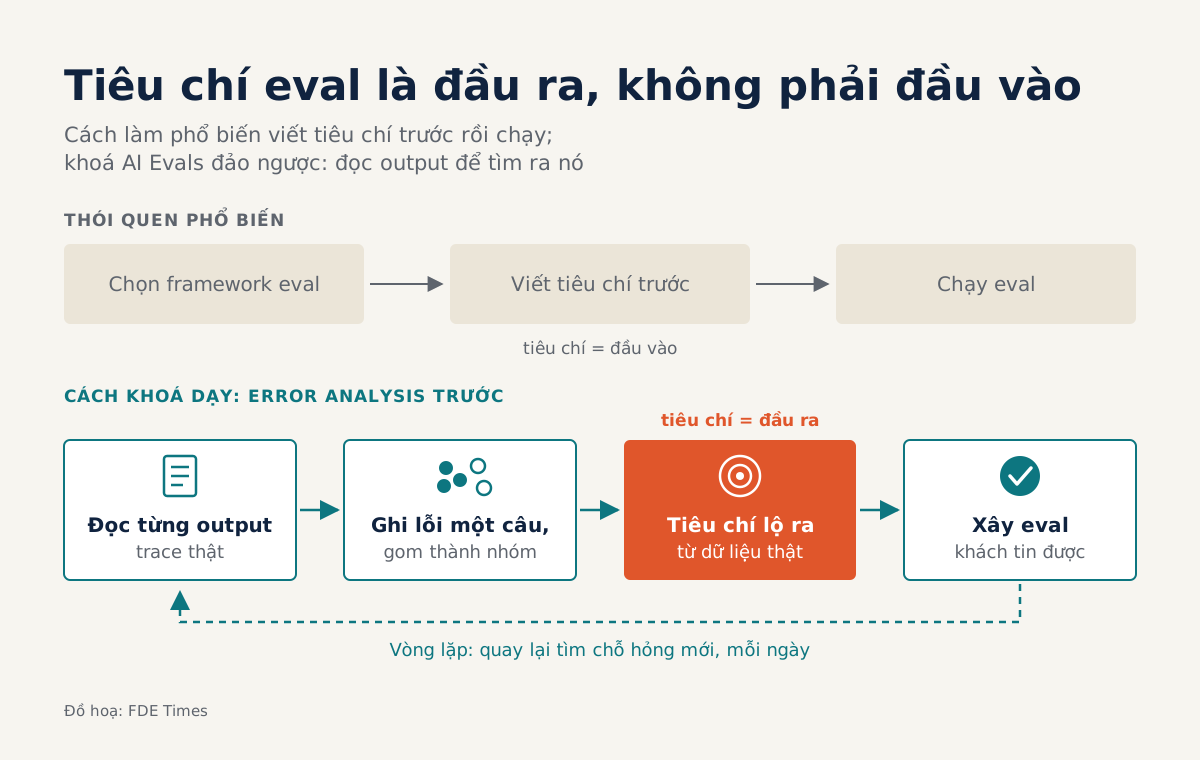
Khoá học có doanh thu cao nhất trên Maven không bán công cụ. Hamel Husain và Shreya Shankar, sau khi dạy hơn 5.000 kỹ sư và PM, chốt lại trong FAQ chính thức một câu rất ngắn: error analysis là hoạt động quan trọng nhất trong evals. Không phải dashboard, không phải LLM-as-judge, mà là việc ngồi đọc từng output của model.
Với người muốn làm FDE, đây là chi tiết đáng chú ý nhất. Hamel viết trong Field Guide rằng không thể xác định hoàn toàn tiêu chí đánh giá trước khi con người chấm output của LLM. Nếu điều đó đúng, người triển khai agent cho khách hàng không thể ngồi chờ khách đưa sẵn tiêu chí; họ phải tự đọc output để tìm ra nó.
Kỹ năng tìm ra agent hỏng ở đâu, rồi biến phát hiện đó thành bộ eval khách tin được, chính là thứ khoá này rèn.
Khoá học thực chất dạy gì
Tên đầy đủ là “AI Evals For Engineers & PMs”, dạy trực tiếp theo cohort trên Maven. Hamel Husain giới thiệu mình là ML engineer hơn 20 năm kinh nghiệm; Shreya Shankar là tiến sĩ EECS tại UC Berkeley và sẽ về CMU giảng dạy năm 2027. Khoá đã có hơn 5.000 học viên từ hơn 500 công ty, điểm đánh giá 4.7 trên 1.011 lượt.
Lời hứa của khoá gói trong một vòng lặp: xây một AI agent thật, tìm chỗ nó hỏng, rồi cải thiện bằng evals đáng tin. Học viên nhận khoá đọc hơn 200 trang, 4 bài tập có lời giải kèm walkthrough, hơn 10 buổi office hour và Discord trọn đời.
Bản ghi giữ vĩnh viễn, và bạn có thể học lại bất kỳ cohort nào sau này mà không trả thêm.
Học phí niêm yết 4.200 USD, một con số không nhỏ với kỹ sư Việt Nam. Vì thế câu hỏi đáng giá hơn là nó có đáng với bạn không, và câu trả lời phụ thuộc vào việc bạn đã có sản phẩm đang chạy hay chưa.
Vì sao “nhìn dữ liệu” lại phải đi học
Nghe thì hiển nhiên. Nhưng cách làm phổ biến là ngược lại: chọn framework eval trước, viết tiêu chí trước, rồi chạy. Hamel, trong Field Guide về cải thiện nhanh sản phẩm AI, nói thẳng rằng không gì thay thế được insight thu được từ việc xem ví dụ thật.
Ghép ý đó với luận điểm tiêu chí chỉ lộ ra khi con người chấm output, bạn có một cách nghĩ đảo ngược so với thói quen của nhiều kỹ sư. Tiêu chí không phải đầu vào của evals; nó là đầu ra của error analysis.
Thử hình dung bạn là FDE triển khai agent trả lời ticket cho một công ty logistics. Trước khi đọc trace, bạn đoán lỗi chính là hallucination. Sau khi đọc, có thể thấy agent trả lời đúng nhưng sai giọng, hoặc bỏ qua một trường trong hệ thống nội bộ của khách. Những lỗi ấy không nằm trong benchmark nào; chúng chỉ lộ ra khi có người ngồi đọc.
Ai nên học, và học theo thứ tự nào
Trang khoá nói rõ: đây là deep dive, không phải nhập môn LLM hay prompt engineering, nên tốt nhất là bạn đang xây một thứ gì đó. Nếu chưa có agent nào chạy với người dùng thật, hãy để dành tiền. Bài tập sẽ không có đất để áp dụng, và office hour sẽ thành buổi nghe người khác hỏi.
Thứ tự hợp lý là đọc miễn phí trước, trả tiền sau. Field Guide và AI Evals FAQ trên hamel.dev cho thấy những ý cốt lõi, đủ để bạn quyết định; riêng FAQ, theo chính hai tác giả, gom lại những câu hỏi họ nhận nhiều nhất khi dạy hơn 5.000 kỹ sư và PM.
Nếu đọc xong mà bạn vẫn cần ai đó dẫn qua từng bài tập và một cộng đồng để hỏi, lúc đó khoá mới đáng tiền.
Với FDE, giá trị thêm nằm ở chữ “PMs” trong tên khoá. Bạn học cạnh người ra quyết định sản phẩm, tức là tập nói về evals bằng ngôn ngữ họ hiểu, thứ bạn sẽ phải làm hàng tuần trước khách hàng.
Mang gì về, và viết gì vào CV
Điểm còn lại đáng giữ là vòng lặp phải khép kín. Lời hứa của khoá không dừng ở “tìm chỗ hỏng” mà đi tiếp sang “cải thiện bằng evals”, rồi quay lại tìm chỗ hỏng mới. Evals vì thế không phải cổng kiểm tra cuối dự án mà là nhịp làm việc hằng ngày.
Để thể hiện kỹ năng này trong CV, đừng viết “có kinh nghiệm với evals”. Hãy viết bạn đã đọc bao nhiêu trace, phân loại ra bao nhiêu nhóm lỗi, và eval bạn xây đã bắt được nhóm nào. Một dòng như thế nói nhiều hơn bất kỳ tên framework nào.
Tiền học có thể để sau. Thói quen ngồi đọc output thì nên bắt đầu từ tuần này, vì đó mới là thứ khách hàng trả tiền để có.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!