Building Systems with the ChatGPT API: ba ý đáng giữ cho FDE
Một buổi tối đủ để học cách chia nhỏ và kiểm tra hệ thống LLM, nhưng chưa đủ để bạn tự tin đặt nó trước dữ liệu thật của khách hàng.

Tóm tắt nhanh
- Giá trị lớn nhất của khoá là tư duy chia việc thành các bước có thể kiểm tra, không phải đoạn code cụ thể.
- Chuỗi prompt chỉ hợp khi việc tách được gọn thành các bước cố định; phần kiểm duyệt cần đối chiếu với tài liệu hiện hành của OpenAI.
- Học xong vẫn phải bổ sung assertion và thói quen đọc dữ liệu thật để sẵn sàng cho production.
Bài đáng giá nhất của khoá này chỉ dài 19 phút. Nó nằm trong một khoá mà trang giới thiệu ghi tổng thời lượng 1 giờ 55 phút và chỉ đòi hỏi Python cơ bản.
Building Systems with the ChatGPT API là khoá ngắn của DeepLearning.AI, do Isa Fulford, Member of Technical Staff tại OpenAI, và Andrew Ng dạy. Khoá dành cho người mới, gồm 11 video, 9 ví dụ code và một bài quiz chấm điểm, được cập nhật ngày 14/10/2025.
Nếu bạn đã đi làm vài năm, phần code sẽ không làm bạn khó. Lý do đáng học là khoá cho bạn một cách nghĩ về hệ thống LLM mà FDE dùng được ngay ở khách hàng. Nên xem nó trong một buổi tối, giữ lại ba ý dưới đây, và đừng coi đó là tấm vé vào production.
Chia nhỏ để biết hệ thống hỏng ở đâu
Ý đầu tiên cũng là điều khoá cam kết dạy: tự động hoá luồng việc phức tạp bằng cách nối nhiều lần gọi model, tách nhiệm vụ lớn thành một chuỗi việc con.
Bài Chaining Prompts 19 phút dạy đúng kỹ thuật đó. Anthropic mô tả cùng mẫu thiết kế này trong Building effective agents: mỗi lần gọi LLM xử lý đầu ra của lần gọi trước.
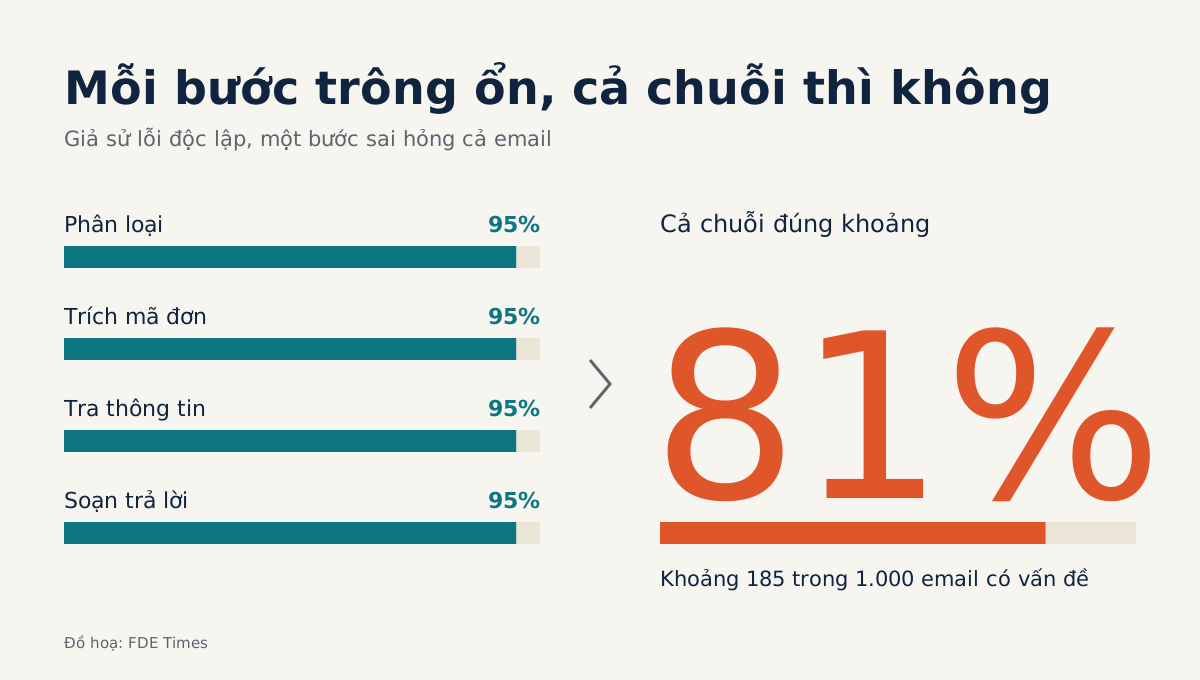
Thử hình dung một công ty logistics muốn tự động trả lời email khiếu nại. Một prompt khổng lồ có thể làm tất cả, nhưng khi nó sai, bạn không biết sai vì đọc nhầm mã đơn hay vì soạn sai chính sách. Tách thành bốn bước (phân loại, trích mã đơn, tra thông tin, soạn trả lời) thì bạn đo được từng bước.
Việc đo này quan trọng vì lỗi cộng dồn rất nhanh. Giả sử mỗi bước đúng 95%, lỗi độc lập và một bước sai làm hỏng cả email: cả chuỗi chỉ đúng 0,95⁴, tức khoảng 81%. Trong 1.000 email, khoảng 185 email sẽ có vấn đề, dù từng bước riêng lẻ trông rất ổn.
Khi nào chuỗi prompt là lựa chọn sai?
Khoá dạy kỹ thuật, nhưng ở hiện trường, câu hỏi khó hơn là có nên dùng nó không. Anthropic nêu điều kiện khá rõ: mẫu này hợp nhất khi việc có thể tách gọn gàng thành các bước con cố định. Công việc của khách hàng thường không ngoan như vậy.
Quay lại công ty logistics: nếu khiếu nại về giao trễ luôn đi qua bốn bước trên, chuỗi cố định là đủ. Nhưng nếu một email vừa đòi hoàn tiền, vừa hỏi hợp đồng, vừa đính kèm ảnh hàng vỡ, thứ tự bước phải đổi theo từng trường hợp và chuỗi cứng bắt đầu gãy.
Trước khi xây, hãy lấy 20 email thật và tự viết tay các bước cần làm cho từng email. Nếu các danh sách gần như giống nhau, cứ dùng chuỗi prompt.
Nếu mỗi email một kiểu, đừng ép tất cả vào một chuỗi. Hãy giữ bước phân loại ở đầu rồi rẽ sang các chuỗi ngắn, mỗi chuỗi cho một nhóm việc cố định như giao trễ, hoàn tiền, hợp đồng. Email nhiều yêu cầu thì tách thành từng yêu cầu, rồi đưa mỗi yêu cầu vào nhánh của nó.
Phần không khớp nhánh nào thì chuyển cho nhân viên và ghi lại, đừng để model đoán. Giả sử 15 trong 20 email khớp ba nhánh: bạn tự động được 75%, mỗi nhánh vẫn đo riêng được, và 5 email còn lại cho biết nên thêm nhánh nào. Hãy nói con số đó với khách hàng trước khi cam kết tiến độ.
Kiểm soát cả đầu vào lẫn đầu ra, nhưng đừng chép nguyên chi tiết
Ý thứ hai nằm ngay trong cấu trúc khoá: Moderation và Check Outputs là hai bài riêng. Với một kỹ sư, thông điệp đáng giữ là kiểm soát phải là một bước của hệ thống, ở cả đầu vào lẫn đầu ra, chứ không phải một câu dặn dò nhét trong prompt.
Chi tiết kỹ thuật của bài Moderation thì đã cũ, nên hãy giữ ý và đừng chép nguyên cách làm. Trước khi viết code, đọc tài liệu moderation hiện hành của OpenAI: endpoint này miễn phí, model omni-moderation-latest nhận cả văn bản lẫn hình ảnh, và tệp ảnh có thể tới 20 MB.
Nếu luồng của khách hàng có ảnh, như ảnh hàng vỡ ở ví dụ trên, ảnh cũng phải được tính đến khi bạn thiết kế bước kiểm duyệt.
Moderation cũng không thay được kiểm tra nghiệp vụ, vì nó không biết chính sách hoàn tiền của khách hàng. Buổi làm việc đầu tiên, hãy hỏi họ hai câu: dữ liệu nào được phép gửi ra API bên ngoài, và câu trả lời sai kiểu nào gây thiệt hại nặng nhất. Câu thứ hai chính là đề bài cho bước kiểm tra đầu ra.
Đánh giá là chỗ khoá dừng lại quá sớm
Ý thứ ba là đánh giá phải được làm như một phần việc riêng. Khoá dành hẳn một cụm ba phần cho Evaluation, và đó là tín hiệu đúng. Nhưng cụm này dừng ở bộ test cố định của một khoá ngắn: nó không chạm tới đầu ra thật của hệ thống sau deployment ở khách hàng.
Hamel Husain, trong Your AI Product Needs Evals, nhắc thêm hai việc nên làm. Việc đầu dễ bắt tay ngay: unit test cho LLM theo ông chỉ là các assertion như bạn vẫn viết trong pytest, chạy nhanh và rẻ.
Với hệ thống email, assertion có thể là: mã đơn trong câu trả lời phải có trong dữ liệu tra được, và chỉ được nhắc đến hoàn tiền khi email được phân loại đúng nhóm đó.
Việc thứ hai khó hơn, vì đó là thói quen phải giữ đều chứ không phải đoạn code viết một lần. Husain viết rằng không bao giờ được ngừng nhìn vào dữ liệu, và việc này không có đường tắt. Ở khách hàng, hãy đặt lịch đọc đầu ra thật hằng tuần trong những tuần đầu sau deployment; mỗi lỗi mới tìm thấy trở thành một assertion mới.
Học theo thứ tự nào, và bỏ gì?
Khoá này tiếp nối ChatGPT Prompt Engineering for Developers, nhưng khoá trước không bắt buộc. Nếu bạn đã viết prompt cho sản phẩm thật, cứ vào thẳng; nếu chưa từng gọi API của LLM, học khoá trước rồi mới sang khoá này sẽ dễ hơn.
Khoá hợp nhất với kỹ sư đang chuẩn bị chuyển sang FDE. Khi vào khoá, hãy học theo bảng dưới: nối các bước trước, rồi chặn lỗi ở đầu vào và đầu ra, rồi đánh giá.
Có chuỗi bước mới biết cần chặn ở đâu, và có cả hệ thống hoàn chỉnh mới có thứ để đánh giá. Nếu đã vận hành hệ thống LLM, bạn có thể bỏ phần còn lại và chỉ xem cụm Evaluation.
| Thứ tự | Phần trong khoá | Cách học | Dùng ở khách hàng |
|---|---|---|---|
| 1 | Chaining Prompts | Học kỹ, tự chạy code | Vẽ luồng việc thành các bước đo được |
| 2 | Moderation | Lấy ý, đọc tài liệu hiện hành | Đặt bước kiểm duyệt đầu vào |
| 3 | Check Outputs | Học kỹ | Viết luật chặn lỗi đắt giá nhất |
| 4 | Evaluation (ba phần) | Học kỹ, thêm assertion | Dựng bộ test từ dữ liệu thật |
| 5 | Chain of Thought Reasoning | Xem nhanh | Thử khi một bước cần suy luận trước khi trả lời |
Trong CV, đừng dừng ở tên khoá học. Hãy làm một dự án nhỏ trên dữ liệu công khai rồi viết rõ: tách luồng thành mấy bước, độ chính xác từng bước, assertion nào đã bắt được lỗi gì.
Khi đọc mô tả công việc FDE, hãy để ý hai từ “evals” và “production”. Nếu tin tuyển dụng nhắc đến chúng, dự án nhỏ này là ví dụ bạn nên kể khi phỏng vấn.
Khoá dạy bạn nối các bước lại với nhau. Việc của FDE bắt đầu từ email đầu tiên mà chuỗi bước ấy không lường trước.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
4 nguồn
- Building Systems with the ChatGPT API – DeepLearning.AI · 2025-10-14
- Building effective agents · 2024-12-19
- Moderation – OpenAI API docs
- Your AI Product Needs Evals · 2024-03-29