Rob Zuber cho rằng kiểm thử LLM đã có sẵn 90% công cụ
Khoá học một giờ của ông minh hoạ luận điểm đó khá thuyết phục, nhưng 10% còn thiếu thường nằm ở phía khách hàng.
Tóm tắt nhanh
- Khoá học cấp độ beginner, dài khoảng một giờ, do Rob Zuber (CTO CircleCI) dạy, ra mắt tháng 1/2024.
- Giá trị cốt lõi là coi eval LLM như test trong CI, gồm kiểm tra bằng luật nhanh và kiểm tra do model chấm.
- Phần công cụ gắn chặt với CircleCI; FDE nên giữ tư duy, thay công cụ bằng CI của khách hàng và bổ sung phản hồi người dùng.
Rob Zuber, CTO của CircleCI, có một nhận định khá táo bạo về chuyện kiểm thử ứng dụng LLM: theo ông, chúng ta đã có sẵn 90% công cụ và phương pháp cần thiết. Với ông, CI/CD vốn phù hợp tự nhiên với việc test các ứng dụng chạy bằng LLM. Đây là một bước tiến hoá của nghề cũ, không phải một ngành mới.
Đó cũng là luận điểm của Automated Testing for LLMOps, khoá học ngắn do Zuber dạy, được DeepLearning.AI xây dựng cùng CircleCI và công bố vào tháng 1/2024. Khoá học ở cấp độ beginner và dài khoảng một giờ. Mục tiêu chính của nó là giúp bạn dựng một workflow CI để đánh giá ứng dụng LLM.
Với FDE, đây là một giờ đáng bỏ ra. Khi đã đưa agent hay RAG của khách hàng lên production, câu bạn sẽ nghe thường xuyên nhất là “sao bạn chắc lần sửa prompt này không làm hỏng chỗ khác?”. Khoá học cho bạn cách trả lời bằng một pipeline thay vì bằng lời hứa.
Khoá học dạy gì trong một giờ?
Giáo trình gọn: phần giới thiệu, nhập môn CI, tổng quan về eval tự động, model-graded eval, một khung kiểm thử tổng hợp, phần kết, bài quiz và một phần tuỳ chọn đi qua file cấu hình CircleCI. Ai cũng đăng ký học được, nhưng muốn làm bài tập có chấm điểm thì phải có tài khoản PRO.
Đối tượng là người biết Python cơ bản và đã từng dựng ứng dụng dựa trên LLM. Nếu bạn chưa gọi API của một model nào, hãy làm một ứng dụng nhỏ trước, vì khoá học mặc định là bạn đã có thứ để test.
Nội dung xoay quanh những lỗi quen thuộc của LLM: hallucination, data drift và đầu ra độc hại hoặc xúc phạm. Khoá học xuất phát từ một nhận xét đơn giản: LLM hành xử khó đoán hơn phần mềm truyền thống.
Ý thứ nhất: hai loại eval, hai nhịp chạy
Ý đáng giữ nhất là cách khoá học tách eval làm hai loại. Rule-based eval so khớp chuỗi hoặc mẫu, chẳng hạn bằng regular expression, và chạy rất nhanh. Model-graded eval dành cho những bài toán có nhiều đầu ra tốt hoặc xấu đều hợp lệ, và khoá học dùng chúng để phát hiện hallucination.
Thử hình dung bạn đang deploy một bot trả lời về chính sách hoàn tiền cho một hãng bán lẻ. Rule-based eval kiểm tra những gì đo được bằng máy: đầu ra là JSON hợp lệ, mã đơn hàng đúng định dạng, không bao giờ lộ email nội bộ.
Model-graded eval trả lời câu mà regex chịu thua: bot có tự nghĩ ra điều khoản “hoàn tiền trong 60 ngày” không có trong tài liệu chính sách hay không.
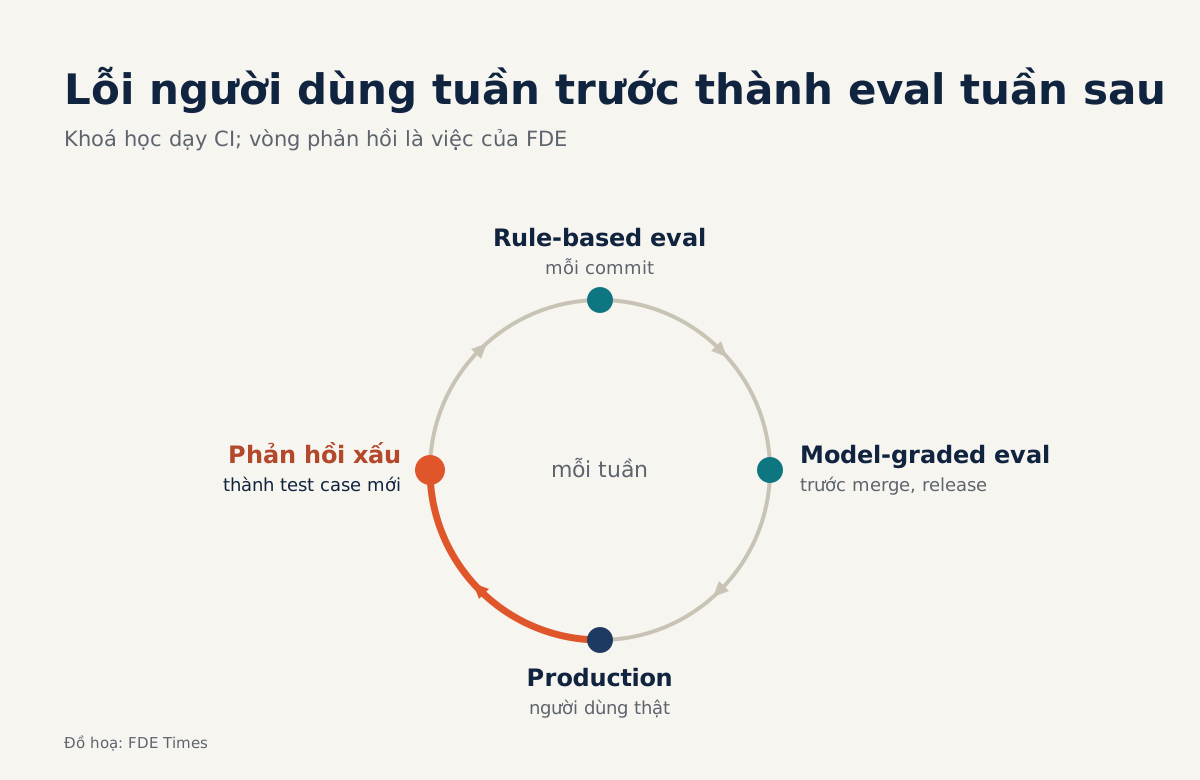
Từ đó suy ra cách bố trí thực tế: loại rẻ và nhanh chạy trên mỗi commit, loại đắt và chậm chạy ở những điểm quan trọng hơn như trước khi merge hay release. Đây là lời khuyên vận hành, khoá học không quy định như vậy, nhưng nó đi theo đúng bản chất của hai loại eval mà khoá học mô tả.
Ý thứ hai: eval là test, nên nó thuộc về CI
Ý thứ hai nằm ở cách nhìn của Zuber. Nếu eval chỉ là một notebook ai đó thỉnh thoảng mở ra chạy, nó sẽ bị bỏ quên ngay sau tuần đầu ở chỗ khách hàng. Đưa eval vào CI biến chất lượng câu trả lời thành một cổng chặn giống unit test: không đạt thì không merge.
Đây là ngôn ngữ mà đội kỹ thuật của khách hàng hiểu ngay. Bạn không cần thuyết phục họ áp dụng một quy trình “LLMOps” xa lạ. Bạn chỉ thêm vài job vào pipeline họ đang chạy.
Ý thứ ba, và những gì nên bỏ
Ý thứ ba thì khoá học chỉ chạm tới, còn kinh nghiệm production của chính CircleCI nói rõ hơn. Theo những người làm ở CircleCI, tính bất định là thách thức chính, không có eval đơn lẻ nào hoàn hảo nên phải kết hợp nhiều loại.
Họ cũng khuyên gắn công cụ ghi nhận phản hồi của người dùng vào ứng dụng, rồi đưa những phản hồi đó trở lại bộ eval.
Một khoá học chỉ nói về CI sẽ không dạy vòng lặp đó, nhưng đây lại là phần FDE phải làm ở hiện trường. Những ca bot trả lời sai mà người dùng thật bấm 👎 nên trở thành test case mới trong bộ eval của tuần sau.
Thứ nên bỏ lại là phần công cụ. Cả hai loại eval trong khoá học đều chạy tự động trên CI của CircleCI, trong khi khách hàng của bạn có thể dùng thứ khác.
Vì thế, hãy giữ tư duy và tự viết lại cấu hình. Một bài tập cụ thể với GitHub Actions: tạo job thứ nhất chạy các rule-based eval trên mỗi lần push, và job thứ hai chỉ chạy khi có pull request vào nhánh chính, khai báo phụ thuộc vào job thứ nhất rồi gọi model chấm trên một bộ câu hỏi cố định.
Cuối cùng, bật branch protection để cả hai job phải xanh thì mới merge được.
Ai nên học, và học theo thứ tự nào?
Nếu bạn là software engineer đã viết CI nhưng chưa từng eval LLM, đây là cửa vào vừa vặn: học khoá này trước, rồi mới tìm tài liệu sâu hơn về LLM-as-judge. Nếu bạn đã là FDE và đang chạy eval bằng tay, hãy bỏ qua phần nhập môn CI và đi thẳng vào model-graded eval cùng khung kiểm thử tổng hợp.
Về hồ sơ, đừng ghi “hoàn thành khoá Automated Testing for LLMOps”. Hãy ghi một câu có kết quả, kiểu “dựng pipeline CI chạy rule-based và model-graded eval cho ứng dụng RAG, chặn merge khi tỷ lệ hallucination vượt ngưỡng”, kèm link repo.
Khi đọc tin tuyển dụng FDE có nhắc tới “evals” hoặc “LLM testing” bên cạnh “CI/CD”, hãy chuẩn bị sẵn một pipeline như vậy để kể lại cụ thể nếu được hỏi.
Zuber có thể đúng về con số 90%. Nhưng ở chỗ khách hàng, 10% còn thiếu thường quyết định bạn có được giao thêm việc hay không.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!