Thomson Reuters tuyển FDE cho CoCounsel: cấp nào cũng phải chấm điểm LLM, cấp Senior cần nền luật
Các tin tuyển FDE cho CoCounsel vẫn giao việc dựng RAG và agent, nhưng coi việc chứng minh đầu ra đạt chuẩn của luật sư quan trọng không kém.

Tóm tắt nhanh
- Tin tuyển Senior cho đội CoCounsel FDE trên Dice yêu cầu bằng JD, đào tạo luật chính quy hoặc kinh nghiệm tương đương trong môi trường hành nghề luật.
- Cả cấp mid-level lẫn Senior đều phải dựng RAG và agent, đồng thời đánh giá đầu ra LLM về độ chính xác pháp lý, trích dẫn và hallucination.
- Muốn chuẩn bị, bạn nên dựng một hệ thống RAG có bộ eval riêng cho một ngành, chứ đừng chỉ làm thêm một bản demo chatbot.
Trong tin tuyển Senior Software Engineer cho đội CoCounsel Forward Deployed Engineering đăng trên Dice, Thomson Reuters ghi một yêu cầu khác thường với một vị trí kỹ sư phần mềm: ứng viên cần bằng JD, được đào tạo luật chính quy, hoặc có kinh nghiệm sâu tương đương trong môi trường hành nghề luật. Họ tuyển kỹ sư phần mềm, nhưng lại hỏi về trường luật.
Yêu cầu này có lý do. Cũng tin đó giao cho người được nhận việc đánh giá đầu ra AI vốn không tất định, xét theo độ chính xác pháp lý, mức độ liên quan và độ tin cậy. Muốn phán xét một câu trả lời pháp lý là đúng hay sai, bạn phải biết luật sư nhìn nó thế nào.
Khi FDE đi sâu vào từng ngành, gọi được API của một mô hình lớn chưa đủ để nổi bật. Bạn còn phải chứng minh đầu ra đúng theo cách người trong ngành đánh giá, tức là viết eval, và việc đó nặng ngang việc dựng pipeline.
Pipeline vẫn là việc chính, eval đi cùng từ cấp đầu
Đội CoCounsel FDE đăng tin ở hai cấp. Tin mid-level đặt việc xây và vận hành RAG pipeline, agentic workflow và các hệ AI nhiều thành phần vào danh sách trách nhiệm. Tin Senior trên Built In NYC, đã gỡ ngày 20/8/2026, cũng giao việc dựng RAG pipeline và agent.
Nhưng ngay dưới phần xây dựng là phần đánh giá. Đọc các tin cạnh nhau, bạn sẽ thấy eval không phải đặc quyền của cấp cao.
| Khía cạnh | Mid-level | Senior (Built In NYC) | Senior Legal (Dice) |
|---|---|---|---|
| Xây dựng | RAG, agentic workflow, hệ AI nhiều thành phần | RAG pipeline và agent | — |
| Vai trò với eval | Giúp đánh giá đầu ra LLM | Dẫn dắt việc đánh giá LLM | Đánh giá đầu ra AI không tất định |
| Tiêu chí chấm | Độ chính xác pháp lý, liên quan, trích dẫn, nhất quán, hallucination | Chất lượng đầu ra, rủi ro hallucination | Độ chính xác pháp lý, liên quan, độ tin cậy |
| Yêu cầu riêng | — | — | JD, đào tạo luật chính quy hoặc kinh nghiệm tương đương |
Ở cấp mid-level, eval đã có mặt với danh sách tiêu chí chi tiết nhất trong cả ba tin. Lên Senior, động từ đổi từ “giúp” sang “dẫn dắt”, kèm việc benchmark chất lượng đầu ra và đo rủi ro hallucination.
Nói cách khác, càng lên cao, eval càng chuyển từ việc bạn làm thành việc bạn chịu trách nhiệm. Pipeline không biến mất ở cấp nào cả.
Vì sao chấm điểm AI pháp lý lại khó?
Thomson Reuters tự giải thích điều này trong một bài viết năm 2024 về benchmark CoCounsel. Benchmark truyền thống dùng câu hỏi trắc nghiệm hoặc đúng/sai, và theo công ty, cách đó không đủ để đánh giá những tác vụ mở mà luật sư gặp hằng ngày.
Khó hơn nữa, “đúng” đôi khi phụ thuộc vào sở thích. Bài viết nêu rằng hai cách trả lời có thể đều không sai, chỉ khác nhau ở cái người dùng thích, và điều đó khiến việc tự động hóa eval một cách nhất quán trở nên khó.
Năm 2026, khi giới thiệu CoCoBench, Thomson Reuters chốt thước đo: mọi đầu ra được chấm theo mức mà một luật sư hành nghề coi là chấp nhận được. Công ty cũng ghi nhận rằng hệ thống tối ưu cho benchmark tổng quát thường gặp khó khi bị chấm trên quy trình làm việc thật.
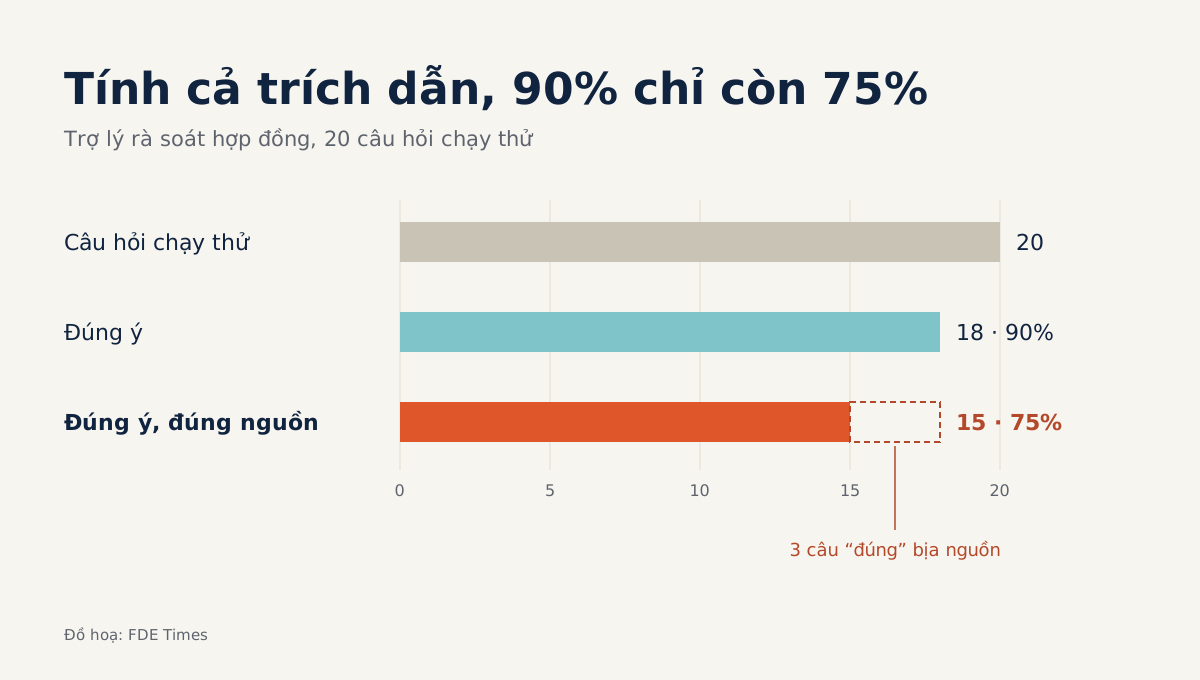
Hãy thử hình dung một ví dụ. Bạn xây trợ lý rà soát hợp đồng cho một hãng luật và chạy thử 20 câu hỏi. Có 18 câu trả lời đúng ý, nên nếu chỉ chấm “đúng hay sai”, hệ thống đạt 90%.
Nhưng khi kiểm từng trích dẫn, bạn phát hiện 3 câu trả lời “đúng” dẫn tới những điều khoản không có trong hợp đồng. Tính cả trích dẫn, chỉ còn 15 câu vừa đúng ý vừa dẫn đúng nguồn, tức 75%.
Luật sư sẽ không nhìn con số 90%. Họ sẽ thấy cứ khoảng bảy câu thì có một câu bịa nguồn, và họ hết tin công cụ.
Ví dụ này giúp hiểu vì sao việc tin mid-level liệt kê chất lượng trích dẫn và rủi ro hallucination thành tiêu chí riêng, bên cạnh độ chính xác pháp lý, là hợp lý: gộp chung, lỗi bịa nguồn dễ bị che sau một con số đẹp.
Ví dụ trên còn một tầng nữa. Thomson Reuters nhấn mạnh rằng nếu khâu retrieval ban đầu kém, hiệu năng của LLM sẽ bị kéo xuống theo. Vì thế, với 3 câu bịa nguồn, việc đầu tiên nên làm là kiểm xem retrieval có kéo về đúng điều khoản không, trước khi đổ lỗi cho mô hình.
Bài học dùng được ở bất kỳ khách hàng nào. Trước khi tối ưu prompt hay đổi mô hình, hãy cùng người trong ngành chốt xem lỗi nào là không chấp nhận được, rồi biến từng loại lỗi thành một chỉ số đo riêng, tách cho cả retrieval lẫn câu trả lời.
Không có bằng luật thì còn cơ hội không?
Yêu cầu nền pháp lý nằm trong tin Senior, và câu chữ có chữ “hoặc”: JD, đào tạo luật chính quy, hoặc kinh nghiệm sâu tương đương trong môi trường hành nghề luật. Cửa không đóng hẳn với kỹ sư không học luật, nhưng bạn phải chứng minh được mình hiểu cách luật sư làm việc.
Lý do nằm ở chính thước đo của CoCoBench. Nếu chuẩn chấm là mức một luật sư hành nghề chấp nhận được, người viết eval phải phân biệt được một câu trả lời “đọc thì ổn” với một câu trả lời luật sư dám ký tên. Không pipeline nào sửa được một bộ eval chấm sai từ đầu.
Logic này dùng được cho mọi ngành dọc, từ y tế đến tài chính.
Bộ eval là thứ cho phép đổi mô hình
Có một lý do thực dụng khác khiến eval quan trọng. Theo thông cáo tháng 11/2024, chương trình đánh giá LLM của Thomson Reuters thử nghiệm ngay trong sản phẩm các mô hình mới của nhiều nhà cung cấp AI.
Chiến lược nhiều mô hình chỉ chạy được khi có một bộ eval ổn định để so. Mỗi lần có mô hình mới, câu hỏi “có nên chuyển không?” chỉ trả lời được bằng cách chạy lại cùng bộ câu hỏi, cùng tiêu chí, rồi đặt các con số cạnh nhau.
Ở phía khách hàng, FDE cũng gặp đúng câu hỏi đó, thường vào lúc không ai chuẩn bị. Nếu bạn dựng bộ eval ngay từ tuần đầu, buổi họp đổi mô hình sẽ là buổi đọc bảng số thay vì buổi tranh luận cảm tính.
Một dự án portfolio kể được cả câu chuyện
Nếu muốn chuẩn bị cho một vị trí như thế này, bạn có thể bắt đầu từ đúng một dự án. Hãy dựng một hệ thống RAG trên một tập văn bản pháp lý công khai, chẳng hạn hợp đồng mẫu hoặc văn bản luật, rồi thêm một bước agentic đơn giản như tự tách câu hỏi phức tạp thành nhiều câu hỏi nhỏ.
Phần quan trọng nhất là bộ eval đi kèm. Mỗi câu hỏi cần có đáp án chuẩn và điều khoản nguồn. Chấm riêng độ đúng của retrieval, độ đúng của câu trả lời, độ đúng của trích dẫn và tỷ lệ bịa nguồn, rồi ghi lại các con số thay đổi thế nào qua từng lần sửa.
Các thước đo này bám sát những tiêu chí mà tin tuyển cấp mid-level liệt kê. Nếu có thể, chạy cùng bộ eval trên hai mô hình khác nhau để có thêm một bảng so sánh.
Khi viết CV, đừng chỉ ghi “xây chatbot pháp lý bằng LLM”. Hãy viết theo hướng: đã thiết kế bộ eval cho trích dẫn, phát hiện bao nhiêu lỗi bịa nguồn và giảm được xuống mức nào.
Trong phỏng vấn, kể lại một lần bạn ngồi với người dùng trong ngành để xác định lỗi nào không chấp nhận được. Câu chuyện đó cho thấy bạn hiểu điều Thomson Reuters đặt làm thước đo: thứ người làm nghề chấp nhận, chứ không phải thứ benchmark tổng quát chấm cao.
Bộ tin của đội CoCounsel cho thấy FDE ở ngành dọc là kỹ sư vừa dựng được hệ thống, vừa đo được cái đúng theo tiêu chuẩn của người trong nghề. Ai làm được cả hai sẽ có lợi thế ở mọi ngành mà sai một trích dẫn là mất khách hàng.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
6 nguồn
- Senior Software Engineer - AI (Legal), CoCounsel FDE - Thomson Reuters (Built In NYC)
- Software Engineer - AI - CoCounsel Forward Deployed Engineering (Ann Arbor USA jobs)
- Senior Software Engineer, Legal - CoCounsel Forward Deployed Engineering (Dice)
- Legal AI Benchmarking: CoCounsel (Thomson Reuters) · 2024-10-23
- Why Legal AI Needs a New Standard: Inside Thomson Reuters CoCoBench · 2026-05-04
- Thomson Reuters CoCounsel tests custom LLM from OpenAI, broadening its multi-model product strategy · 2024-11-25