Trước khi tách code, hãy quyết định cách chia khách hàng
Khi ngân hàng đòi dữ liệu riêng và update mỗi quý còn chuỗi bán lẻ muốn tính năng ngay, deployment stamps quan trọng hơn microservices.
Tóm tắt nhanh
- Microservices giúp ứng dụng chịu lỗi tốt hơn nhưng không đáp ứng được những yêu cầu như có dữ liệu riêng hay cập nhật chậm hơn của từng khách.
- Gộp nhiều task vào chung một đơn vị compute thì rẻ, nhưng các task đó phải chung nhịp release, chung fault domain và chung security context.
- Deployment stamps tách khách hàng theo nhóm, đổi lại tốn nhiều hạ tầng hơn và rất khó chuyển tenant giữa các stamp, nên cần infrastructure as code ngay từ đầu.
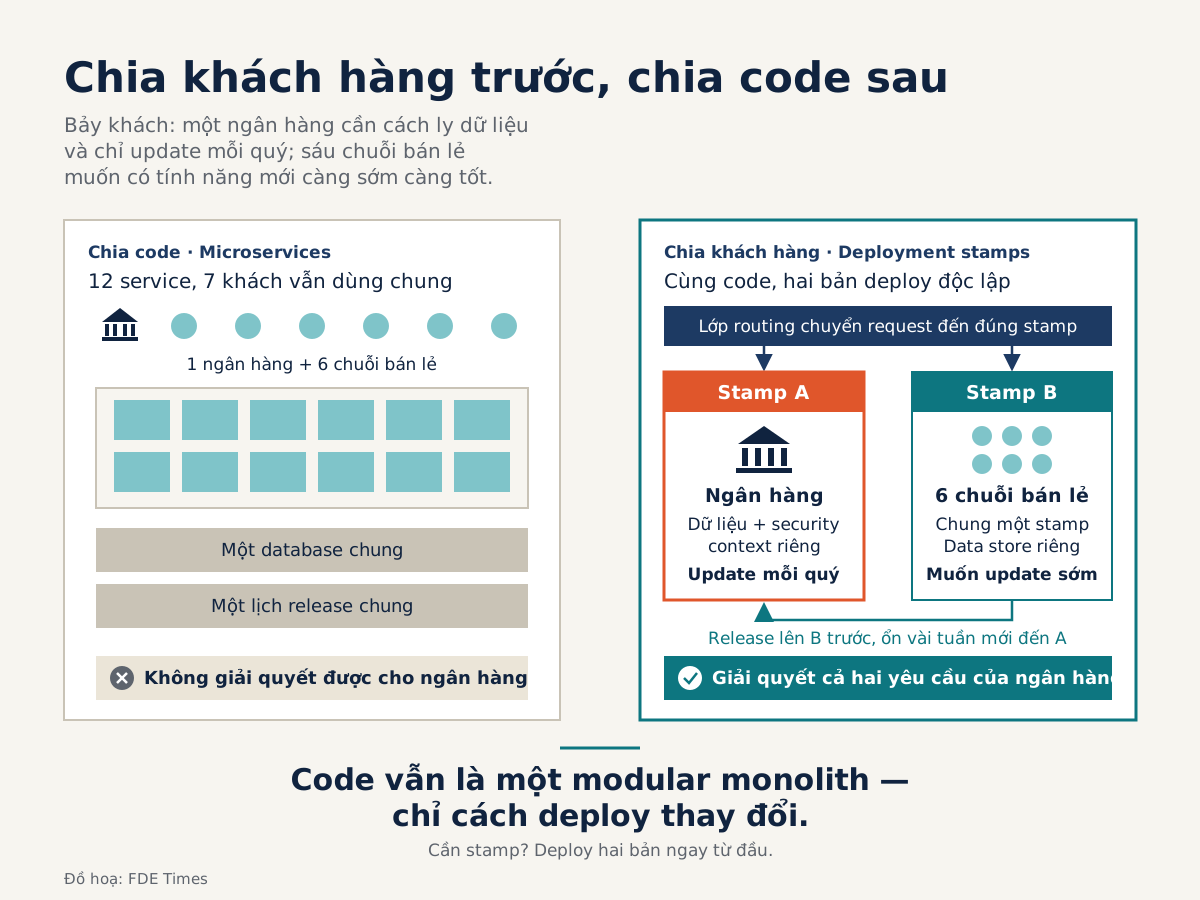
Thử hình dung bạn bàn giao cùng một giải pháp cho bảy khách hàng: một ngân hàng và sáu chuỗi bán lẻ vừa. Ngân hàng không muốn dữ liệu của mình nằm chung với khách khác và chỉ chấp nhận update mỗi quý một lần. Các chuỗi bán lẻ thì muốn có tính năng mới càng sớm càng tốt.
Câu hỏi kiến trúc mà đội kỹ thuật hay đặt ra trước tiên là monolith hay microservices. Với một FDE, câu hỏi quan trọng hơn là chia khách hàng thế nào: khách nào dùng chung hạ tầng, khách nào có bản riêng, khách nào nhận update vào lúc nào.
Microservices chia code, còn deployment stamps chia khách hàng. Nhầm hai việc này với nhau thì bạn sẽ có một hệ thống tốn kém mà vẫn không làm hài lòng được khách khó tính nhất.
Microservices giải quyết một bài toán khác
AWS giới thiệu microservices bằng một lợi ích rõ ràng: các service độc lập với nhau nên ứng dụng chịu lỗi tốt hơn. Lợi ích đó có thật, nhưng phải trả giá. Ngay từ năm 2014, Martin Fowler đã nhắc rằng distributed transaction nổi tiếng là khó làm.
Lời khuyên của Fowler cũng rất thực tế: bắt đầu bằng một monolith, giữ cho nó modular, và chỉ tách thành microservices khi chính monolith đó bắt đầu gây vấn đề. Đây là cách làm hợp với FDE, vì bạn thường có ít người, ít thời gian và phải chạy được ở môi trường của khách trước khi bàn đến chuyện kiến trúc có đẹp hay không.
Chiều ngược lại cũng có một con số hay được dẫn. Một case study nội bộ của Amazon, được DevClass đưa tin vào tháng 5/2023, kể rằng đội giám sát chất lượng audio/video của Prime Video gộp các thành phần phân tán về một process duy nhất và giảm chi phí hạ tầng hơn 90%.
Kết quả đó chỉ đúng với trường hợp của đội ấy, nhưng nó nhắc rằng tách nhỏ không hề miễn phí.
Quay lại ngân hàng ở đầu bài. Tách hệ thống thành 12 service không đáp ứng được yêu cầu nào trong hai yêu cầu của họ.
Dù có 12 service, ngân hàng vẫn dùng chung database và chung lịch release với mọi khách khác.
Gộp compute thì rẻ, nhưng mọi thứ gắn chặt với nhau
Azure Architecture Center có một pattern gần với tinh thần “gộp lại cho rẻ” của monolith: Compute Resource Consolidation, tức chia sẻ compute giữa nhiều task để giảm chi phí. Pattern này nói về cách chạy các task trên hạ tầng, không phải cách tổ chức code, nhưng nó cho thấy rõ cái giá của việc gộp.
Theo tài liệu đó, khi cần cập nhật một task, bạn phải dừng, deploy lại và khởi động lại mọi task khác trong cùng đơn vị compute; các task gộp chung cũng dùng chung fault domain và chung security context.
Cũng tài liệu đó ghi rõ: không nên gộp những task xử lý dữ liệu rất nhạy cảm hoặc riêng tư, vì chúng cần security context riêng. Đặt điều này vào bối cảnh triển khai cho nhiều khách hàng, có thể thấy giới hạn của việc chạy mọi khách chung một khối: cách đó ổn cho đến khi gặp khách đầu tiên đòi cách ly dữ liệu.
Kể cả khi giữ monolith, có một lỗi bạn nên tránh ngay từ đầu. Microsoft xếp việc dồn toàn bộ dữ liệu vào một data store duy nhất vào nhóm antipattern, vì cách làm này gây tranh chấp tài nguyên và làm giảm hiệu năng. Khuyến nghị là tách dữ liệu theo cách sử dụng.
Monolith ở tầng code không có nghĩa là bắt buộc dùng một database cho tất cả.
Stamps: chia theo khách hàng, không theo chức năng
Deployment stamps tiếp cận vấn đề từ một hướng khác. Bạn không chia ứng dụng thành nhiều phần, mà deploy nhiều bản sao độc lập của toàn bộ ứng dụng, mỗi bản có data store riêng. Trong môi trường multitenant, mỗi stamp phục vụ một số tenant định trước.
Microsoft mô tả tình huống này rất gần với công việc của FDE: một số khách lớn có thể cần instance riêng, còn các khách nhỏ hơn dùng chung một deployment multitenant. Stamps còn giải quyết chuyện nhịp cập nhật.
Có khách chấp nhận update thường xuyên, có khách ngại rủi ro và chỉ muốn update thưa, nên bạn có thể cho từng stamp đi theo một deployment ring khác nhau.
Áp vào bảy khách hàng ở đầu bài: stamp A chỉ dành cho ngân hàng, với dữ liệu và security context riêng. Stamp B chạy chung cho sáu chuỗi bán lẻ.
Mỗi bản phát hành mới lên stamp B trước, chạy ổn vài tuần rồi mới đến stamp A. Code vẫn là một modular monolith, chỉ cách deploy thay đổi.
| Tiêu chí | Gộp compute (Compute Resource Consolidation) | Microservices | Deployment stamps |
|---|---|---|---|
| Chia theo trục nào | Không chia, nhiều task chạy chung một đơn vị compute | Chia code theo chức năng | Chia khách hàng thành nhóm tenant |
| Nhịp release | Sửa một task phải deploy lại cả đơn vị | Không chia nhịp theo từng khách hàng | Mỗi nhóm khách có ring và nhịp riêng |
| Cách ly dữ liệu nhạy cảm | Chung security context, không phù hợp | Không tự giải quyết theo từng khách | Khách lớn có thể có stamp riêng |
| Cái giá chính | Fault domain chung | Distributed transaction khó làm | Tốn hạ tầng hơn nhiều, khó chuyển tenant |
| Nên chọn khi | Các task không cần security context riêng | Monolith đã thực sự gây vấn đề | Khách khác nhau về cách ly hoặc nhịp update |
Bảng này dễ bị đọc thành ba lựa chọn loại trừ nhau, nhưng thực ra không phải vậy. Stamps là cách deploy, còn monolith hay microservices là cách tổ chức code, nên một modular monolith vẫn chạy được trên nhiều stamp như ví dụ ngân hàng và chuỗi bán lẻ ở trên.
Mỗi bản sao đều tốn tiền
Microsoft cũng nói rõ cái giá: deploy nhiều bản sao hạ tầng làm chi phí vận hành tăng đáng kể. Chuyển một tenant từ stamp này sang stamp khác cũng khó. Vì vậy, quyết định đặt khách nào vào stamp nào nên làm cẩn thận ngay ở buổi customer discovery, đừng để đến khi khách đã chạy production mới tính.
Vận hành nhiều stamp cần infrastructure as code và kiểm soát drift. Nếu không, các stamp sẽ khác nhau dần qua mỗi lần ai đó sửa tay trên môi trường của khách. Microsoft còn khuyên deploy ít nhất hai stamp, vì khi chỉ có một stamp, rất dễ vô tình hard-code những giả định chỉ đúng khi có một instance.
Ngược lại, stamps không phải lựa chọn mặc định. Theo Microsoft, nếu giải pháp đơn giản, không cần mở rộng nhiều, hoặc một instance đã đủ tải, thì không nên dùng pattern này. Nếu bạn chỉ có một khách hàng, hoặc mọi khách đều chấp nhận dùng chung, một modular monolith với dữ liệu được tách hợp lý là đủ.
Khi khách hàng yêu cầu dữ liệu nằm ở một vùng cụ thể
Còn một lựa chọn nữa là geode: mỗi instance đều phục vụ được bất kỳ người dùng nào, thay vì chỉ một nhóm khách như stamps. Microsoft cho biết geode thường phức tạp hơn nhiều khi thiết kế và xây dựng, và phù hợp với các nền tảng cloud-native không có ràng buộc về vị trí dữ liệu.
Vì thế, trước khi nghĩ tới geode, hãy hỏi khách ngay từ đầu xem họ có yêu cầu về vị trí dữ liệu hay không. Microsoft nêu rõ geode không phù hợp khi có yêu cầu về data residency, hoặc khi ứng dụng phải giữ state tạm cho một phiên làm việc.
Trong trường hợp đó, Microsoft khuyên dùng stamps kết hợp một lớp routing toàn cục để chuyển request đến đúng stamp.
Nếu khách hàng của bạn yêu cầu dữ liệu không rời khỏi một vùng nhất định, như ngân hàng, bệnh viện hay cơ quan nhà nước, câu trả lời gần như đã có sẵn: mỗi vùng là một stamp, phía trước có một lớp routing. Đây không phải lựa chọn hay lý thuyết nhất, nhưng là lựa chọn bạn giải thích được với bộ phận compliance của khách.
Với developer Việt Nam muốn làm FDE
Khi đọc JD của một vị trí FDE hoặc solutions engineer, hãy để ý các cụm như multi-tenant, single-tenant deployment, dedicated instance, infrastructure as code. Những cụm này cho biết công ty đang phải xử lý đúng bài toán chia khách hàng, và họ cần người hiểu được cả hai trục kiến trúc.
Trong CV, đừng chỉ ghi “chuyển hệ thống sang microservices”. Hãy viết rõ bạn đã quyết định cách deploy như thế nào và vì sao: ví dụ khách nào có instance riêng vì lý do gì, nhịp release được chia ra sao, và làm gì để các môi trường không bị drift.
Câu chuyện về một quyết định có cân nhắc đánh đổi thuyết phục hơn nhiều so với một danh sách công nghệ.
Trong phỏng vấn, nếu được hỏi “monolith hay microservices”, câu trả lời tốt thường bắt đầu bằng một câu hỏi ngược: có bao nhiêu khách hàng, và họ khác nhau ở điểm nào. Ở vị trí FDE, cách bạn chia khách hàng thường quyết định thành bại của dự án nhiều hơn cách bạn chia code.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
7 nguồn
- Deployment Stamps Pattern - Azure Architecture Center | Microsoft Learn · 2026-04-28
- Geode pattern - Azure Architecture Center | Microsoft Learn · 2024-03-18
- Compute Resource Consolidation Pattern - Azure Architecture Center | Microsoft Learn · 2026-04-08
- Monolithic Persistence Antipattern - Azure Architecture Center | Microsoft Learn · 2017-06-05
- Microservices · 2014-03-25
- Introduction to Microservices (AWS)
- Reduce costs by 90% by moving from microservices to monolith: Amazon internal case study raises eyebrows · 2023-05-05