Vì sao FDE nên học eval trước khi học fine-tuning
Trong các tin FDE được đối chiếu, chỉ công ty hạ tầng AI đòi fine-tuning sâu, còn quyết định fine-tune thường bắt đầu từ một bộ eval.
Tóm tắt nhanh
- Yêu cầu fine-tuning sâu (SFT, LoRA, DPO, GRPO/PPO) xuất hiện ở tin FDE của Together AI, một công ty hạ tầng AI.
- Ngay cả ở đó, fine-tuning đi cùng tối ưu inference, vLLM/TensorRT-LLM/SGLang và kinh nghiệm dẫn dắt dự án trực tiếp với khách hàng.
- Ở dự án Morgan Stanley, đội FDE của OpenAI tinh chỉnh truy xuất và coi eval là bắt buộc; OpenAI cũng khuyên thường nên bắt đầu từ prompt cùng một bộ eval làm baseline.
Tin tuyển FDE Post-Training của Together AI liệt kê một chuỗi viết tắt dễ khiến người đọc nghĩ ngay tới chuyện đăng ký một khóa học: SFT, LoRA, DPO, GRPO, PPO. Công ty muốn ứng viên có kinh nghiệm thực hành ở mức chuyên gia về fine-tuning hoặc RL cho LLM.
Đọc vội, bạn sẽ kết luận rằng fine-tuning là tấm vé vào nghề FDE thời AI. Nhưng đặt tin này cạnh vài mô tả công việc FDE khác, kết luận ấy lung lay. Trong những tin tuyển và lời kể dưới đây, yêu cầu fine-tuning chuyên sâu chỉ nằm ở một công ty hạ tầng AI, và ngay cả ở đó nó cũng không đứng một mình.
Với một kỹ sư có vài năm kinh nghiệm đang chuẩn bị chuyển sang FDE, câu hỏi thực tế không phải là có nên học fine-tuning hay không. Câu hỏi là học nó vào lúc nào, và học gì trước để không mất sáu tháng cho một kỹ năng mà khách hàng của bạn có thể chẳng bao giờ hỏi tới.
Ở Together AI, fine-tuning không đứng một mình
Together AI có hai vai trò FDE chạm tới fine-tuning, và cả hai đều cho thấy nó bị gói chung với thứ khác. Tin Post-Training, bên cạnh danh sách thuật toán, còn đòi kinh nghiệm dẫn dắt các dự án kỹ thuật phức tạp làm trực tiếp với khách hàng.
Vai trò thứ hai, FDE Strategic Inference, mô tả người được tuyển là chuyên gia chuyên sâu về tối ưu inference, pipeline fine-tuning và triển khai production. Tin này gọi tên công cụ: các inference engine như vLLM, TensorRT-LLM, SGLang. Việc hằng ngày là chọn, cấu hình và tối ưu engine dựa trên phần cứng, kiến trúc model và đặc điểm tải.
Cách viết của hai tin cho thấy fine-tuning ở đây là một khâu trong dây chuyền, không phải đích đến. Model được tinh chỉnh xong vẫn phải chạy trên một GPU cụ thể, với một kiểu lưu lượng cụ thể, cho một khách hàng cụ thể. Người làm được cả chuỗi mới là người Together AI cần.
Khách hàng hạ tầng hỏi về latency, không hỏi về DPO
Lời kể của một FDE tại Baseten, nền tảng inference, làm rõ thêm điều này. Kỹ sư này mô tả mục tiêu chính là giúp khách đưa model mã nguồn mở, model đã fine-tune hoặc model tùy biến ra sau một API endpoint.
Hãy để ý vị trí của chữ “fine-tuned” trong câu đó. Model đã fine-tune là thứ khách mang đến, còn việc của FDE là làm cho nó chạy được. Câu hỏi điển hình được dẫn ra là làm sao giảm latency serving đi 10 lần trong khi giữ nguyên chi phí.
Thử tính câu hỏi đó như một bài toán. Nếu một request đang mất 2 giây, khách muốn còn 200 mili giây với cùng hóa đơn GPU. Bài này khó giải bằng DPO hay GRPO; lời giải nằm ở việc chọn engine, cấu hình, chọn phần cứng hợp với kiến trúc model, đúng những gì tin Strategic Inference mô tả.
Một ví dụ ở tầng ứng dụng: việc thật là truy xuất và eval
Phía công ty bán model cho doanh nghiệp có một ví dụ đáng xem kỹ. Trong dự án với Morgan Stanley, đội FDE của OpenAI phải phát triển các kỹ thuật tinh chỉnh truy xuất để báo cáo nghiên cứu được tìm ra chính xác và được người dùng tin tưởng. Họ tinh chỉnh khâu tìm kiếm, không tinh chỉnh model.
Nhóm này cũng coi eval là phần bắt buộc: một ứng dụng dựa trên LLM chưa hoàn chỉnh nếu thiếu bộ đánh giá chứng minh nó hiệu quả.
Hướng dẫn tối ưu độ chính xác LLM của OpenAI nói cùng một ý theo trình tự: prompt engineering thường là điểm khởi đầu tốt nhất, và từ đó bạn cần một bộ eval vững để làm baseline trước khi tính tới RAG hay fine-tuning.
Từ hai phía này có thể phác ra hai kiểu FDE với hai bộ kỹ năng khác nhau, dù cùng một chức danh. Cột bên phải chỉ dựa trên một dự án là Morgan Stanley, cộng với hướng dẫn chung của OpenAI, nên hãy đọc nó như một ví dụ để đối chiếu, không phải quy luật cho cả tầng ứng dụng.
| Khía cạnh | FDE tầng hạ tầng AI | Một ví dụ tầng ứng dụng |
|---|---|---|
| Nguồn ví dụ | Together AI, Baseten | Đội FDE của OpenAI với Morgan Stanley |
| Câu hỏi khách mang tới | Giảm latency, giữ chi phí, chạy model đã tinh chỉnh | Báo cáo tìm ra có chính xác và đáng tin không |
| Việc chính | Chọn và cấu hình inference engine, pipeline fine-tuning | Tinh chỉnh truy xuất, dựng eval |
| Vị trí của fine-tuning | Kỹ năng được ghi rõ, đi cùng serving | Theo hướng dẫn OpenAI: tính sau prompt, khi có eval làm baseline |
| Công cụ được gọi tên | vLLM, TensorRT-LLM, SGLang | Bộ eval làm baseline |
| Thứ phải chứng minh | Đã dẫn dắt dự án kỹ thuật với khách | Ứng dụng có eval xác nhận hiệu quả |
Điểm chung của hai cột không phải là fine-tuning. Điểm chung là năng lực đo được hệ thống đang tốt tới đâu và đưa nó vào production cho khách.
Khi nào mới đến lượt fine-tune
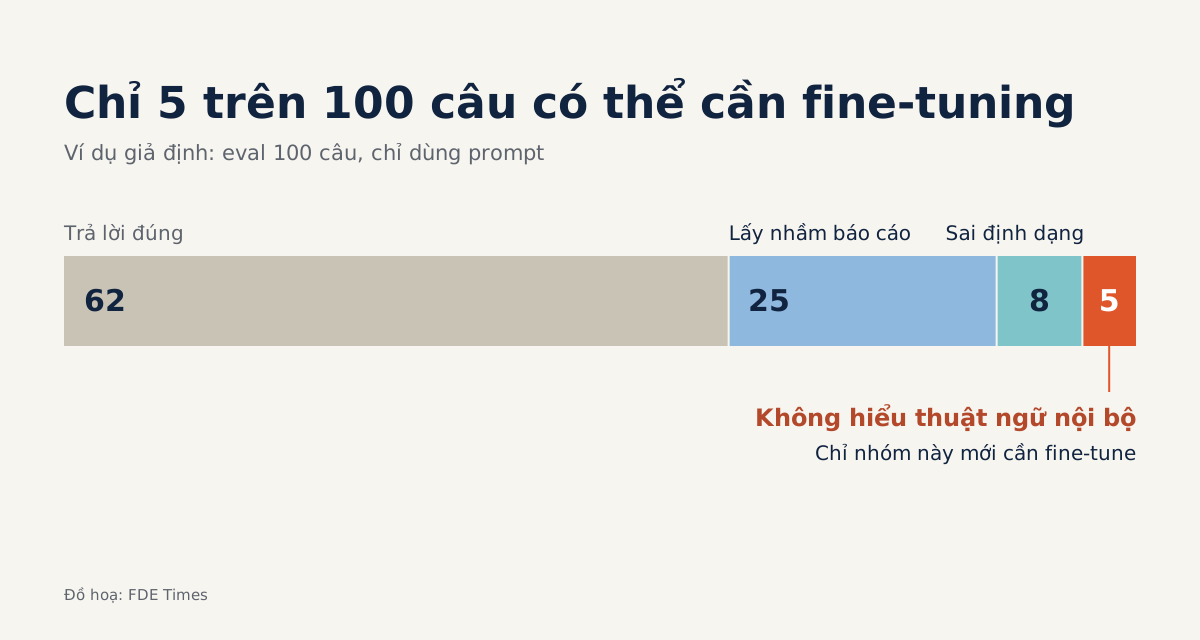
Thử hình dung bạn là FDE tại một ngân hàng muốn trợ lý nội bộ trả lời câu hỏi về báo cáo phân tích. Bạn dựng 100 câu hỏi kèm đáp án chuẩn, chạy chỉ với prompt, và giả sử được 62 câu đúng. Đó là baseline.
Giờ đọc kỹ 38 câu sai. Giả sử 25 câu sai vì hệ thống lôi nhầm báo cáo, 8 câu sai vì trả lời đúng ý nhưng sai định dạng, 5 câu sai vì model không hiểu thuật ngữ nội bộ. Hai mươi lăm câu đầu là bài toán truy xuất, đúng loại việc đội OpenAI làm ở Morgan Stanley; tám câu kế tiếp thường sửa được bằng prompt.
Chỉ khi đã xử lý xong hai nhóm đó mà nhóm lỗi cuối còn dai dẳng, fine-tuning mới thành ứng viên hợp lý. Và lúc ấy, theo OpenAI, chất lượng dữ liệu huấn luyện quan trọng hơn số lượng. Vậy kỹ năng quyết định là chọn và làm sạch vài trăm ví dụ tốt từ chính các câu sai, chứ không phải thuộc lòng công thức loss của DPO.
Thứ tự học cho người muốn vào nghề
Từ các mô tả trên, một thứ tự hợp lý hiện ra. Bắt đầu bằng eval và prompt, vì đó là baseline mà mọi quyết định sau phải dựa vào. Tiếp theo là truy xuất và kỹ năng dữ liệu: truy xuất là việc đội OpenAI phải làm ở Morgan Stanley, còn dữ liệu chất lượng là điều OpenAI đặt lên trên số lượng khi fine-tune.
Bước thứ ba là serving: chạy một model mã nguồn mở trên vLLM hoặc SGLang, đo latency và chi phí, thử đổi cấu hình rồi đo lại.
Đây là kỹ năng mà tin Strategic Inference gọi tên và cũng là thứ lời kể từ Baseten xoay quanh. Chỉ sau đó, nếu bạn nhắm vào công ty hạ tầng, mới đi sâu vào SFT, LoRA, rồi DPO và RL như GRPO, PPO.
Khi đọc tin tuyển, hãy dùng bảng trên như một bộ lọc thô. Tin nhắc tên inference engine và thuật toán post-training nhiều khả năng là tin tầng hạ tầng; ở đó fine-tuning đáng đầu tư sớm.
Tin xoay quanh độ chính xác và độ tin cậy cho khách doanh nghiệp có thể gần với ví dụ Morgan Stanley hơn; ở đó một dự án eval tốt có lẽ nặng ký hơn chứng chỉ fine-tuning.
Trên CV, đừng viết “có kinh nghiệm fine-tuning” như một dòng kỹ năng trơ trọi. Viết thành một câu chuyện có số: baseline bao nhiêu, lỗi chia thành mấy nhóm, sửa truy xuất nâng điểm lên bao nhiêu, và vì sao bạn quyết định có hoặc không fine-tune. Nếu nhắm tầng hạ tầng, thêm một dòng về latency trước và sau khi bạn đổi cấu hình serving.
Đừng quên vế mà Together AI đặt ngay cạnh danh sách thuật toán: dẫn dắt dự án kỹ thuật với khách hàng. Chuỗi viết tắt có thể là dòng gây ấn tượng nhất trong tin tuyển, nhưng chính bộ eval mới cho bạn biết khách có cần tới chúng hay không.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
5 nguồn
- Forward Deployed Engineer, Post-Training (Together AI)
- Forward Deployed Engineer, Strategic Inference (Together AI)
- What I Learned As A Forward Deployed Engineer Working At An AI Startup · 2024-05-31
- Optimizing LLM Accuracy (OpenAI API docs)
- Forward Deployed Engineering: Bringing Enterprise LLM Applications to Production (ZenML LLMOps Database) · 2025