Modal: từ một hàm Python đến demo có GPU và job hàng loạt trong buổi chiều
Khi khách hỏi "chạy thử trên dữ liệu thật được không?", FDE hiếm khi có thời gian dựng hạ tầng, và Modal giúp bạn bỏ qua phần lớn việc đó.
Tóm tắt nhanh
- Modal chạy hàm Python của bạn trong container trên cloud, tính tiền theo giây và không thu phí lúc tài nguyên nằm không
- modal serve cho URL demo tự cập nhật khi sửa code, .map chia việc ra nhiều container, một tham số decorator là có GPU
- Modal mạnh ở job hàng loạt và nguyên mẫu; dịch vụ luôn bật, lưu lượng cao thì nên tính phương án khác
Thứ khiến một buổi demo với khách thất bại hiếm khi là model. Thường thì đó là chuyện máy có GPU còn chưa được cấp, cấu hình container còn đang hỏng, và job xử lý 10.000 file vẫn chạy tuần tự trên laptop của bạn.
Modal nhắm thẳng vào phần việc ấy. Modal Labs giới thiệu đây là nền tảng hạ tầng AI: nó lấy code của bạn, đặt vào container và chạy trên cloud.
Với một FDE, sức hút nằm ở mô hình tính tiền. Trang giá của hãng nói rõ bạn tính phí theo giây và không bao giờ trả tiền cho tài nguyên nằm không. Gói Starter có $30 credit miễn phí mỗi tháng, đủ để bạn tự luyện tay và làm nguyên mẫu.
Vì sao “chỉ là Python” lại quan trọng?
Trên PyPI, thư viện client modal được mô tả là cách truy cập compute serverless theo nhu cầu ngay từ script Python trên máy bạn. Thư viện này mở mã nguồn theo giấy phép Apache-2.0. Để bắt đầu, bạn cài bằng pip, chạy modal setup để xác thực, rồi modal run một file Python.
Một bài so sánh độc lập của Introl ghi nhận việc triển khai trên Modal không cần YAML hay Dockerfile. Cũng bài đó cho rằng Modal hợp nhất với team lấy Python làm trung tâm, cần vòng iterate nhanh và coi trọng sự thuận tay khi lập trình hơn là ép chi phí xuống thấp nhất có thể.
Ở chỗ khách, đó gần như đúng hồ sơ công việc của FDE: bạn không phải đổi ngôn ngữ, không phải nhờ team hạ tầng, và logic vừa thử trong notebook có thể tách thành hàm để đưa lên cloud ngay trong buổi.
Thử hình dung: 10.000 hợp đồng và một buổi chiều
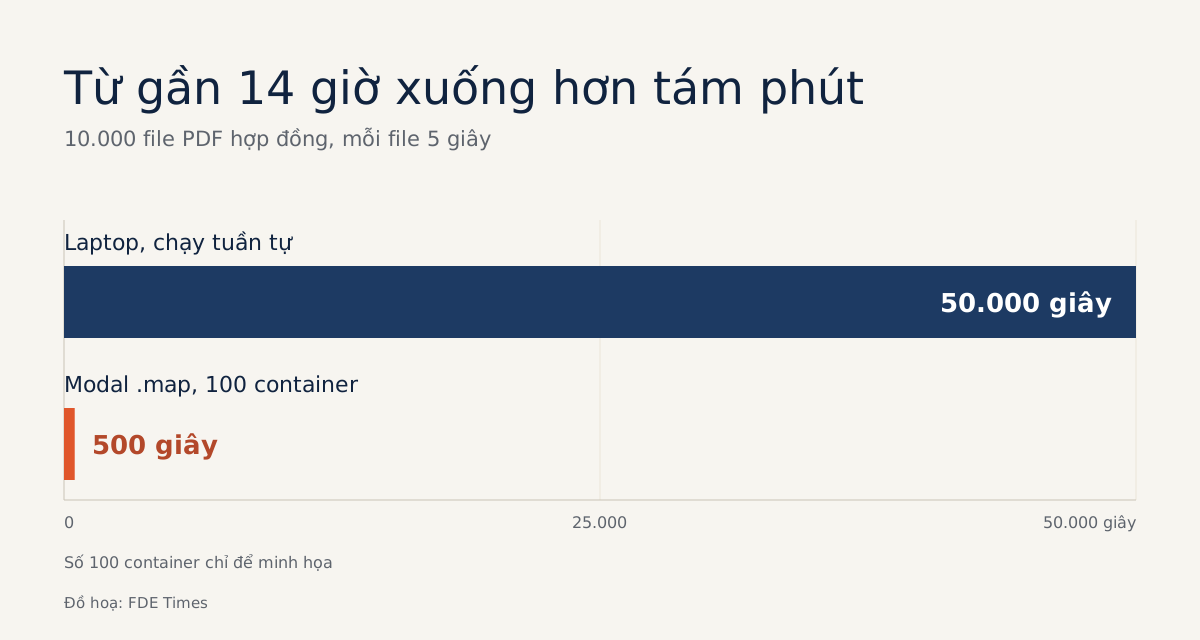
Giả sử một công ty bảo hiểm đưa bạn 10.000 file PDF hợp đồng và hỏi model trích xuất điều khoản của bạn có đáng tin không. Nếu mỗi file mất 5 giây, chạy tuần tự trên laptop là 50.000 giây, gần 14 giờ, tức là hết buổi chiều mà vẫn chưa có kết quả.
Trên Modal, bạn giữ nguyên hàm extract, thêm decorator và gọi .map. Một phác thảo tối giản trông như sau:
import modal

app = modal.App("trich-xuat-hop-dong")

@app.function(gpu="L4")  # chọn loại GPU qua tham số gpu
def extract(pdf: bytes) -> dict:
    # nạp model, đọc một hợp đồng, trả về điều khoản dạng JSON
    ...

@app.function()
@modal.fastapi_endpoint()  # một dòng để biến hàm thành web endpoint
def thu(text: str) -> dict:
    return {"nhan": text}  # chỗ để khách gọi thử

@app.local_entrypoint()
def main():
    files = [...]  # danh sách nội dung 10.000 file PDF
    for ket_qua in extract.map(files):
        print(ket_qua)
Bạn chạy job hàng loạt bằng modal run hop_dong.py, còn modal serve hop_dong.py cho một URL tạm để khách bấm thử. Theo tài liệu batch processing, .map đẩy phần tính toán nặng sang các máy mạnh rồi gom kết quả về cho bạn. Modal cũng tự cấp phát hạ tầng và có thể mở rộng tới hàng nghìn container song song.
Giờ làm lại phép tính. Giả sử .map chia 10.000 file cho 100 container chạy cùng lúc: mỗi container nhận 100 file, tức khoảng 500 giây, hơn tám phút một chút. Con số 100 chỉ để minh họa; cộng thêm thời gian khởi động container và nạp model, bạn vẫn có kết quả trong buổi chiều thay vì sáng hôm sau.
Tham số gpu nhận nhiều loại, từ T4, L4, A10, L40S đến A100, H100, H200 và B200. Lời khuyên thực tế: bắt đầu với loại nhỏ nhất đủ chạy model, chỉ nâng lên khi đo thấy chậm.
Trong lúc chỉnh endpoint trước giờ họp, modal serve tự cập nhật app mỗi khi file thay đổi, nên bạn sửa prompt hay định dạng JSON mà không phải deploy lại. Gửi URL đó cho trưởng nhóm nghiệp vụ, họ thử luôn trên hợp đồng của chính mình.
Tiền theo giây đổi cách bạn làm demo
Thử tính: một endpoint demo để mở suốt năm ngày làm việc, nhưng khách chỉ gọi tổng cộng khoảng 20 phút. Với máy GPU thuê cố định, bạn trả cho cả năm ngày. Với mô hình không tính phí lúc rảnh, bạn chỉ trả cho phần compute thật sự chạy.
Cái giá phải trả là cold start. Tài liệu của Modal định nghĩa đó là độ trễ cao hơn khi phải khởi động container mới, và với nhu cầu tương tác thì cách duy nhất là giữ thêm container ấm. Sam McKay viết trên Enterprise DNA rằng Modal xử lý cold start tốt hơn phần lớn nền tảng serverless nhưng không làm nó biến mất.
Đừng để lần gọi chậm đầu tiên rơi đúng lúc khách đang nhìn màn hình.
Khi nào nên để Modal đứng ngoài?
Bài đánh giá trên Enterprise DNA nói thẳng: Modal mạnh ở batch job, còn nếu ép nó làm dịch vụ luôn bật với lưu lượng cao thì chi phí sẽ trở thành gánh nặng. Lý do nằm ngay trong mô hình giá: tính theo giây có lợi khi tải dồn dập rồi nghỉ, và mất lợi thế khi máy không bao giờ được nghỉ.
Vì thế, Modal hợp nhất với phần việc FDE làm trước khi khách quyết định: chứng minh tính khả thi, chạy job một lần, dựng nguyên mẫu. Khi nguyên mẫu thành hệ thống chạy cả ngày, hãy tính lại chi phí trước khi đề xuất giữ nguyên kiến trúc.
Giới hạn còn lại không nằm ở kỹ thuật. Code chạy trong container trên cloud, nên dữ liệu của khách phải rời khỏi môi trường của họ. Với ngân hàng, bệnh viện hay khách có quy định lưu trữ chặt, hãy hỏi chính sách trước, hoặc demo bằng dữ liệu đã ẩn danh.
Học gì trước, và ghi gì vào CV
Hãy học theo thứ tự công việc thực tế: modal run một hàm, rồi modal serve để có URL, rồi .map trên một tập dữ liệu thật, cuối cùng mới đến GPU và đo cold start.
Kỹ năng đáng luyện nhất là tách code notebook thành hàm thuần, nhận một đầu vào và trả về một đầu ra, vì .map chỉ phát huy tác dụng khi hàm được viết như vậy.
Khi viết CV hay trả lời phỏng vấn FDE, đừng chỉ ghi “biết Modal”. Lời khuyên là kể một kết quả: số file đã xử lý, thời gian giảm từ bao lâu xuống bao lâu, URL demo nào giúp khách gật đầu.
Hạ tầng nhanh không làm demo của bạn hay hơn. Nó chỉ cho bạn thêm thời gian để hiểu đúng vấn đề của khách.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
9 nguồn
- Introduction (Modal docs)
- GPU acceleration (Modal docs)
- Batch Processing (Modal docs)
- Web Functions (Modal docs)
- Cold start performance (Modal docs)
- Pricing: Pay per second for GPUs and CPUs | Modal
- modal · PyPI
- Modal: What Engineers Actually Found · 2026-06-26
- Các nền tảng GPU Serverless: So sánh RunPod, Modal và Beam · 2026-03-19