LiteLLM Proxy: một cổng LLM chung, mỗi khách hàng một virtual key, ngân sách và hóa đơn riêng
Khi ba khách hàng cùng dùng chung một tài khoản OpenAI, câu hỏi "ai tiêu bao nhiêu" sẽ đến sớm hơn bạn nghĩ, và một gateway tự host là câu trả lời gọn nhất.
Tóm tắt nhanh
- LiteLLM Proxy là server tự host, một endpoint tương thích OpenAI cho hơn 100 nhà cung cấp LLM, giấy phép MIT.
- Mỗi virtual key mang model, ngân sách và rate limit riêng; gắn team_id để nhiều key dùng chung ngân sách của một khách.
- Gateway ghi chi phí từng request, tính theo key, user, team; ngân sách không đặt chu kỳ sẽ không bao giờ reset.
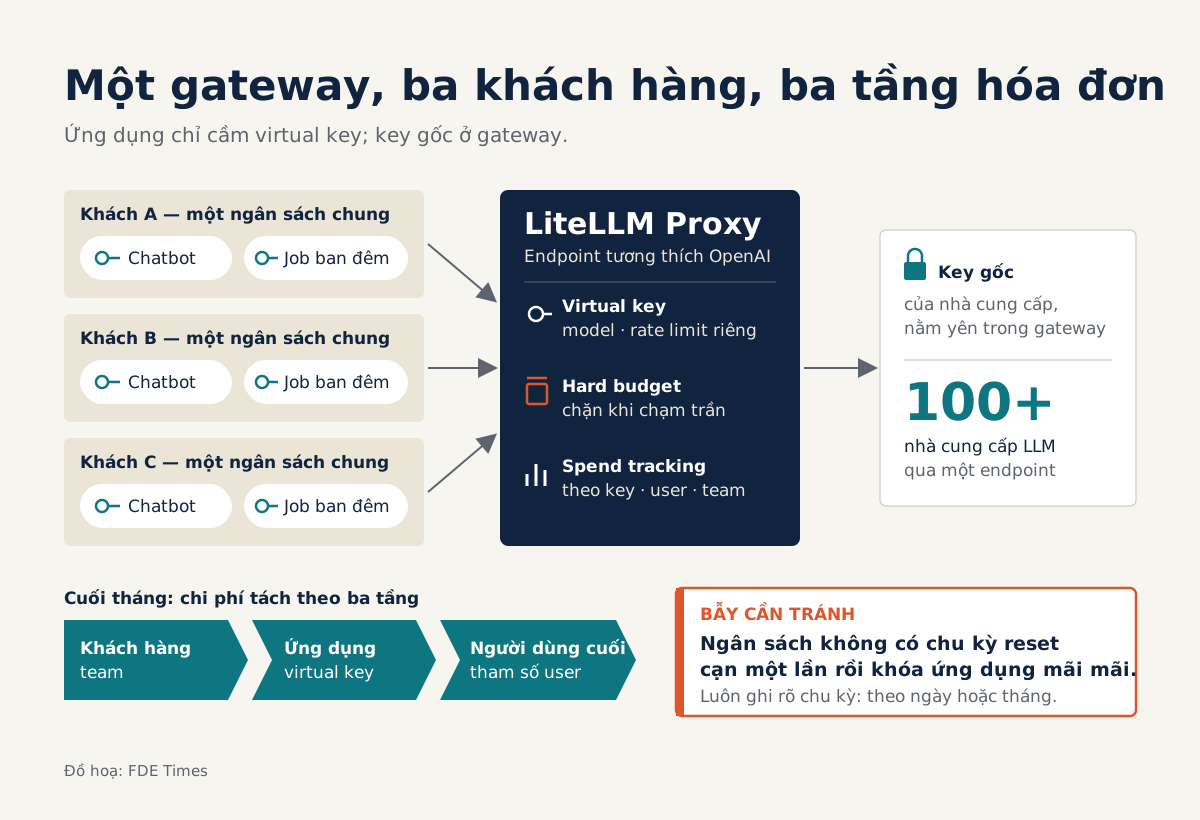
Hóa đơn LLM cuối tháng thường đến dưới dạng một con số duy nhất. Với một FDE đang triển khai cho ba khách hàng, hay ba phòng ban của cùng một khách, con số đó gần như vô dụng: không ai biết phần nào thuộc về ai, và không ai chặn được một agent chạy vòng lặp lúc nửa đêm.
LiteLLM Proxy giải đúng bài toán ấy. Tài liệu chính thức mô tả nó là một server tự host, cho ứng dụng một endpoint tương thích OpenAI để gọi hơn 100 nhà cung cấp LLM, cùng với MCP tools và A2A agents. Repo BerriAI/litellm trên GitHub gọi nó là AI Gateway mã nguồn mở, và package trên PyPI dùng giấy phép MIT.
Với bạn, điểm đáng giá không nằm ở việc “gọi được nhiều model”. Nó nằm ở chỗ gateway biến chi phí và quyền truy cập thành thứ bạn cấu hình được, theo từng khách hàng, trước khi có sự cố.
Vì sao không phát thẳng API key gốc?
Phát API key của nhà cung cấp cho từng ứng dụng nghĩa là mất kiểm soát ngay từ đầu. Key gốc không biết ứng dụng nào đang dùng nó, không có trần chi tiêu riêng, và thu hồi nó là làm sập mọi thứ cùng lúc.
Virtual key của LiteLLM tách lớp đó ra. Tài liệu ghi rõ mỗi key có danh sách model, ngân sách và rate limit của riêng nó, và chi tiêu được theo dõi tự động theo từng key.
README liệt kê virtual key, spend tracking, guardrails, load balancing và admin dashboard là tính năng có sẵn. Ứng dụng chỉ cầm virtual key; key gốc của nhà cung cấp nằm yên trong gateway.
Một ví dụ: ba khách hàng, một gateway
Thử hình dung bạn làm cho một công ty dịch vụ đang chạy chatbot cho ba khách hàng A, B và C. Mỗi khách có hai ứng dụng: một chatbot và một job tóm tắt tài liệu chạy ban đêm.
Cách dựng hợp lý là mỗi khách một team, mỗi ứng dụng một virtual key. Tài liệu LiteLLM cho phép gắn team_id vào virtual key để key đó rút từ ngân sách chung của team, còn key không có team_id là key cá nhân.
Như vậy hai ứng dụng của khách A cùng tiêu từ một ngân sách, nhưng chi phí vẫn tách theo từng key để bạn biết job ban đêm ngốn bao nhiêu.
Phía ứng dụng gần như không phải sửa gì, vì endpoint tương thích OpenAI. Đoạn minh họa dưới đây dùng địa chỉ và tên model giả định:
from openai import OpenAI

client = OpenAI(
    base_url="https://llm-gateway.noi-bo.example",  # địa chỉ gateway, giả định
    api_key="VIRTUAL_KEY_CUA_CHATBOT_KHACH_A",
)

resp = client.chat.completions.create(
    model="ten-model-duoc-phep",
    messages=[{"role": "user", "content": "Tóm tắt hợp đồng này"}],
    user="nguoi-dung-cuoi-1024",  # để gateway tính chi phí theo end-user
)
Dòng đáng chú ý là tham số user. Tài liệu spend tracking cho biết chi phí có thể theo dõi theo key, user và team, và việc theo dõi end-user dựa vào tham số user trong request, với mục đích được nói thẳng là tính tiền cho team khác, khách hàng hoặc người dùng.
Gateway ghi lại chi phí của từng request, nên cuối tháng bạn có số liệu theo ba tầng: khách hàng nào, ứng dụng nào, người dùng cuối nào.
Ngân sách chỉ an toàn khi có chu kỳ
Trang chủ LiteLLM nói về hard budget ở nhiều cấp: key, team, org và model, có reset theo ngày và theo tháng, và chặn khi chạm trần. Đây là thứ cứu bạn khỏi cuộc gọi lúc sáng sớm vì một agent lặp vô hạn.
Nhưng có một bẫy nhỏ. Tài liệu ghi ngân sách được reset vào cuối khoảng thời gian bạn chỉ định; nếu không chỉ định, nó không bao giờ reset.
Giả sử bạn đặt trần cho khách B mà quên chu kỳ: tháng đầu chạy êm, đến khi chạm trần thì mọi key của team B bị chặn, và nó sẽ bị chặn mãi cho đến khi có người vào sửa tay.
Vì thế, việc đầu tiên khi tạo team cho khách là ghi rõ chu kỳ reset, và thử cho một key chạm trần trong môi trường test để biết ứng dụng nhận lỗi gì, hiển thị gì cho người dùng.
Giới hạn bạn phải nói trước với khách
Tự host là điểm mạnh và cũng là gánh nặng. Gateway nằm trên đường đi của mọi request LLM, nên nó là hạ tầng của bạn hoặc của khách: phải có người vận hành, giám sát và nâng cấp.
Nhịp phát hành cũng rất dày: bản litellm mới nhất trên PyPI là 1.104.2, ra ngày 8/10/2026. Ở site khách hàng, hãy ghim version cố định và chỉ nâng sau khi chạy lại bộ test của mình.
Thêm nữa, số liệu theo end-user chỉ đúng khi mọi ứng dụng truyền tham số user đều đặn; đó là kỷ luật của team ứng dụng, gateway không tự đoán được.
Học gì trước, ghi gì vào CV
Thứ tự hợp lý là: dựng proxy chạy được với một nhà cung cấp, tạo virtual key giới hạn model, rồi mới đến team, ngân sách có chu kỳ và báo cáo chi phí theo user. Phần load balancing hay guardrails để sau, khi bài toán chi phí đã gọn.
Khi đọc JD FDE, các cụm như “multi-tenant”, “cost attribution” hay “LLM gateway” là tín hiệu công việc sẽ chạm đúng chỗ này. Trên CV, một dòng cụ thể như “dựng LLM gateway tự host, tách ngân sách và chi phí cho 3 khách hàng bằng virtual key và team” nói nhiều hơn mọi danh sách framework.
Khách hàng hiếm khi hỏi bạn dùng model nào. Họ hỏi tháng này tốn bao nhiêu và vì sao. Có gateway, bạn trả lời được câu đó bằng số liệu thay vì bằng phỏng đoán.