Ở khách dùng Azure, hỏi ngay họ chạy ADF hay Fabric
FDE hiếm khi bắt đầu từ trang trắng: dữ liệu agent cần đã chảy qua Glue, ADF hoặc Dataflow, và bạn phải đọc được pipeline ấy ngay tuần đầu.
Tóm tắt nhanh
- Glue và data flow của ADF đều chạy trên Spark do dịch vụ quản lý. Dataflow thì dựa trên Apache Beam, dùng một mô hình cho cả batch lẫn streaming.
- Ở khách dùng Azure, cần hỏi sớm họ đang ở ADF hay Data Factory trong Microsoft Fabric, vì Microsoft đang hướng người dùng mới sang Fabric.
- Thứ cần mở đầu tiên khi tiếp quản: Data Catalog trên AWS, integration runtime trên Azure, code Beam trên Google Cloud.
“Anh chị đang dùng Azure Data Factory hay Data Factory trong Microsoft Fabric?” Ở một khách hàng chạy Azure, đây nên là một trong những câu FDE hỏi sớm nhất.
Lý do nằm ngay trên trang giới thiệu của Microsoft. Hãng vẫn mô tả ADF là dịch vụ đám mây được quản lý, dành cho các dự án ETL, ELT và tích hợp dữ liệu hybrid phức tạp. Nhưng cũng trên trang đó, Data Factory trong Fabric được gọi là “thế hệ tiếp theo” của ADF, và người dùng mới được hướng sang Fabric.
Đằng sau câu hỏi là một thực tế: khi làm với dữ liệu, FDE hiếm khi bắt đầu từ trang trắng. Khi bạn đến, khách hàng thường đã chạy AWS Glue, Azure Data Factory hoặc Google Dataflow. Dữ liệu mà agent hay mô hình của bạn cần đọc đi qua chính những pipeline đó.
Bạn không cần thành chuyên gia cả ba, nhưng phải đọc được pipeline của khách ngay trong tuần đầu.
Ba dịch vụ, ba bộ từ vựng
AWS mô tả Glue là dịch vụ tích hợp dữ liệu serverless, dùng để khám phá, chuẩn bị, di chuyển và hợp nhất dữ liệu từ nhiều nguồn. Trung tâm của Glue là crawler: crawler tự suy ra schema rồi ghi vào Glue Data Catalog. Glue Studio cho phép kéo thả workflow biến đổi rồi chạy trên engine ETL serverless dựa trên Apache Spark.
Ai muốn viết code thì dùng Spark, Python hoặc Scala.
ADF có bộ khái niệm riêng: pipeline, activity, dataset, linked service, data flow và integration runtime. Mapping data flow chạy trên một cụm Spark tự bật lên khi cần rồi tự tắt, người dùng không phải quản lý cụm. Integration runtime là cầu nối giữa activity và linked service, tức là quyết định pipeline thực sự chạy ở đâu.
Google định nghĩa Dataflow là dịch vụ xử lý batch và stream hợp nhất, chạy ở quy mô lớn. Dataflow được công bố vào tháng 6/2014, mở beta công khai vào tháng 4/2015, và nay dựa trên dự án mã nguồn mở Apache Beam. Khi tải thay đổi, dịch vụ tự thêm hoặc tắt bớt worker VM.
Cùng một bài toán, ba chỗ cần mở trước
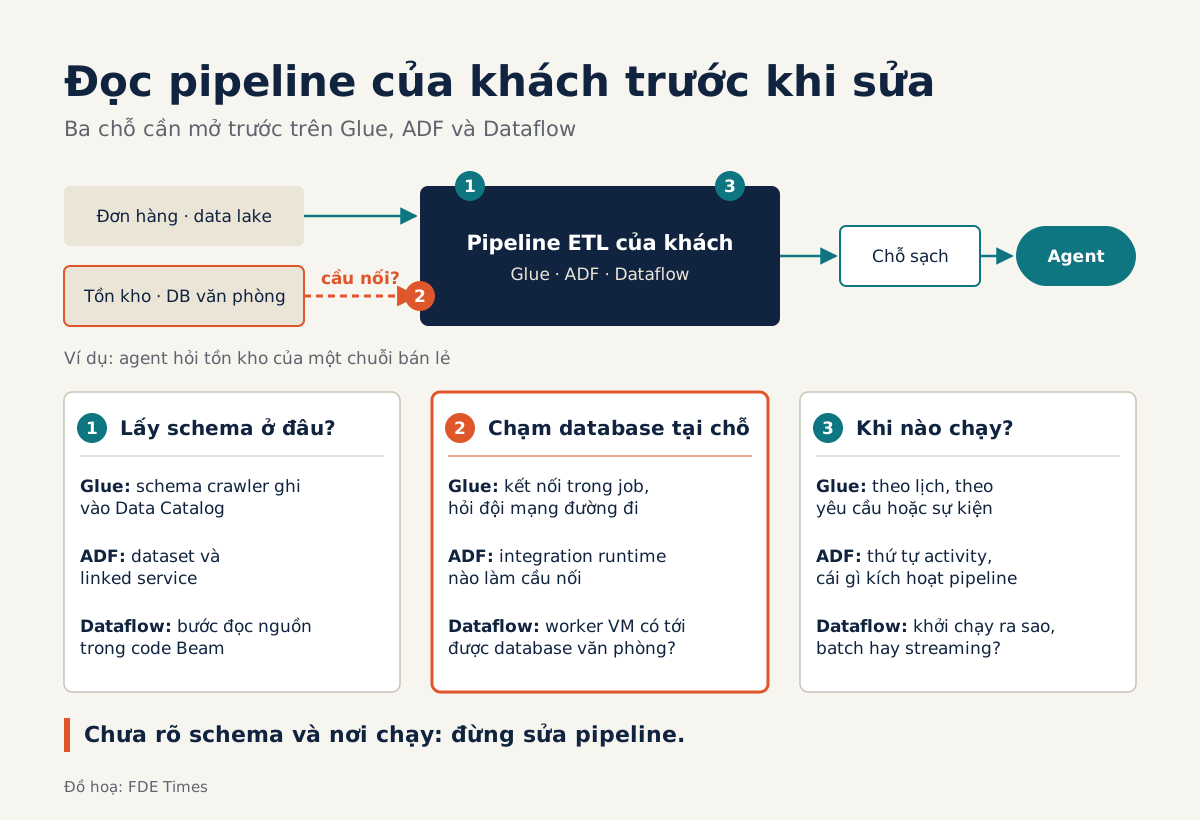
Thử hình dung một chuỗi bán lẻ muốn có agent trả lời câu hỏi về tồn kho. Mỗi đêm, file đơn hàng được đổ vào data lake, còn bảng tồn kho thì nằm trong một database đặt tại văn phòng. Việc của bạn là đưa hai nguồn này về một chỗ sạch để agent truy vấn. Bảng dưới đây gợi ý nên nhìn vào đâu trên mỗi nền tảng.
| Bước | AWS Glue | Azure Data Factory | Google Dataflow |
|---|---|---|---|
| Biết dữ liệu có gì | Xem schema crawler đã ghi vào Data Catalog | Đọc dataset và linked service | Đọc phần đọc nguồn trong code Beam |
| Chạm tới database tại chỗ | Mở job, ghi lại kết nối tới database văn phòng, rồi hỏi đội mạng đường đi và quyền truy cập của nó | Kiểm tra integration runtime nào làm cầu nối | Tìm bước đọc database trong code Beam, rồi hỏi đội mạng worker VM có tới được database văn phòng không |
| Biến đổi | Job Glue Studio hoặc PySpark | Mapping data flow chạy trên Spark | Transform của Beam |
| Khi nào chạy | Theo lịch, theo yêu cầu hoặc theo sự kiện | Mở pipeline, xem thứ tự các activity và hỏi khách cái gì đang kích hoạt nó | Hỏi khách job được khởi chạy thế nào, và đó là job batch hay streaming |
Đọc theo hàng, bạn sẽ thấy câu hỏi khó nhất trong ví dụ này ở hàng thứ hai. Integration runtime là cầu nối giữa activity và linked service, nên trên Azure, đó là điểm đầu tiên cần kiểm tra xem pipeline có kết nối được tới database trong văn phòng hay không.
Trước khi viết bất kỳ transform nào, nên ngồi với đội mạng và đội bảo mật của khách để làm rõ cầu nối ấy.
Giới hạn nằm ở đâu?
Cả ba dịch vụ đều giấu bớt hạ tầng, và chính điều đó khiến FDE dễ chủ quan. Việc Spark tự bật tự tắt hay worker tự co giãn không có nghĩa là logic biến đổi đúng. Schema do crawler suy ra từ dữ liệu vẫn chỉ là phỏng đoán, vì thế hãy đối chiếu với người đang sở hữu nguồn dữ liệu đó.
Trên Azure còn thêm câu hỏi chiến lược. Microsoft cho biết workload ADF hiện có có thể nâng cấp lên Fabric. Vì vậy, đề xuất xây mới trên ADF nên đi kèm một câu hỏi thẳng với khách: họ có định chuyển sang Fabric không. Bỏ qua câu này, bạn có thể vừa bàn giao xong đã phải tính chuyện nâng cấp.
Với Dataflow, cái khó nằm ở mô hình lập trình chứ không ở hạ tầng. Beam dùng một mô hình cho cả batch lẫn streaming. Mô hình này mạnh, nhưng những ai quen viết script tuần tự sẽ cần thời gian làm quen.
Nên học gì trước
Nếu chỉ có một tháng, hãy học Spark trước. Trên Glue, bạn viết job ETL trực tiếp bằng Spark. Với ADF, Spark nằm bên dưới mapping data flow và do dịch vụ quản lý, nên kiến thức Spark giúp bạn hiểu data flow chạy thế nào, chứ không phải thứ bạn tự tay vận hành.
Sau đó học Beam đủ để đọc một pipeline Dataflow. Cuối cùng, tập đưa pipeline vào quy trình release: ADF hỗ trợ đầy đủ CI/CD qua Azure DevOps và GitHub, và khách hàng doanh nghiệp sẽ hỏi đến chuyện này.
Khi đọc mô tả tuyển dụng FDE, hãy để ý tên dịch vụ ETL được nhắc tới để biết nên ưu tiên ôn nền tảng nào. Trong CV, đừng ghi “biết AWS Glue”. Hãy viết rằng bạn đã đọc một pipeline có sẵn, tìm ra chỗ schema bị lệch và đưa bản sửa qua CI/CD.
Câu đó cho nhà tuyển dụng thấy đúng việc FDE làm ở site khách.
Công cụ ETL của khách gần như đã được chọn từ trước khi bạn đến. Điều bạn quyết định được là bạn hiểu nó nhanh đến đâu.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!