Airbyte: kéo dữ liệu của khách về một chỗ mà không phải viết script
Tuần đầu ở chỗ khách, thứ ngốn thời gian của FDE thường là đi gom dữ liệu từ năm hệ thống khác nhau, còn model thì chưa kịp động tới; Airbyte được làm ra để bớt phần việc đó.
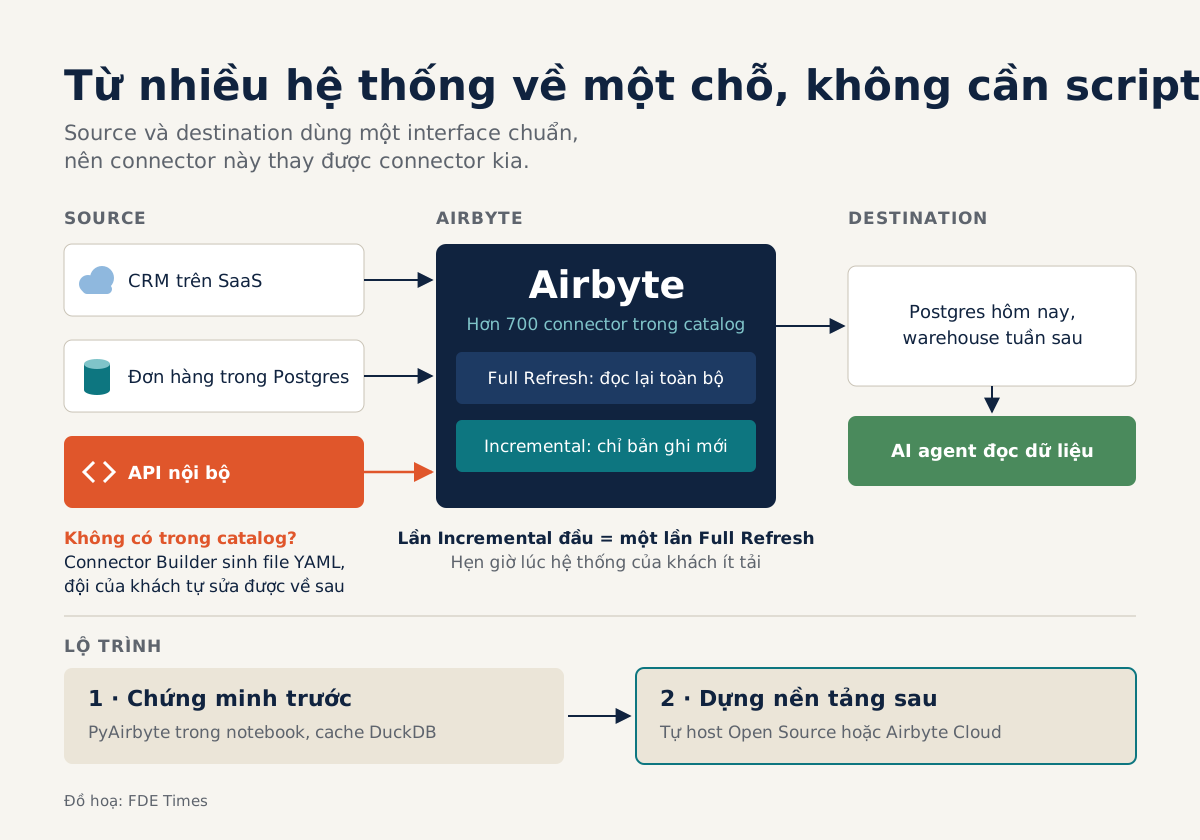
Tóm tắt nhanh
- Airbyte có catalog hơn 600 connector theo README trên GitHub, còn trang airbyte.com ghi hơn 700, phủ API, database, warehouse và data lake.
- Gặp API chưa có connector thì dùng Connector Builder, một công cụ no-code dựng trên định dạng YAML low-code.
- PyAirbyte chạy connector ngay trong code Python và mặc định lưu vào DuckDB cục bộ, đủ để làm prototype nhanh.
Ở chỗ khách, ngày đầu tiên thường diễn ra thế này: CRM nằm trên một SaaS, đơn hàng nằm trong Postgres, còn phần quan trọng nhất là một API nội bộ mà chỉ một người trong công ty hiểu. Ai cũng muốn thấy demo agent, nhưng agent chưa có dữ liệu để làm việc. Cách nhanh nhất trước mắt là viết vội vài script Python.
Đến tuần thứ ba, số script đó rất dễ thành một mớ chẳng ai dám sửa.
Airbyte sinh ra để thay mấy script đó. Dự án tự gọi mình là nền tảng mã nguồn mở để di chuyển dữ liệu, phục vụ cả pipeline ELT lẫn AI agent.
Với một developer muốn làm FDE, đây là công cụ nên học sớm, vì nó thay đổi cách bạn tiêu thời gian ở chỗ khách: bớt tự viết code kết nối, ghép các connector có sẵn lại, và dành thời gian cho bài toán chính mà khách cần giải.
Airbyte làm gì, nói ngắn gọn?
Mọi thứ trong Airbyte xoay quanh hai khái niệm là source và destination. Airbyte Protocol quy định cả hai theo một bộ interface chuẩn: destination là ứng dụng nhận dữ liệu và nạp vào kho lưu trữ, source là phía đọc dữ liệu ra. Nhờ chuẩn chung này, bạn có thể thay connector này bằng connector khác.
Hôm nay đổ vào Postgres, tuần sau chuyển sang warehouse mà khách vừa mua, phần đọc từ nguồn không phải viết lại.
Số connector có sẵn khá lớn. README trên GitHub ghi hơn 600 connector cho API, database, data warehouse, data lake và ứng dụng AI, còn trang catalog trên airbyte.com ghi hơn 700. Vì thế, khi nghe khách kể tên hệ thống của họ, việc đầu tiên là tra catalog, chưa cần mở editor.
Bạn có hai cách triển khai: tự host bản Open Source hoặc dùng Airbyte Cloud. Ở chỗ khách, chọn cách nào thường không do sở thích kỹ thuật quyết định. Nếu khách không cho dữ liệu ra khỏi hạ tầng của họ, bạn tự host. Nếu họ cần chạy được ngay và chấp nhận dịch vụ bên ngoài thì dùng Cloud.
Chứng minh trước, dựng nền tảng sau
Trong buổi discovery, nhiều khi bạn chỉ cần kéo một ít dữ liệu thật về để khách thấy agent hoạt động. PyAirbyte được làm cho tình huống này: đây là thư viện để chạy connector Airbyte ngay trong code Python. Nếu bạn không chỉ định cache, PyAirbyte tự dùng một cache DuckDB cục bộ.
Một đoạn tối thiểu, dùng connector sinh dữ liệu giả để thử, có dạng như sau:
import airbyte as ab

source = ab.get_source(
    "source-faker",
    config={"count": 1000},
    install_if_missing=True,
)
source.check()
source.select_all_streams()

# Không truyền cache -> dữ liệu nằm trong DuckDB cục bộ
result = source.read()
Vậy là từ một notebook, bạn có dữ liệu để truy vấn mà chưa phải xin quyền dựng warehouse. Khi khách đồng ý đi tiếp, bước hợp lý là chuyển sang Airbyte tự host hoặc Cloud.
PyAirbyte chạy chính các connector của Airbyte, nên nhiều khả năng phần cấu hình nguồn sẽ dùng lại được khi chuyển lên. Dù vậy, hãy chạy thử connector ngay trên môi trường đích trước khi hứa ngày bàn giao.
Một buổi chiều với dữ liệu của khách
Hãy thử hình dung khách là một chuỗi bán lẻ muốn có agent trả lời câu hỏi về đơn hàng. Bảng đơn hàng có hàng triệu dòng, ngày nào cũng thêm dòng mới, và pipeline giờ phải chạy thật trong môi trường của họ.
Bạn cấu hình source trỏ vào database, destination là nơi agent sẽ đọc, rồi chọn sync mode. Full Refresh đọc lại toàn bộ nguồn rồi ghi đè hoặc nối thêm vào đích. Incremental chỉ đọc những bản ghi được thêm vào kể từ lần sync trước. Với bảng tăng mỗi ngày, Incremental hợp lý hơn hẳn.
Có một điều tài liệu nói rõ mà nhiều người vẫn bỏ qua: lần sync Incremental đầu tiên tương đương một lần Full Refresh. Lần chạy đầu vẫn kéo toàn bộ hàng triệu dòng, nên hãy báo trước cho đội hạ tầng của khách và hẹn giờ lúc hệ thống ít tải.
Sau đó đến API nội bộ, thứ chắc chắn không có trong catalog. Lúc này bạn dùng Connector Builder, công cụ no-code nằm ngay trong giao diện Airbyte. Builder là lớp giao diện đặt lên định dạng YAML low-code, nên kết quả cuối cùng là một định nghĩa connector dạng YAML mà bạn đọc, sửa và commit vào repo như mọi file cấu hình khác.
Những gì Airbyte không làm thay bạn
Airbyte giải quyết phần chuyển dữ liệu từ chỗ này sang chỗ khác. Nó không cho bạn biết bảng nào quan trọng, cột nào có ý nghĩa gì với nghiệp vụ, hay dữ liệu bẩn đến mức nào. Những câu đó phải trả lời bằng customer discovery, ngồi cạnh người dùng của khách và hỏi cho ra nhẽ.
Catalog lớn cũng không có nghĩa là hệ thống nào của khách cũng có connector. Hệ thống càng cũ và càng tự phát triển nội bộ thì càng dễ phải dùng tới Builder, và bạn vẫn phải tự đọc tài liệu API của khách.
Vài lỗi người mới hay mắc:
| Lỗi thường gặp | Cách tránh |
|---|---|
| Chạy Incremental lần đầu giữa giờ làm việc vì nghĩ nó chỉ đọc phần mới | Lần đầu vẫn đọc toàn bộ, hẹn giờ ít tải |
| Chọn Full Refresh cho bảng tăng mỗi ngày | Dùng Incremental khi xác định được bản ghi nào là mới |
| Bật Incremental khi chưa rõ thế nào là bản ghi “mới” | Hỏi khách về dữ liệu trước khi chọn sync mode |
| Coi file DuckDB cục bộ của PyAirbyte là nơi lưu lâu dài | Xem nó là chỗ prototype, chuyển sang destination thật khi đi tiếp |
Học gì trước, ghi gì vào CV
Nếu bạn là developer Việt Nam đang muốn chuyển sang FDE, nên học theo thứ tự: nắm vững source và destination, chạy được đoạn PyAirbyte ở trên, phân biệt rõ Full Refresh với Incremental, rồi tự dựng ít nhất một connector bằng Builder.
Khi đọc JD, các cụm như “data integration”, “ELT” hay “connect to customer systems” cho thấy công ty cần đúng kỹ năng này. Trong CV, đừng chỉ ghi “biết Airbyte”; hãy viết bạn đã dựng connector cho một API không có trong catalog và đưa pipeline từ prototype sang môi trường của khách.
Khi đi phỏng vấn, đừng dừng ở việc kể tên công cụ. Hãy kể bạn đã đưa dữ liệu từ một hệ thống thật về một chỗ nhanh đến đâu, và lần sync đầu tiên đã được chuẩn bị ra sao.