Đưa AI vào nhà máy không có internet: đóng gói, cập nhật và giám sát máy edge
Không có mạng, thiếu một file trong USB là phải lái xe quay lại xưởng, còn một bản cập nhật hỏng có thể khiến dây chuyền chạy mà không ai kiểm tra lỗi.

Tóm tắt nhanh
- Binary K3s và tarball image airgap phải cùng một bản phát hành; ký cả gói để máy ở xưởng tự xác minh offline.
- Không dùng chế độ mặc định hay POLL của Triton khi cập nhật model: chép trọn vào thư mục mới rồi mới ra lệnh load.
- TTL mặc định của Azure IoT Edge chỉ giữ telemetry hai giờ, và portal cloud vẫn có thể báo 200 OK khi máy đã mất mạng.
Thử hình dung: bạn đứng cạnh một máy edge ở dây chuyền kiểm tra lỗi sản phẩm, trong túi có một chiếc USB, và mạng duy nhất trong phòng là mạng nội bộ của xưởng. Bạn không docker pull được, không pip install được, cũng không mở được dashboard trên cloud. Thứ gì không có trong chiếc USB thì hôm nay không chạy.
Có khách hàng tách mạng sản xuất khỏi internet vì an ninh, có nơi đơn giản là không có mạng.
Việc khó ở đây không phải là huấn luyện model mà là ba việc vận hành: đóng gói cho đủ, cập nhật sao cho hỏng vẫn quay lại được, và giám sát để biết máy đang thực sự làm gì.
Cả ba việc dựa trên cùng một nguyên tắc. Ở môi trường air-gap, mọi giả định về mạng phải được viết ra thành file, thành bước kiểm tra, thành giới hạn có con số. Ba phần dưới đây bám theo cùng một tình huống.
Một bản phát hành phải tự đủ
Tình huống cụ thể: một cluster K3s một node chạy Triton Inference Server, phục vụ một model phát hiện vết xước, cộng thêm một collector gửi metric về trung tâm. Theo tài liệu cài đặt air-gap của K3s, image có thể lấy từ registry upstream, từ registry mirror hoặc từ một tarball image airgap.
Ở xưởng không có ai vận hành registry riêng, cách thực tế nhất là cách thứ ba. Khi không có private OCI registry, K3s cho phép chép image thủ công vào từng node. Cách này tốn công khi có nhiều máy, nhưng với một vài máy edge thì gọn hơn nhiều so với dựng và bảo trì một registry.
Cái bẫy đầu tiên là phiên bản: K3s yêu cầu binary và archive image airgap phải lấy từ cùng một bản phát hành. Nếu bạn tải binary hôm thứ Hai, tải tarball hôm thứ Năm, rất dễ bị lệch mà không biết. Và bạn thường chỉ phát hiện ra lúc đã đứng trong nhà máy.
Vì thế, mỗi lần giao hàng nên là một gói release do script build ra, không ghép bằng tay. Gói có manifest ghi phiên bản và checksum của từng file:
usb/
  release-2026.10.1.tar              # toàn bộ nội dung bên dưới
  release-2026.10.1.sigstore.json    # bundle chữ ký của tarball
# bên trong tarball:
  manifest.sha256                    # checksum từng file
  k3s/                               # binary + image airgap CÙNG phiên bản
  images/app-images.tar              # image ứng dụng
  models/scratch-detector/3/model.onnx
Chữ ký là phần hay bị bỏ qua. Định dạng bundle của Sigstore cho phép xác minh chữ ký offline, nên máy edge tự kiểm tra được tarball trên USB đúng là thứ nhóm bạn đã ký mà không cần gọi ra ngoài. Khi bộ phận an ninh của khách hỏi làm sao biết USB không bị tráo, bạn đã có sẵn câu trả lời.
Cập nhật: thiết kế cho lần thất bại
Trên cloud, một bản deploy hỏng thường được rollback trong vài phút. Ở xưởng, nó có thể khiến dây chuyền chạy mà không có khâu kiểm tra lỗi cho tới khi có người lái xe tới. Vì vậy khi chọn cơ chế cập nhật, câu cần hỏi không phải là nó có cài được không, mà là khi hỏng thì máy nằm ở trạng thái nào.
Ở tầng hệ điều hành, Mender chia ổ thành hai phân vùng A/B. Nếu bản mới không khởi động được, bootloader nhận ra có sự cố và quay về phiên bản trước. Mender còn có chế độ standalone cho site hoàn toàn offline, cho phép áp bản cập nhật tại chỗ, chẳng hạn từ USB. Như vậy bạn có rollback tự động mà không cần server.
Ở tầng model, Triton có hai hành vi bạn cần nắm. Ở chế độ mặc định, Triton nạp model lúc khởi động rồi bỏ qua mọi thay đổi trong model repository khi server đang chạy. Bạn chép model mới vào thư mục, Triton vẫn phục vụ bản cũ; muốn bản mới có hiệu lực, bạn phải restart server hoặc chuyển sang chế độ điều khiển model explicit.
Chế độ POLL thì nguy hiểm theo chiều ngược lại. Theo tài liệu của NVIDIA, Triton có thể nhìn thấy repository đang ở giữa chừng thay đổi, chưa chép xong, và hoạt động bất thường. Chép file qua USB vào một thư mục đang được poll chính là cách dễ nhất để rơi vào trường hợp này.
Cách an toàn là dùng chế độ explicit: chép trọn phiên bản model vào một thư mục mới, kiểm tra xong rồi mới ra lệnh load. Triton có thêm một điểm cộng: nếu reload thất bại, model đang chạy được giữ nguyên. Script cập nhật có thể trông như sau:
#!/usr/bin/env bash
set -euo pipefail
USB=/media/usb
REL=release-2026.10.1

# 1. Xác minh chữ ký offline trước khi đụng vào bất cứ thứ gì
cosign verify-blob --key /etc/fde/release.pub \
  --bundle "$USB/$REL.sigstore.json" "$USB/$REL.tar"

# 2. Giải nén ra thư mục riêng, kiểm checksum theo manifest
mkdir -p "/opt/releases/$REL"
tar -xf "$USB/$REL.tar" -C "/opt/releases/$REL"
(cd "/opt/releases/$REL" && sha256sum -c manifest.sha256)

# 3. Thêm phiên bản model mới, không ghi đè phiên bản cũ
cp -r "/opt/releases/$REL/models/scratch-detector/3" /models/scratch-detector/

# 4. Triton chạy với --model-control-mode=explicit: yêu cầu nạp lại
curl -fsS -X POST localhost:8000/v2/repository/models/scratch-detector/load
Nếu bước 4 lỗi, phiên bản model cũ vẫn tiếp tục phục vụ và bạn có log để mang về phân tích. Mọi bước trong quy trình nên có tính chất này: hỏng thì đứng yên ở trạng thái tốt gần nhất.
Màu xanh trên portal có nghĩa là máy khỏe không?
Phần này làm nhiều người bất ngờ nhất. Azure IoT Edge cần kết nối IoT Hub một lần sau khi cài runtime. Sau đó thiết bị và các thiết bị phía sau nó có thể chạy với mạng chập chờn hoặc không có mạng. Nhưng khi thiết bị mất internet, trạng thái trên Azure portal vẫn có thể hiện 200 OK.
Chuyện này không chỉ của riêng Azure. Hệ thống giám sát nào chỉ chờ tin xấu cũng sẽ im lặng đúng lúc bạn cần nó nhất. Hãy giám sát bằng tín hiệu chủ động: một heartbeat có timestamp, và cảnh báo khi heartbeat ngừng, thay vì chờ máy gửi báo lỗi.
Cái bẫy thứ hai nằm ở bộ đệm. Khi offline, IoT Edge lưu telemetry tại chỗ, giới hạn bởi TTL và dung lượng đĩa, và TTL mặc định chỉ là hai giờ. Prometheus ở chế độ Agent cũng ghi tạm dữ liệu xuống đĩa khi đầu nhận mất kết nối, nhưng chỉ trong một khoảng có hạn.
Bài giới thiệu tính năng này năm 2021 ghi giới hạn là hai giờ; con số đó có thể đã thay đổi ở các phiên bản sau, nên hãy kiểm tra lại tài liệu của đúng bản bạn dùng.
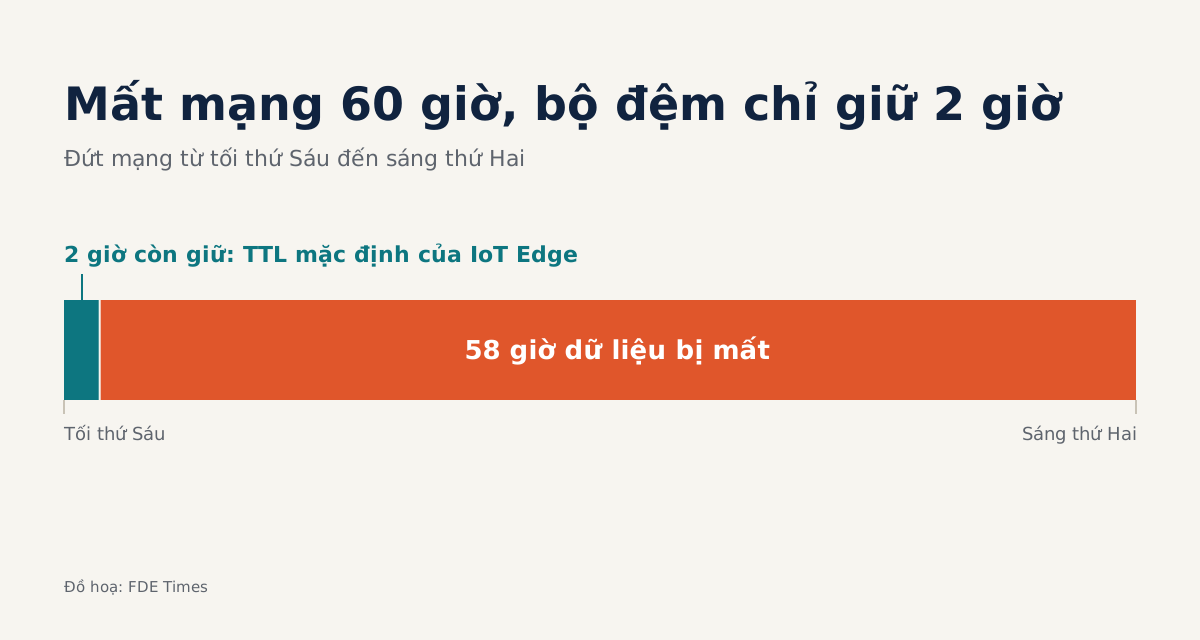
Hãy làm một phép tính. Giả sử đường truyền từ xưởng về trung tâm đứt từ tối thứ Sáu đến sáng thứ Hai, khoảng 60 giờ.
Với TTL mặc định hai giờ của IoT Edge, bộ đệm chỉ giữ được 2 trong 60 giờ đó, còn 58 giờ dữ liệu bị mất. Đó lại chính là những ca đêm bạn cần xem để biết model có bị trôi khi ánh sáng trong xưởng thay đổi hay không.
OpenTelemetry Collector có một lựa chọn tốt hơn. Khi cấu hình storage extension, hàng đợi telemetry nằm trên đĩa và thay hẳn hàng đợi trong bộ nhớ, nên dữ liệu không mất khi restart.
Nếu bạn tính dung lượng đĩa đủ cho số giờ offline lâu nhất mà khách hàng chấp nhận, thời gian giữ dữ liệu sẽ là con số bạn và khách đã chốt với nhau, chứ không còn là mặc định của công cụ.
Những lỗi gặp đi gặp lại
Lỗi phổ biến nhất là coi môi trường lab có mạng như bản chạy thử của nhà máy. Nếu bạn chưa từng cài toàn bộ release trên một máy đã rút dây mạng, bạn chưa biết release đó có đủ hay không.
Một lỗi khác là giữ nguyên mặc định: chế độ nạp model mặc định của Triton, TTL hai giờ, hàng đợi trong bộ nhớ. Mỗi mặc định đều hợp lý trên cloud và đều sai ở xưởng.
Lỗi tiếp theo là chưa bao giờ diễn tập rollback, trong khi cơ chế A/B chỉ đáng tin khi bạn đã tận mắt thấy máy quay về bản cũ trên đúng phần cứng của khách.
Lỗi cuối cùng là tin vào dashboard trên cloud. Nếu muốn biết máy có đang chạy không mà phải đi qua internet, bạn cần thêm một màn hình cục bộ cho kỹ sư vận hành tại xưởng.
Biến kỹ năng này thành lợi thế khi đi xin việc
Khi đọc mô tả công việc FDE, hãy chú ý các cụm như “air-gapped”, “on-prem”, “edge” hoặc “disconnected environments”. Đó là dấu hiệu công việc cần đúng những kỹ năng trên.
Trong CV, đừng chỉ ghi “có kinh nghiệm Kubernetes”. Hãy ghi rằng bạn đã thiết kế quy trình cập nhật offline có ký số và rollback, và bộ đệm của bạn chịu được bao nhiêu giờ mất mạng.
Để tự luyện trước buổi phỏng vấn, hãy trả lời to câu hỏi này: “Nhà máy không có internet, mỗi tháng bạn phải thay model trên vài máy edge. Bạn mang bản mới vào thế nào, máy biết gói không bị tráo bằng cách nào, và nếu model mới không load được thì dây chuyền ra sao?”
Một câu trả lời thuyết phục sẽ đi đủ bốn ý: gói release cùng phiên bản có checksum, chữ ký xác minh offline, nạp model ở chế độ explicit để bản cũ vẫn chạy khi lỗi, và heartbeat để biết cập nhật đã thành công. Nếu bỏ sót ý nào, đó là chỗ bạn cần thực hành thêm.
Ở nhà máy, ít ai nhớ model của bạn chính xác bao nhiêu phần trăm. Người ta nhớ lần cập nhật bị hỏng mà dây chuyền vẫn chạy bình thường.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
7 nguồn
- Air-Gap Install | K3s · 2026-10-07
- Operate Azure IoT Edge devices offline | Microsoft Learn · 2026-03-02
- Model Management, NVIDIA Triton Inference Server
- Introduction | Mender documentation
- Introducing Prometheus Agent Mode, an Efficient and Cloud-Native Way for Metric Forwarding · 2021-11-16
- Exporter Helper: Persistent Queue, Storage, and Retry Settings (OpenTelemetry Collector)
- Verifying Signatures | Sigstore documentation