Ký quyết định dừng pilot AI trước khi bắt đầu
Nhiều pilot AI mắc kẹt không phải vì mô hình kém, mà vì trước khi bắt đầu, không ai thống nhất "chạy tốt" nghĩa là gì.

Tóm tắt nhanh
- Dừng pilot là chuyện thường: S&P Global ghi nhận tổ chức trung bình bỏ 46% PoC AI trước khi lên production.
- Ngưỡng kết quả và giao thức phản ứng phải chốt từ ngày đầu, còn rubric chấm lỗi chỉ nên viết sau khi đã đọc log thật.
- Trước khi đổi mô hình, hãy đếm xem bao nhiêu lỗi thực ra đến từ dữ liệu, sản phẩm hay quy trình.
Tuần thứ sáu của pilot, bạn ngồi họp với khách hàng. Agent trả lời đúng khoảng ba phần tư số câu hỏi. Giám đốc vận hành hỏi “vậy là tốt hay chưa?”, và cả phòng im lặng, vì chưa ai từng viết ra “tốt” là bao nhiêu.
Cảnh này phổ biến hơn bạn nghĩ. Khảo sát của S&P Global Market Intelligence cho thấy tổ chức trung bình bỏ 46% PoC AI trước khi chúng lên production. Tỷ lệ công ty bỏ phần lớn sáng kiến AI cũng vọt từ 17% lên 42% chỉ trong một năm.
Vì thế, câu hỏi của một FDE không phải là làm sao để pilot không bao giờ thất bại. Câu hỏi đúng là: khi kết quả chưa đạt, bước tiếp theo đã được định sẵn, rõ ràng và có chữ ký của cả hai bên hay chưa? Kỹ năng này phân biệt người chạy pilot giỏi với người chỉ giỏi demo.
Pilot hỏng vì thiếu định nghĩa, không chỉ vì thiếu chất lượng
Một hướng dẫn thực hành của SoftwareSeni nói thẳng: pilot thường mắc kẹt vì trước khi bắt đầu, không ai thống nhất “chạy tốt” nghĩa là gì. Khi thiếu định nghĩa, mỗi bên đọc con số 75% theo một kiểu. Đội kỹ thuật thấy tiến bộ, bộ phận tài chính thấy rủi ro, còn nhà tài trợ dự án thấy mệt.
Gartner từng dự báo ít nhất 30% dự án GenAI sẽ bị bỏ sau giai đoạn proof of concept vào cuối 2025. Bốn lý do được nêu là dữ liệu kém, kiểm soát rủi ro chưa đủ, chi phí leo thang và giá trị kinh doanh không rõ.
Lý do cuối cùng hoàn toàn nằm trong tay bạn: giá trị chỉ “không rõ” khi không ai viết ra cách đo nó.
Tài liệu chính thức của Anthropic về đánh giá mô hình đưa ra nguyên tắc nền: thay “hiệu năng tốt” bằng một chỉ số cụ thể, đo được, và chốt nó trước khi xây eval.
Tài liệu đó cũng nhắc rằng mục tiêu không được vượt quá khả năng hiện tại của mô hình. Đặt ngưỡng 99% cho một tác vụ mà benchmark chỉ đạt 85% chẳng khác gì viết sẵn biên bản thất bại.
Ngày đầu chốt gì, và để gì cho sau?
Ở đây có một chỗ dễ nhầm. Hamel Husain, chuyên gia eval từng làm ở Airbnb và GitHub, cảnh báo rằng viết rubric trước khi nhìn dữ liệu là lỗi rất hay gặp. Theo ông, phải phân tích log để biết lỗi nào thực sự xảy ra rồi mới tạo eval.
Hai lời khuyên này không mâu thuẫn. Ngày đầu, bạn chốt chỉ số kết quả kinh doanh, các ngưỡng và giao thức phản ứng. Còn rubric chi tiết để chấm từng loại lỗi thì chỉ viết sau khi đã đọc log thật trong vài tuần đầu.
Giao thức phản ứng là phần hay bị bỏ quên nhất. SoftwareSeni khuyên thống nhất cách phản ứng trước khi bảng điểm báo thất bại, và chia việc chỉnh hướng làm hai loại.
Revive là sửa một điểm nghẽn giải quyết được mà vẫn giữ cách tiếp cận hiện tại; restructure là thiết kế lại cách tiếp cận. Còn quyết định cuối cùng ở mốc ngày 90 được cố ý thiết kế để chỉ có hai đáp án: mở rộng hoặc dừng.
Một scorecard viết từ ngày đầu trông thế nào?
Thử hình dung một pilot giả định: agent trả lời câu hỏi về hóa đơn cho đội chăm sóc khách hàng của một công ty logistics. Trước khi viết dòng code nào, bạn và trưởng nhóm CSKH ký một trang scorecard như sau.
| Mốc | Câu hỏi cần trả lời | Ngưỡng và hành động đã thỏa thuận |
|---|---|---|
| Ngày 30 | Lỗi thật trông như thế nào? | Đọc ít nhất 100 log, phân loại lỗi, viết rubric từ đó |
| Ngày 60 | Có đi đúng hướng không? | Từ 85% đúng: chuẩn bị mở rộng. 70–85% và lỗi dồn vào một nguyên nhân sửa được: revive. Dưới 70% hoặc lỗi rải rác do quy trình: restructure hoặc dừng |
| Ngày 90 | Mở rộng hay dừng? | Chỉ hai lựa chọn, người ký quyết định đã có tên từ ngày đầu |
Các con số 85% và 70% ở đây chỉ là ví dụ minh họa. Trên thực tế, bạn đặt chúng dựa vào thí nghiệm nhỏ ban đầu và năng suất hiện tại của nhân viên làm thủ công, đúng với tinh thần “khả thi” mà Anthropic nhấn mạnh.
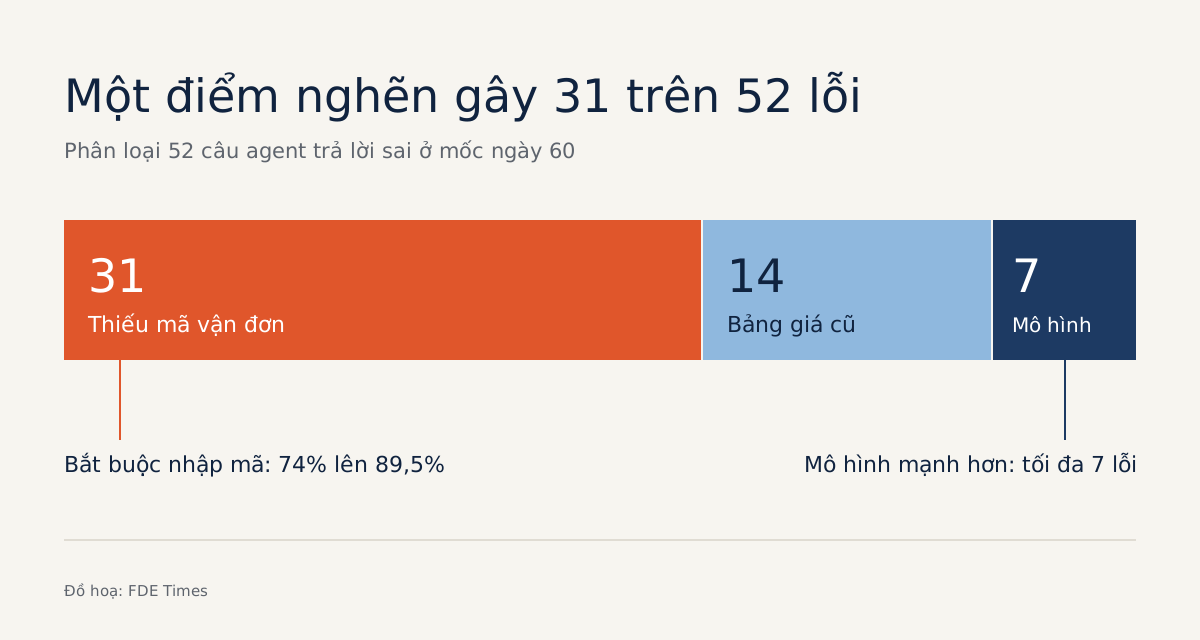
Giờ đến ngày 60. Trên tập 200 câu hỏi thật, agent trả lời đúng 148 câu, tức 74%, rơi vào vùng giữa. Chưa ai được phép kết luận vội. Bạn mở 52 câu sai ra và gắn nhãn từng câu.
Kết quả: 31 lỗi xảy ra vì người hỏi không đưa mã vận đơn, nên agent không thể tra đúng hóa đơn. 14 lỗi do agent tra vào bảng giá cũ chưa được cập nhật. Chỉ 7 lỗi là mô hình suy luận sai dù đã có đủ dữ liệu.
Đây đúng là kiểu lỗi Husain mô tả: mô hình không có cơ hội vì người dùng hỏi quá mơ hồ và không cung cấp đủ ngữ cảnh.
Nếu thêm một bước bắt buộc nhập mã vận đơn và nhờ đó sửa được 31 lỗi kia, tỷ lệ đúng có thể lên tới 179 trên 200, tức 89,5%.
Ngược lại, đổi sang mô hình mạnh hơn thì tối đa cũng chỉ xử lý được 7 lỗi.
Theo giao thức đã ký, quyết định là revive: sửa một điểm nghẽn cụ thể mà vẫn giữ cách tiếp cận hiện tại. Nhờ vậy, cuộc họp ngày 60 chỉ kéo dài mười lăm phút, vì không ai phải tranh luận lại “tốt” là gì.
Khi nào phải thiết kế lại thay vì vá?
Giả sử bảng nhãn cho ra kết quả khác: lỗi rải đều, và nhân viên CSKH bỏ qua agent vì nó nằm ngoài công cụ họ dùng hằng ngày. Đó là tín hiệu cần restructure. Báo cáo “The GenAI Divide” của MIT NANDA cho rằng các công cụ chung chung vấp ở doanh nghiệp vì chúng không học hỏi và không thích nghi với quy trình làm việc thật.
Báo cáo này đưa ra tỷ lệ thất bại 95% cho giải pháp AI doanh nghiệp, nhưng mẫu khá nhỏ nên chỉ nên xem là một chỉ báo.
Điều đáng giữ lại là chẩn đoán: nguyên nhân gốc nằm ở khoảng cách khi tích hợp vào quy trình, không phải ở chất lượng mô hình. Trong trường hợp này, restructure nghĩa là đưa agent vào đúng màn hình mà nhân viên đang dùng để làm việc.
Cũng theo báo cáo đó, các giải pháp tự xây nội bộ chỉ thành công với tỷ lệ bằng một phần ba so với khi mua từ nhà cung cấp chuyên biệt hoặc hợp tác. Vì vậy, khi restructure, hãy nghiêm túc cân nhắc phương án mua thay vì tự xây, kể cả khi chính bạn là người viết code.
Những sai lầm làm hỏng một quyết định tốt
Sai lầm đầu tiên là chấm điểm quá sớm. Rita Sallam của Gartner nhận xét rằng tác động của GenAI thường không thấy ngay mà xuất hiện dần theo thời gian. Nếu chỉ số chính là thời gian xử lý của cả đội, đừng đo nó vào tuần thứ hai, khi nhân viên vẫn đang học cách dùng.
Sai lầm thứ hai là đổi mô hình theo phản xạ. Như ví dụ trên, phần lớn lỗi có thể nằm ở form nhập liệu hay bảng giá, và không mô hình nào sửa được dữ liệu cũ. Hãy luôn đếm nhãn lỗi trước khi mở trang so sánh mô hình.
Sai lầm thứ ba là để pilot kéo dài vô thời hạn. Một pilot không có mốc ngày 90 dễ thành chuỗi “gia hạn thêm một tháng” không hồi kết. Nó đốt dần chi phí, thứ mà S&P Global xếp vào nhóm rào cản hàng đầu cùng với quyền riêng tư dữ liệu và bảo mật.
Biến kỹ năng này thành lợi thế nghề nghiệp
Trong CV, đừng chỉ viết “triển khai agent cho khách hàng”. Hãy ghi rõ bạn đã đặt scorecard ra sao, đọc bao nhiêu log và dựa vào con số nào để chọn revive hay dừng.
Nhìn vào đó, người tuyển dụng sẽ thấy bạn biết dẫn một pilot tới kết luận rõ ràng chứ không dừng lại ở bản demo.
Bài tập tuần này: chọn một pilot bạn từng làm, kể cả pilot đã kết thúc, rồi viết lại scorecard lẽ ra phải có từ ngày đầu. Nếu không viết nổi ngưỡng ngày 60 cho nó, bạn đã hiểu vì sao cuộc họp năm đó im lặng.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
8 nguồn
- Gartner predicts 30% of generative AI projects will be abandoned after proof of concept by end of 2025 · 2024-08-05
- AI project failure rates are on the rise: report · 2025-03-14
- MIT report: 95% of generative AI pilots at companies are failing · 2025-08-18
- Define success criteria and build evaluations
- Automating Error Analysis · 2026-06-24
- Hamel Husain explains why AI evals fail before the evaluation begins · 2026-07
- How to Define Production Readiness Before an AI Pilot Begins · 2026-03-19
- When to Kill, Revive, or Restructure a Stalled AI Pilot · 2026-03-19