Vì sao đếm log lỗi của khách sẽ sai nếu chưa chuẩn hoá
Vài chục dòng Python với re và Counter đủ biến một file log hỗn độn thành bảng top lỗi để mang vào cuộc họp với khách.
Tóm tắt nhanh
- Đếm thông điệp lỗi thô gần như vô dụng vì mã đơn, số mili giây hay ID làm mỗi dòng thành một nhóm riêng.
- Quy trình chuẩn: regex có named group để tách trường, re.sub để thay phần biến thiên, Counter.most_common để xếp hạng.
- Khi số mẫu log vượt quá sức viết tay, Drain3 tự học template và thay token khác nhau bằng <*>.
Theo tài liệu logging của Python, Logger.exception() ghi cả stack trace đi kèm thông điệp. Vì thế file log bạn nhận từ khách hiếm khi gọn gàng một dòng một lỗi: một lỗi có thể kéo theo mười dòng traceback, và những dòng đó không có thời điểm hay mức log nào ở đầu.
Thêm một vấn đề nữa. Thông điệp lỗi thường chứa mã đơn hàng, số mili giây, địa chỉ bộ nhớ. Nếu bạn đếm thẳng các thông điệp thô, cùng một lỗi timeout sẽ bị tách thành hàng trăm nhóm khác nhau, mỗi nhóm một lần, và bảng thống kê nói rằng không có lỗi nào nổi trội.
Với một FDE, câu hỏi đầu tiên khi khách gửi log gần như luôn là “lỗi nào xảy ra nhiều nhất?”. Bài này dựng một script Python nhỏ trả lời câu đó, chỉ dùng thư viện chuẩn: re và collections.Counter. Bạn cần Python 3 và một file log để thử.
Bắt đầu từ một file log mẫu
Định dạng dưới đây là ví dụ tự dựng, đã đơn giản hoá. Log thật của khách sẽ khác, nhưng cấu trúc thường giống: phần có cấu trúc ở đầu dòng, phần chữ tự do ở cuối. Lưu nó thành app.log:
2026-11-03 09:14:22 [ERROR] [payments] Timeout calling bank API order=84213 after 3000ms
2026-11-03 09:14:25 [INFO] [api] GET /orders/84213 200
2026-11-03 09:14:31 [ERROR] [payments] Timeout calling bank API order=90117 after 3012ms
2026-11-03 09:15:02 [ERROR] [worker] Failed to process job 5521
Traceback (most recent call last):
  File "worker.py", line 42, in run
KeyError: 'customer_id'
2026-11-03 09:15:40 [ERROR] [worker] Failed to process job 5530
Traceback (most recent call last):
  File "worker.py", line 42, in run
KeyError: 'customer_id'
Để ý sáu dòng không bắt đầu bằng thời điểm. Đó là traceback của hai lỗi job 5521 và 5530, và mỗi khối phải đi theo dòng đứng trước nó.
Nếu khách dùng cấu hình mặc định của Python, định dạng còn đơn giản hơn: severity:logger name:message, theo tài liệu logging. Các mức chuẩn gồm từ DEBUG đến CRITICAL, nên bạn có sẵn một danh sách để lọc.
Bước 1: một regex đọc được sau ba tháng
Tạo file logtop.py. Viết regex dưới dạng raw string (tiền tố r) để Python không xử lý các dấu gạch chéo như \d trước khi regex thấy chúng. Dùng re.VERBOSE để chia pattern thành từng đoạn có chú thích:
import re
from collections import Counter

LINE = re.compile(r"""
    ^(?P<ts>\d{4}-\d{2}-\d{2}\ \d{2}:\d{2}:\d{2})\s+  # thời điểm
    \[(?P<level>.+?)\]\s+                             # mức log
    \[(?P<logger>.+?)\]\s+                            # tên logger
    (?P<msg>.*)$                                      # phần chữ tự do
""", re.VERBOSE)
Mỗi (?P<name>...) là một named group, cú pháp riêng của Python, cho phép lấy trường theo tên thay vì theo vị trí. Pattern được re.compile() một lần ở đầu file; tài liệu re ghi rõ cách này hiệu quả hơn khi cùng một biểu thức chạy nhiều lần, mà ở đây là hàng triệu dòng.
Chi tiết dễ bỏ qua là dấu ? sau .+. Nó biến quantifier thành non-greedy, khớp ít ký tự nhất có thể. Với các dòng mẫu ở trên, bỏ ? đi regex vẫn tách đúng, vì bộ khớp lùi lại cho tới khi phần còn lại của pattern khớp được.
Rắc rối đến khi chính thông điệp có ngoặc vuông. Thử phần sau thời điểm là [ERROR] [api] Rejected [role] [admin] for user 7: bản greedy dừng ở dấu ] xa nhất còn khớp được, cho level là ERROR] [api] Rejected [role và logger là admin. Bản non-greedy dừng ở dấu ] đầu tiên và cho đúng ERROR và api.
Lưu ý thêm: trong chế độ VERBOSE khoảng trắng bị bỏ qua, nên dấu cách giữa ngày và giờ phải viết là \ .
Kiểm tra: chạy LINE.match(...) với dòng đầu tiên trong REPL, gọi .groupdict() và xem level có đúng là ERROR không. Sau đó thử dòng có ngoặc vuông trong thông điệp ở trên.
Bước 2: gắn traceback vào đúng lỗi
groupdict() trả về mọi named group dưới dạng dictionary, vừa vặn để biến một dòng thành một bản ghi. Dòng nào không khớp pattern thì coi là phần nối tiếp của bản ghi trước:
def parse(path):
    records = []
    with open(path, encoding="utf-8") as f:
        for raw in f:
            line = raw.rstrip("\n")
            m = LINE.match(line)
            if m:
                rec = m.groupdict()
                rec["trace"] = []
                records.append(rec)
            elif records:
                records[-1]["trace"].append(line)
    return records
Kiểm tra: file mẫu có 11 dòng nhưng bạn phải có 5 bản ghi, và hai bản ghi job 5521 và 5530 mỗi bản có trace dài 3 dòng. Nếu ra nhiều hơn 5, regex đang khớp nhầm các dòng traceback.
Bước 3: chuẩn hoá trước, rồi mới đếm
Đây là bước quyết định cả bảng kết quả. re.sub thay mọi lần xuất hiện của pattern nếu bạn không truyền tham số count, nên mỗi luật chỉ cần một lệnh:
RULES = [
    (re.compile(r"0x[0-9a-fA-F]+"), "<HEX>"),
    (re.compile(r"\d+"), "<NUM>"),
]

def normalise(text):
    for pat, placeholder in RULES:
        text = pat.sub(placeholder, text)
    return text

def signature(rec):
    sig = normalise(rec["msg"])
    if rec["trace"]:
        sig += " | " + normalise(rec["trace"][-1].strip())
    return sig
Thứ tự luật có ý nghĩa: nếu thay số trước, 0x7f3a sẽ thành <NUM>x<NUM>f<NUM>a và luật HEX không còn gì để bắt. Sau bước này, hai dòng timeout trong file mẫu cùng trở thành Timeout calling bank API order=<NUM> after <NUM>ms.
Traceback gắn ở bước 2 giờ mới có việc. Trong file mẫu, thông điệp “Failed to process job” không nói vì sao job hỏng; dòng cuối của traceback mới nói: KeyError: 'customer_id'.
Nối dòng đó vào chữ ký, hai lỗi worker thành Failed to process job <NUM> | KeyError: 'customer_id', và nếu mai kia cùng thông điệp đó đi kèm một exception khác, nó sẽ thành nhóm riêng thay vì bị gộp chung.
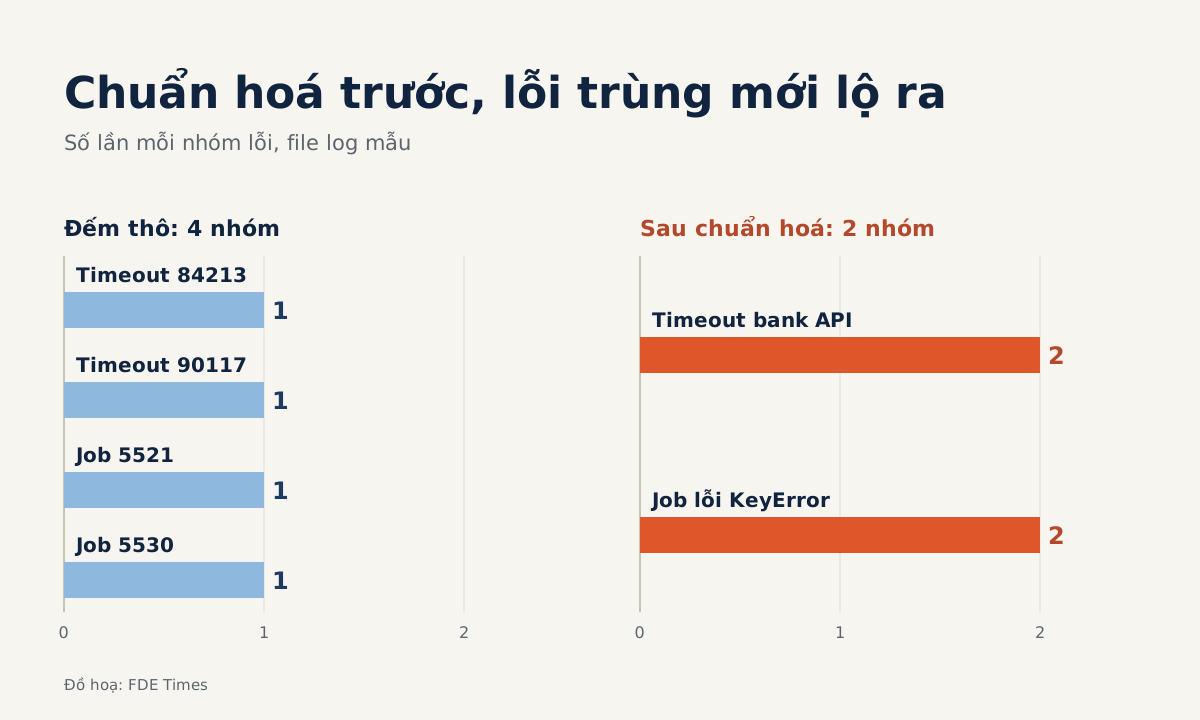
Hãy làm phép tính với file mẫu. Đếm thô, bốn dòng ERROR cho ra bốn nhóm, mỗi nhóm một lần, tức là không có thông tin gì. Sau chuẩn hoá chỉ còn hai nhóm, mỗi nhóm hai lần. Trên log thật cỡ hàng chục nghìn dòng, khoảng cách đó là ranh giới giữa một bảng vô dụng và một danh sách việc cần sửa.
Bước 4: xếp hạng, kèm nơi và lúc lỗi bắt đầu
Counter là lớp con của dict dùng để đếm các đối tượng hashable, và chuỗi chữ ký là hashable. most_common(n) trả về n phần tử phổ biến nhất kèm số lần, xếp từ nhiều đến ít. Song song với việc đếm, script giữ lại thời điểm sớm nhất và logger của lần xuất hiện đó cho từng chữ ký:
if __name__ == "__main__":
    records = parse("app.log")
    errors = [r for r in records if r["level"] in ("ERROR", "CRITICAL")]
    counts = Counter()
    first = {}
    for r in errors:
        sig = signature(r)
        counts[sig] += 1
        if sig not in first or r["ts"] < first[sig][0]:
            first[sig] = (r["ts"], r["logger"])
    for sig, n in counts.most_common(10):
        ts, logger = first[sig]
        print(f"{n:>6}  {ts}  [{logger}]  {sig}")
So sánh r["ts"] dạng chuỗi chỉ đúng vì định dạng mẫu đi từ năm đến giây; nếu log của khách ghi giờ kiểu khác, hãy đổi sang datetime trước khi so. Đây cũng là bản đơn giản hoá: mỗi chữ ký chỉ giữ logger của lần đầu, nên nếu cùng một lỗi đến từ nhiều logger, bạn sẽ cần một Counter riêng cho logger.
Chạy python3 logtop.py. Kiểm tra: kết quả phải giống thế này:
     2  2026-11-03 09:14:22  [payments]  Timeout calling bank API order=<NUM> after <NUM>ms
     2  2026-11-03 09:15:02  [worker]  Failed to process job <NUM> | KeyError: 'customer_id'
Nếu thấy bốn dòng, luật chuẩn hoá chưa chạy hoặc thứ tự luật sai. Nếu lỗi worker tách làm hai, hãy xem lại traceback đã được gắn đúng bản ghi ở bước 2 chưa.
Những lỗi khiến con số đánh lừa bạn
Quên raw string là cái bẫy phổ biến nhất. Không có tiền tố r, một số chuỗi thoát như \b bị Python hiểu trước, và regex lặng lẽ khớp sai mà không báo lỗi. Để greedy ở các trường trong ngoặc cũng nguy hiểm theo cách tương tự, như dòng có [role] [admin] ở bước 1.
Khó thấy hơn là chuẩn hoá quá tay. Luật \d+ biến HTTP 502 và HTTP 404 thành cùng một chữ ký, trong khi đó là hai vấn đề rất khác nhau với khách. Khi chữ ký đứng đầu bảng trông quá chung chung, hãy mở vài bản ghi gốc ra đọc trước khi kết luận.
Khi nào regex viết tay không còn đủ
Bộ luật tay chạy tốt khi khách có một hai dịch vụ. Khi log đến từ hàng chục dịch vụ với định dạng khác nhau, danh sách RULES sẽ phình ra nhanh hơn tốc độ bạn bảo trì được. Đó là lúc nên nhìn sang Drain3, thư viện mã nguồn mở tự học log template từ log thô ngay khi log chảy vào.
Ý tưởng của Drain không xa những gì bạn vừa viết. Thuật toán lưu các mẫu đã học trong một cây phân tích và thay những token không khớp bằng ký tự đại diện <*>, giống hệt cách <NUM> thay cho mã đơn.
Tài liệu Drain3 cũng khuyên chỉ đưa vào phần chữ tự do, bỏ timestamp và hostname, nên regex ở bước 1 vẫn có ích để cắt trường msg trước khi đưa vào.
Mang bảng top lỗi vào cuộc họp
Ra được bảng top 10 lỗi ngay buổi đầu tiên cho bạn một câu chuyện cụ thể để mở cuộc họp: lỗi này xuất hiện nhiều nhất, nó đến từ logger này, bắt đầu từ thời điểm này, và nguyên nhân gốc nằm ở dòng cuối traceback. Nên viết script sao cho chỉ cần đổi đường dẫn file và regex dòng, vì định dạng log mỗi khách mỗi khác.
Nếu bạn đang nhắm vai trò FDE, hãy đưa script này lên GitHub với một file log mẫu đã ẩn dữ liệu, và trong CV mô tả nó bằng kết quả: số dòng log đã xử lý, số nhóm lỗi trước và sau chuẩn hoá.
Khi đọc tin tuyển dụng, để ý những dòng nói về xử lý sự cố production hay sự cố của khách: đó là chỗ để kể về công cụ này trong buổi phỏng vấn.
Lần tới khách gửi một file log vài trăm megabyte kèm câu “hệ thống chậm lắm”, bạn sẽ có câu trả lời bằng con số trước khi cuộc gọi thứ hai bắt đầu.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
6 nguồn
- Regular expression HOWTO — Python 3.15.2 documentation
- re — Regular expression operations — Python 3.15.2 documentation
- collections — Container datatypes — Python documentation
- Logging HOWTO — Python 3.15.2 documentation
- logpai/Drain3 (GitHub)
- Drain: simgple but effective log parsing algorithm · 2026-04-20