Sinh 96 ca test bằng LLM, giữ lại 50 ca đáng tin
Bảo LLM viết câu hỏi test thì nhanh, phần khó là bỏ đi những ca mà chính bạn cũng không chấm được đúng sai.

Tóm tắt nhanh
- Lập tổ hợp các chiều trước rồi mới viết câu hỏi, và bám vào tài liệu thật của khách hàng.
- Tự tay chấm ít nhất 30 trace, chỉ giữ những ca mà hai người chấm độc lập cùng kết luận.
- Dữ liệu tổng hợp dùng để tìm lỗi, không cho biết lỗi đó xảy ra thường xuyên đến mức nào trên production.
Chỉ trong vài phút, một LLM có thể viết ra hàng trăm câu hỏi test cho agent của bạn. Vấn đề là nhiều câu na ná nhau, và có những câu mà chính bạn cũng không chắc agent trả lời thế nào thì mới đúng.
Anthropic, trong hướng dẫn về eval cho agent, nhận định rằng 20-50 tác vụ đơn giản lấy từ các lỗi thật đã là một điểm khởi đầu tốt. Như vậy, sinh thật nhiều câu hỏi không khó. Cái khó là chọn ra vài chục ca mà bạn dám dùng làm chuẩn.
Hướng dẫn này đi từ một danh sách các chiều đến 96 trace, rồi lọc tay còn 50 ca. Bạn cần Python 3, một agent chạy được trên máy (hoặc staging), quyền gọi một LLM, và tài liệu nghiệp vụ thật của khách hàng. Code dưới đây đã được đơn giản hóa: call_llm và run_agent là hàm bọc do bạn tự viết, không phải API của thư viện nào.
Bước 1: Đừng bảo LLM viết câu hỏi ngay
Hamel Husain và Shreya Shankar khuyên nên sinh câu hỏi tổng hợp từ các tổ hợp chiều (tuple), trong đó mỗi tổ hợp lấy đúng một giá trị của mỗi chiều. Thử hình dung agent chăm sóc khách hàng của một công ty giao hàng, với bốn chiều: ý định, kiểu khách, mức đầy đủ của thông tin, và việc agent nên làm hay nên từ chối.
import itertools, json

DIMENSIONS = {
    "intent": ["track_order", "change_address", "refund"],
    "persona": ["new_customer", "angry_customer"],
    "info": ["complete", "missing_order_id"],
    "expectation": ["should_act", "should_refuse"],
}
tuples = [dict(zip(DIMENSIONS, combo))
          for combo in itertools.product(*DIMENSIONS.values())]
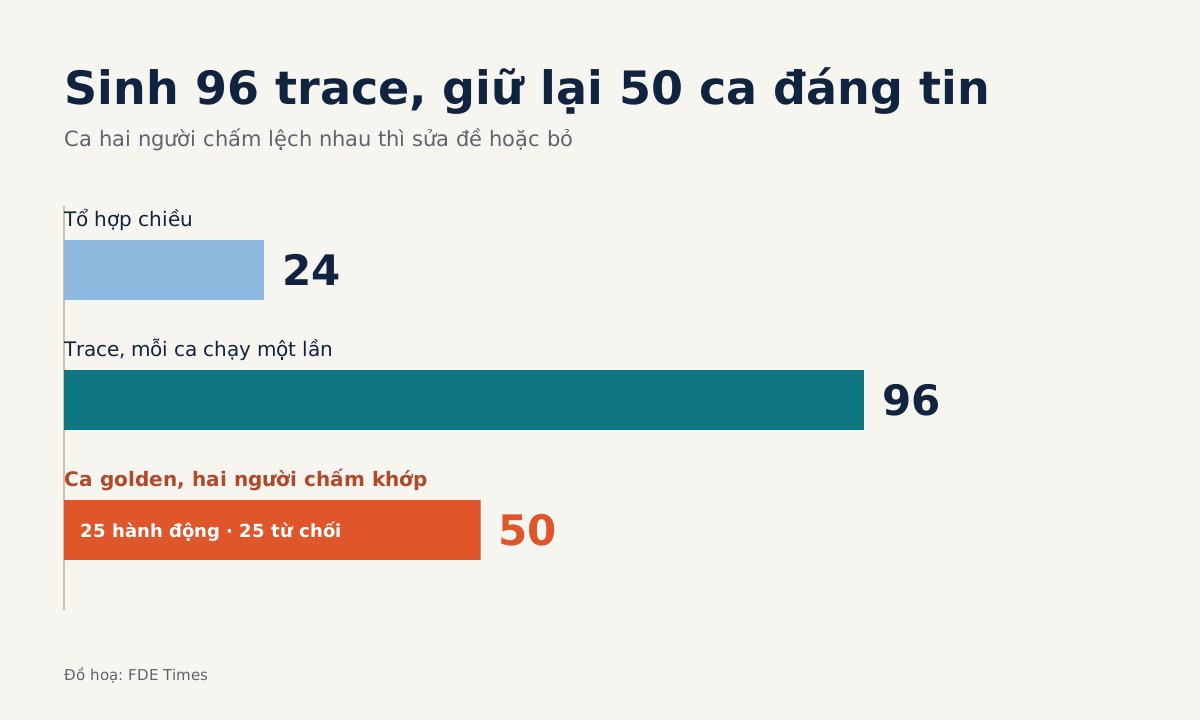
print(len(tuples))  # 3 * 2 * 2 * 2 = 24
Kiểm tra: bạn có đúng 24 tổ hợp, và nhìn từng dòng là biết ngay ca đó thử cái gì. Nếu nghiệp vụ thật có tổ hợp vô nghĩa, hãy xóa nó ngay ở bước này, vì viết câu hỏi xong rồi mới bỏ thì tốn công hơn nhiều. Ví dụ dưới giữ đủ 24 tổ hợp cho dễ tính; nếu bạn xóa bớt, hãy tăng số câu mỗi tổ hợp để tập vẫn quanh mốc 100.
Chiều expectation có mặt ở đây là có lý do. Anthropic cảnh báo rằng eval chỉ có một phía sẽ khiến bạn tối ưu agent lệch về một phía. Nếu mọi ca đều chờ agent hoàn tiền, bạn sẽ thưởng cho một agent hoàn tiền bừa.
Bước 2: Viết câu hỏi ở một lượt gọi riêng, bám vào tài liệu thật
Hamel và Shreya giải thích rằng tách bước sinh tổ hợp khỏi bước viết câu hỏi giúp câu hỏi không lặp cách diễn đạt. Tài liệu của DeepEval coi việc sinh dựa trên tài liệu là lựa chọn mặc định mạnh nhất, vì câu hỏi bám vào kho kiến thức của bạn.
Ngược lại, để LLM tự nghĩ câu hỏi mà không đưa tài liệu nào là cách ít bám dữ liệu thật nhất, chỉ nên dùng khi bài toán đơn giản.
policy = open("refund_policy.md").read()  # the customer's real document

def write_queries(t, n=4):
    prompt = (
        f"Using only this policy:\n{policy}\n\n"
        f"Write {n} different customer messages for: {json.dumps(t)}. "
        "One message per line. Vary wording and length."
    )
    return call_llm(prompt).splitlines()  # simplified wrapper

cases = []
for i, t in enumerate(tuples):
    for j, q in enumerate(write_queries(t)):
        cases.append({"id": f"c{i}_{j}", **t, "query": q})
print(len(cases))  # 24 * 4 = 96
Kiểm tra: đọc lướt 10 câu bất kỳ. Nếu thấy năm câu mở đầu giống hệt nhau, hãy quay lại xem prompt có đang nhận tổ hợp hay không.
Bước 3: Chạy agent một lần mỗi ca, lưu trace và đọc chúng
Trong hướng dẫn này, một trace là một lần chạy agent trên một ca. Ở bước này mỗi ca chỉ chạy một lần, nên 96 ca cho đúng 96 trace, và trace mang luôn id của ca. Theo Hamel và Shreya, khoảng 100 trace đa dạng là một tập khởi đầu hữu ích để tìm lỗi.
with open("traces.jsonl", "w") as f:
    for c in cases:
        out = run_agent(c["query"])  # simplified wrapper
        f.write(json.dumps({**c, "trace": out}) + "\n")
Kiểm tra: file có 96 dòng. Mở ra và tự đọc các trace, đừng chỉ đếm dòng. Đây là lúc bạn ghi chú những lỗi đầu tiên.
Bước 4: Một ca chỉ đáng tin khi hai người chấm giống nhau
Bước này quyết định bộ test có đáng tin hay không. Hamel và Shreya khuyên bạn tự chú thích ít nhất 30 trace, thay vì tin vào gợi ý tự động. DeepEval cũng dặn phải rà soát, sửa và bổ sung các golden được sinh ra trước khi coi chúng là đáp án chuẩn.
Tiêu chí lọc rõ nhất đến từ Anthropic: một tác vụ tốt là tác vụ mà hai chuyên gia trong ngành, chấm độc lập, sẽ cùng ra kết luận đạt hay trượt.
Vì vậy bạn chấm 96 trace vào một file, một người hiểu nghiệp vụ phía khách hàng chấm vào file khác, và hai người không xem bài của nhau. Vì mỗi ca chỉ có một trace, chấm theo id là chấm cả ca lẫn trace.
import csv

def load(path):
    return {r["id"]: r["verdict"] for r in csv.DictReader(open(path))}

a, b = load("labels_me.csv"), load("labels_ops.csv")
agreed = [i for i in a if i in b and a[i] == b[i]]
disputed = [i for i in a if i in b and a[i] != b[i]]
print(len(agreed), len(disputed))
Thử hình dung kết quả: 96 trace, hai người lệch nhau ở 30. Đừng vội xóa cả 30.
Mỗi ca bị lệch là một câu hỏi về chính sách mà khách hàng chưa trả lời rõ, ví dụ khách bực bội đòi hoàn tiền cho đơn trễ một ngày thì có được không.
Ca nào sửa được đề cho rõ thì giữ lại, ca nào mơ hồ từ gốc thì bỏ.
Bước 5: Chạy lại nhiều lần, cắt xuống 50 ca và giữ cân bằng hai phía
Giờ mới đến lúc chạy lặp. Với các ca đã thống nhất, chạy agent thêm ba lần mỗi ca, vì Anthropic nhấn mạnh rằng bạn chỉ biết bộ chấm có làm đúng việc hay không khi đọc transcript và điểm của nhiều lần chạy.
with open("trials.jsonl", "w") as f:
    for c in cases:
        if c["id"] not in agreed:
            continue
        for trial in range(3):
            out = run_agent(c["query"])  # simplified wrapper
            f.write(json.dumps({"id": c["id"], "trial": trial, "trace": out}) + "\n")
Tìm những ca agent trượt ở cả ba lần. Theo Anthropic, một tác vụ không bao giờ qua thường là dấu hiệu đề bị hỏng, hiếm khi do agent kém. Hãy đọc lại đề: có thể câu hỏi đòi một thông tin không hề có trong tài liệu chính sách.
Sau đó đếm theo chiều expectation. Mục tiêu hợp lý là khoảng 25 ca agent nên hành động và 25 ca agent nên từ chối, đồng thời mỗi ý định đều có mặt. Ghi 50 ca này vào golden.jsonl, kèm kết luận đạt/trượt đã thống nhất và một dòng giải thích vì sao.
Những lỗi hay gặp
Lỗi đắt nhất là đem tỷ lệ trượt trên bộ tổng hợp đi báo cáo như tỷ lệ lỗi thật. Hamel và Shreya nói thẳng rằng dữ liệu tổng hợp không cho biết một lỗi phổ biến đến mức nào trên production. Nếu agent trượt 10 trên 50 ca, bạn biết nó có những kiểu lỗi đáng sửa, nhưng không biết 20% khách hàng sẽ gặp lỗi.
Một lỗi khác bắt đầu từ prompt không kèm tài liệu. Thử hình dung bạn bảo LLM viết câu hỏi về hoàn tiền mà không dán chính sách vào: nó có thể tự giả định hạn hoàn tiền 30 ngày trong khi khách hàng chỉ cho 7 ngày.
Khi đó agent làm đúng chính sách thật lại bị chấm trượt, đúng loại rủi ro khiến DeepEval xếp cách sinh từ con số không vào nhóm ít bám dữ liệu nhất.
Bộ test một phía thì khó phát hiện vì điểm trông rất đẹp. Nếu cả 50 ca đều là khách đủ điều kiện hoàn tiền, một agent hoàn tiền cho mọi yêu cầu sẽ đạt 50 trên 50. Bạn chỉ biết nó sai khi gặp khách không đủ điều kiện ngoài đời thật.
Lỗi cuối nằm ở bộ chấm tự động. Giả sử bộ chấm cho đạt mọi câu trả lời có chữ “đã hoàn tiền”, kể cả khi agent hoàn tiền cho một đơn mà chính sách không cho phép. Điểm tổng vẫn đẹp, và chỉ khi mở transcript của nhiều lần chạy ra đọc, như Anthropic khuyên, chuyện đó mới lộ ra.
Kỹ năng này xuất hiện ở đâu khi làm cho khách hàng?
Tại site khách hàng, bạn thường phải demo agent trước khi có đủ log thật. Bộ 50 ca này giúp bạn có thứ để đo ngay từ tuần đầu. Buổi chấm chung với đội vận hành của khách thực chất là một buổi customer discovery: mỗi ca hai bên chấm lệch nhau là một quy tắc nghiệp vụ chưa ai viết ra.
Khi đã có traffic thật, nên bổ sung vào bộ test các ca lấy từ lỗi thật, vì đó chính là loại tác vụ mà Anthropic coi là điểm khởi đầu tốt.
Nếu muốn ghi kỹ năng này vào CV, hãy viết theo quy trình và con số: dựng bộ eval 50 ca từ 96 trace, có hai người chấm độc lập, cân bằng hai phía.
Nhà tuyển dụng FDE đọc dòng đó sẽ hiểu bạn biết đo, chứ không chỉ biết demo.
Kết quả cuối cùng nằm ở file golden.jsonl. Còn những ca bạn đã gạch bỏ và lý do gạch bỏ chúng mới là thứ khách hàng cần đọc nhất, vì đó là bản ghi các quy tắc nghiệp vụ chưa ai từng viết ra.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!