Router email chia đội: dựng bộ eval 40 mẫu trước khi viết agent
Một nhãn enum, một file pytest và 40 email thật cho bạn con số để bảo vệ thiết kế trước người phỏng vấn.
Tóm tắt nhanh
- Routing nghĩa là phân loại rồi chuyển tiếp. Hãy bắt đầu bằng một bộ phân loại đơn giản, chưa cần agent nhiều bước.
- Ép nhãn vào enum qua Structured Outputs và coi refusal là tín hiệu để chuyển cho người xem.
- Bộ 40 mẫu phải giống phân bố email thật và có ca mơ hồ. Chấm bằng so khớp chuỗi rồi đọc riêng điểm của từng đội.
Gặp đề “thiết kế hệ thống tự chuyển email tới đúng đội”, nhiều ứng viên vẽ ngay một agent nhiều bước, có memory, có tool, có vòng lặp tự sửa. Một câu trả lời chắc tay hơn đi theo hướng ngược lại: một bộ phân loại đơn giản và một con số chứng minh nó chạy tốt.
Anthropic, trong bài “Building effective agents”, mô tả routing là bước phân loại input rồi giao nó cho một tác vụ chuyên biệt ở phía sau.
Chính tài liệu đó khuyên chỉ thêm độ phức tạp khi nó cải thiện kết quả một cách đo được. Vì vậy bài hướng dẫn này dựng hai thứ đi cùng nhau: một router và một bộ eval 40 mẫu để đo nó.
Với FDE, đây không chỉ là bài tập phỏng vấn. Thử hình dung hộp thư chung của một khách hàng, kiểu support@ hay contact@, nơi email của mọi đội đổ về một chỗ. Nếu được giao tự động hóa nó, người mang theo bảng điểm của từng đội vào buổi demo sẽ dễ được khách hàng tin hơn người chỉ có một bản demo đẹp.
Bạn sẽ dựng gì, cần gì?
Bạn sẽ có ba file: router.py gọi model và trả về một nhãn đội, evals/routing.jsonl chứa 40 email đã gán nhãn, và evals/test_routing.py chấm tự động. Bạn cần Python, pytest và quyền gọi API của một model có hỗ trợ đầu ra theo schema.
Đoạn gọi model bên dưới được viết giản lược. Hàm call_llm_structured chỉ là chỗ để bạn thay bằng lời gọi Structured Outputs thật của nhà cung cấp mình dùng, theo đúng tài liệu của họ.
Bước 1: nhãn đội là một enum, không phải câu chữ tự do
Lỗi hay gặp nhất là để model trả về câu kiểu “Email này có lẽ thuộc về đội kế toán”. Code phía sau phải tự bóc nhãn ra, và mỗi cách viết khác đi một chút là một bug. Hãy khóa danh sách nhãn ngay từ đầu:
TEAMS = ["billing", "tech_support", "sales", "legal", "human_triage"]

ROUTE_SCHEMA = {
    "type": "object",
    "properties": {
        "team": {"type": "string", "enum": TEAMS},
        "reason": {"type": "string"},
    },
    "required": ["team", "reason"],
    "additionalProperties": False,
}
Tài liệu của OpenAI phân biệt rõ hai chế độ: JSON mode không bảo đảm đầu ra khớp schema, chỉ Structured Outputs mới bảo đảm. Họ cũng nói Structured Outputs giúp bỏ được phần code kiểm tra và gọi lại khi model trả về sai định dạng.
Nhãn human_triage là lựa chọn thiết kế của riêng bạn, không đến từ tài liệu nào. Đó là lối thoát khi model không chắc, và là chỗ đáng chuẩn bị sẵn lời giải thích nếu bị hỏi.
Kiểm tra: in ROUTE_SCHEMA ra rồi đọc lại. Mỗi đội của khách hàng phải có đúng một nhãn, không có hai nhãn trùng nghĩa.
Bước 2: prompt định nghĩa đội, code xử lý refusal
SYSTEM_PROMPT = """Bạn phân loại email gửi tới hộp thư chung.
billing: hóa đơn, thanh toán, hoàn tiền.
tech_support: lỗi sản phẩm, đăng nhập, tích hợp.
sales: báo giá, mua thêm, dùng thử.
legal: hợp đồng, dữ liệu cá nhân, khiếu nại pháp lý.
human_triage: không thuộc đội nào hoặc thuộc nhiều đội ngang nhau."""

def route(email_text: str) -> dict:
    # giản lược: thay bằng lời gọi Structured Outputs thật
    resp = call_llm_structured(SYSTEM_PROMPT, email_text, ROUTE_SCHEMA)
    if resp.refusal:
        return {"team": "human_triage", "reason": "model refused"}
    return resp.parsed
OpenAI cho biết với Structured Outputs, việc model từ chối vì lý do an toàn có thể phát hiện được bằng code. Router không nên để những email đó rơi mất. Chuyển chúng cho người xem là cách an toàn nhất.
Để định nghĩa đội nằm trong prompt có một lợi thế lớn khi làm thực tế với khách hàng. Hướng dẫn ticket routing của Anthropic chỉ ra rằng model có thể thích nghi khi định nghĩa nhóm thay đổi hoặc có nhóm mới mà không cần gán nhãn lại nhiều dữ liệu huấn luyện.
Khi khách hàng tái cấu trúc và gộp sales với billing, bạn sửa vài dòng prompt rồi chạy lại eval.
Bước 3: 40 mẫu phải trông giống hộp thư thật
Tài liệu về eval của Anthropic yêu cầu bộ eval phản ánh đúng phân bố của tác vụ thật và không quên các ca biên.
Hướng dẫn ticket routing của họ cho rằng chỉ vài chục ví dụ có nhãn đã đủ để model phân loại tốt. Đó là nói về dữ liệu đưa cho model, không phải về kích thước bộ eval. Con số 40 ở đây là một lựa chọn thực dụng: đủ để thấy lỗi lặp lại ở từng đội, đủ ít để bạn tự gán nhãn trong một buổi chiều.
Thử hình dung hộp thư của một công ty SaaS. Một cách chia hợp lý, và đây chỉ là gợi ý, là 30 email điển hình chia theo tỷ lệ thật giữa các đội, 6 email mơ hồ và 4 email rác hoặc lạc đề.
Anthropic xếp vào nhóm ca biên những ca mơ hồ mà ngay cả con người cũng khó thống nhất. Ví dụ là email “hóa đơn tháng này sai vì tính năng xuất báo cáo bị lỗi”, vừa là chuyện billing vừa là chuyện kỹ thuật.
{"id": "e07", "email": "Hóa đơn tháng 10 tính 2 lần...", "expected": "billing", "tag": "typical"}
{"id": "e33", "email": "Hóa đơn sai vì export lỗi...", "expected": "human_triage", "tag": "ambiguous"}
Với ca mơ hồ, nhãn đúng không tự nhiên mà có. Bạn phải thống nhất quy tắc với khách hàng: chuyển cho người xem, hay chuyển cho đội chịu trách nhiệm chính. Ghi quy tắc đó vào prompt, nếu không eval sẽ phạt model vì một quyết định chưa ai đưa ra.
Bước 4: chấm bằng assertion, đọc điểm theo từng đội
Hamel Husain, trong bài “Your AI Product Needs Evals”, gọi tầng eval đầu tiên là unit test cho LLM: những assertion như bạn vẫn viết trong pytest. Với router, assertion chỉ là so khớp chuỗi giữa nhãn dự đoán và nhãn kỳ vọng.
import json
import pytest
from router import route

CASES = [json.loads(line) for line in open("evals/routing.jsonl")]

@pytest.mark.parametrize("case", CASES, ids=lambda c: c["id"])
def test_route(case):
    assert route(case["email"])["team"] == case["expected"]
pytest evals/test_routing.py -qAnthropic cũng khuyên nên có nhiều câu hỏi chấm tự động, dù tín hiệu kém hơn một chút, thay vì ít câu chấm tay. Vì vậy đừng thay assertion bằng việc ngồi đọc từng câu trả lời ở vòng đầu.
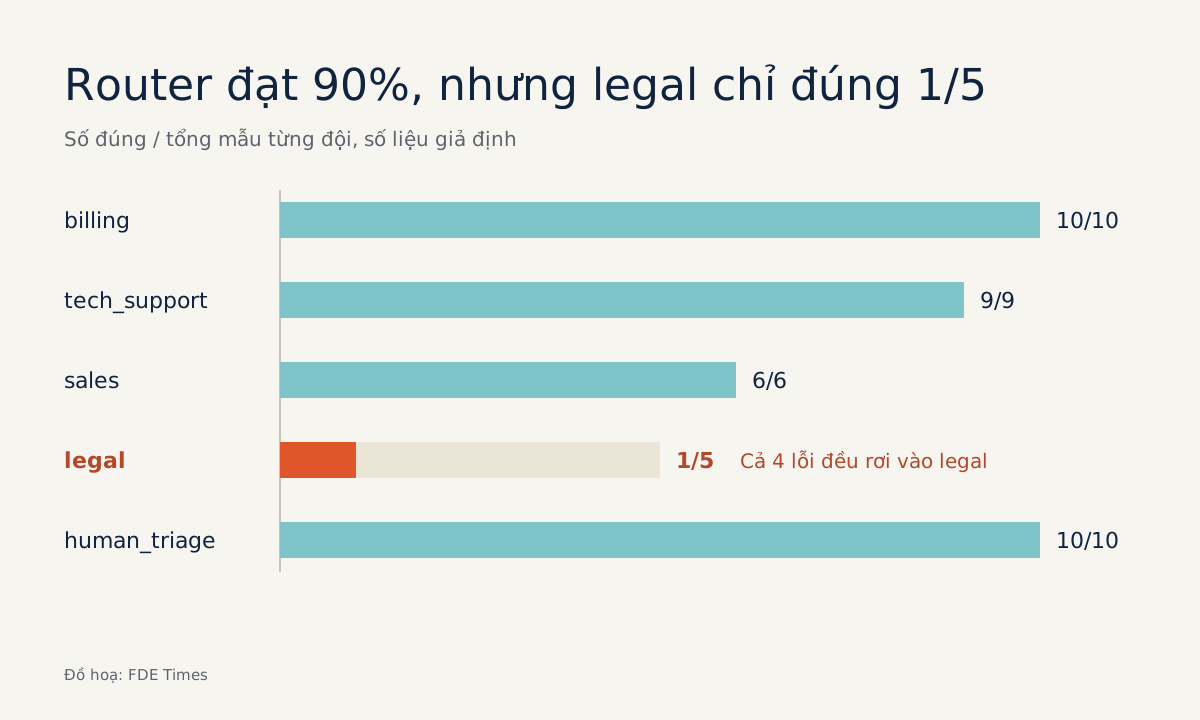
Giờ hãy làm thử một phép tính với số liệu giả định. Bộ 40 mẫu chia như Bước 3, trong đó 6 ca mơ hồ và 4 email rác đều có nhãn kỳ vọng là human_triage. Router pass 36/40, tức 90%. Nghe ổn, cho tới khi bạn tách điểm theo đội:
| Đội (giả định) | Số mẫu | Đúng | Tỷ lệ |
|---|---|---|---|
| billing | 10 | 10 | 10/10 |
| tech_support | 9 | 9 | 9/9 |
| sales | 6 | 6 | 6/6 |
| legal | 5 | 1 | 1/5 |
| human_triage | 10 | 10 | 10/10 |
| Tổng | 40 | 36 | 90% |
Cả 4 bài fail đều rơi vào legal. Router đang bỏ sót 4/5 email pháp lý, và đó lại đúng là loại email đắt nhất nếu đến muộn.
Kiểm tra: gom kết quả theo expected và theo tag. Nếu ca ambiguous sai nhiều mà ca typical gần như đúng hết, cần sửa quy tắc trong prompt chứ chưa cần đổi kiến trúc.
Khi nào mới thêm độ phức tạp?
Câu trả lời nằm trong bảng điểm. Với bảng trên, việc đầu tiên là sửa đúng chỗ router đang sai: viết lại định nghĩa legal trong prompt cho rõ hơn, chẳng hạn liệt kê thêm các dạng email pháp lý hay bị nhầm, rồi chạy lại đủ 40 mẫu.
Nếu điểm legal không tăng thì thay đổi đó chưa đáng giữ, dù nó trông hợp lý đến đâu. Đây là kỷ luật nên thể hiện rõ trong buổi phỏng vấn.
Prompt chuyên biệt cho từng đội là một bước riêng, đến sau. Anthropic giải thích lý do routing có ích: khi không tách luồng, tối ưu cho một loại input có thể làm hỏng kết quả ở các loại khác.
Vì thế khi muốn hệ thống làm thêm việc, chẳng hạn soạn nháp trả lời cho billing, hãy đặt prompt đó phía sau router thay vì nhồi thêm luật vào prompt phân loại.
Prompt soạn nháp không làm router chọn đội chính xác hơn, nên nó cần một bộ eval riêng chứ không thể dựa vào điểm của 40 mẫu này.
Sau khi lên production, Husain nhắc rằng không bao giờ được ngừng nhìn vào dữ liệu. Mỗi email bị chuyển nhầm mà đội nhận báo lại nên thành một dòng mới trong routing.jsonl. Bộ 40 mẫu sẽ lớn dần lên thành bộ 60, rồi 100 mẫu.
Mang kỹ năng này vào phỏng vấn và vào CV
Trong vòng system design, hãy dành phút đầu để nói bạn sẽ đo bằng gì: enum nhãn, lối thoát human_triage, bộ eval có ca mơ hồ và điểm theo từng đội. Sau đó mới vẽ hộp và mũi tên. Nếu được hỏi “công ty đổi cơ cấu đội thì sao?”, bạn đã có sẵn câu trả lời: sửa định nghĩa trong prompt rồi chạy lại eval.
Trên CV, một dòng như “dựng router email 5 nhãn với bộ eval 40 mẫu, tăng recall đội legal từ 1/5 lên 5/5” thuyết phục hơn hẳn “có kinh nghiệm với LLM agent”. Con số trong ví dụ đó là giả định, nhưng cấu trúc thì nên giữ: nó cho thấy bạn biết chứng minh bằng số, trước khi đòi thêm độ phức tạp.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!