Tóm tắt cuộc gọi tổng đài tiếng Việt, model lại là phần dễ nhất
PhoWhisper chép lời, WhisperX tách người nói, còn lỗi thật đến từ file 8kHz, người nói chen nhau và khâu ghép hai bên.
Tóm tắt nhanh
- Với tiếng Việt, nên bắt đầu từ PhoWhisper: VinAI tinh chỉnh Whisper trên 844 giờ dữ liệu có nhiều giọng vùng miền.
- Ghi âm tổng đài thường là 8kHz, trong khi PhoWhisper cần đầu vào 16kHz, nên bước resample là bắt buộc.
- Bản tóm tắt chỉ tốt khi bản chép lời gắn đúng người nói, và độ chính xác phải được đo trên chính dữ liệu của khách hàng.
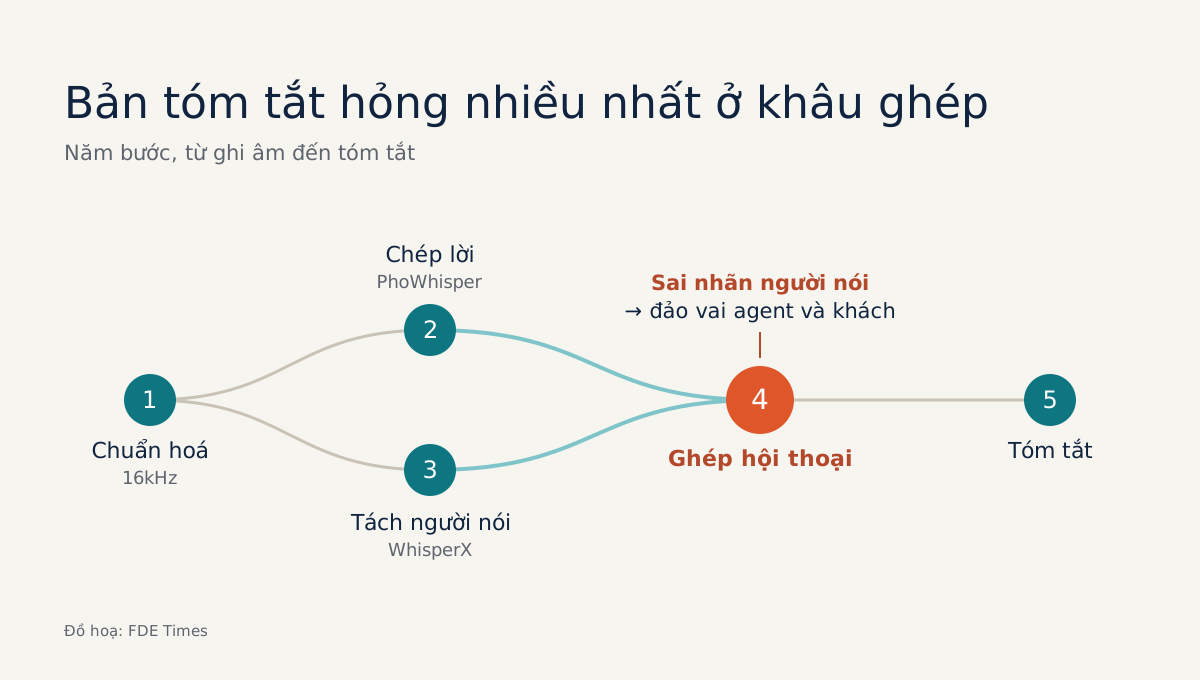
Thử hình dung một tổng đài lưu lại hàng nghìn cuộc gọi mỗi ngày nhưng gần như không ai nghe lại. Khi khách hàng nhờ FDE “làm gì đó với đống ghi âm này”, phần khó lại không nằm ở model. Cái khó nằm ở file 8kHz chất lượng thấp, hai người nói chen nhau và những giọng vùng miền mà bộ demo chưa từng gặp.
AWS mô tả speech-to-text là phần mềm nghe audio rồi trả về một bản chép lời nguyên văn, có thể chỉnh sửa. Họ cũng xếp call analytics, tức rút insight từ hội thoại với khách hàng, vào nhóm ứng dụng của công nghệ này. Hướng dẫn dưới đây dựng một phiên bản nhỏ của bài toán đó ngay trên laptop của bạn.
Bạn sẽ có bản chép lời, nhãn người nói và một bản tóm tắt, kèm một con số đo chất lượng do chính bạn tính.
Bạn sẽ dựng gì, và cần chuẩn bị những gì?
Pipeline đi qua năm bước: chuẩn hoá audio, chép lời, gắn timestamp và tách người nói, ghép thành hội thoại có nhãn, rồi tóm tắt. Bước cuối cùng là đo xem cả chuỗi sai ở đâu.
Bạn cần Python, thư viện Hugging Face transformers và vài file ghi âm cuộc gọi. Nếu chưa có dữ liệu thật, hãy tự đóng vai agent và khách hàng với một người bạn, ghi qua điện thoại. Nên có GPU nhưng không bắt buộc với model nhỏ.
Whisper có sáu cỡ model, đánh đổi giữa tốc độ và độ chính xác, nên ngân sách GPU của khách hàng sẽ quyết định bạn dùng cỡ nào.
Bước 1: vì sao file tổng đài phải đổi lên 16kHz?
Ghi âm tổng đài thường được lưu ở 8kHz, còn PhoWhisper cần audio đầu vào có tần số lấy mẫu 16kHz. Đây là yêu cầu đầu vào của model, nên đừng bỏ qua dù file trông vẫn phát được bình thường. Bước đầu tiên là resample mọi file lên 16kHz và đặt tên rõ ràng, ví dụ cuoc_goi_001_16k.wav.
Đoạn code dưới đây là phiên bản rút gọn, giả định bạn đã cài librosa và soundfile; bạn có thể dùng torchaudio hay ffmpeg thay thế, miễn đầu ra là 16kHz:
# Rút gọn: resample một file ghi âm lên 16kHz, mono
import librosa
import soundfile as sf

audio, sr = librosa.load("cuoc_goi_001.wav", sr=16000, mono=True)
sf.write("cuoc_goi_001_16k.wav", audio, 16000)
print(sr)  # phải in ra 16000
Kiểm tra: mở vài file sau khi chuyển đổi và nghe thử, đồng thời in tần số lấy mẫu ra để chắc chắn là 16000. Lỗi hay gặp là chỉ resample một phần thư mục, nên kết quả tốt với file này mà tệ với file kia, và bạn sẽ đổ lỗi nhầm cho model.
Bước 2: chọn Whisper gốc hay PhoWhisper?
Kho mã của OpenAI giới thiệu Whisper là model nhận dạng giọng nói đa năng: chép lời nhiều ngôn ngữ, dịch giọng nói và nhận diện ngôn ngữ. Kho mã đó cũng nói thẳng rằng chất lượng Whisper khác nhau rất nhiều theo từng ngôn ngữ. Với tiếng Việt, đây là lý do nên thử một model được tinh chỉnh riêng.
PhoWhisper của VinAI là Whisper đa ngôn ngữ được tinh chỉnh trên 844 giờ dữ liệu tiếng Việt, gồm nhiều giọng vùng miền, và có năm phiên bản. Bạn gọi nó qua pipeline ASR của transformers:
from transformers import pipeline

transcriber = pipeline("automatic-speech-recognition", model="vinai/PhoWhisper-small")
# Rút gọn: lấy phần text của kết quả
output = transcriber("cuoc_goi_001_16k.wav")["text"]
print(output)
Nếu muốn so sánh với Whisper gốc, có một bẫy cần nhớ: model turbo không được huấn luyện cho tác vụ dịch. Với ghi âm tổng đài tiếng Việt, hãy dùng nó để chép lời, đừng bắt nó dịch sang tiếng Anh.
Kiểm tra: đọc bản chép lời song song với audio. Hãy để ý tên riêng, mã đơn hàng và số điện thoại, vì đây là những chỗ khách hàng quan tâm nhất và cũng là chỗ dễ sai nhất.
Bước 3: ai đang nói, và nói lúc nào?
Một khối chữ liền mạch thì chưa phải bản ghi cuộc gọi. Muốn tóm tắt kiểu “khách phàn nàn giao trễ, agent hứa hoàn tiền”, bạn phải biết câu nào của ai. Whisper gốc chỉ cho timestamp ở mức câu, chưa đủ chi tiết để cắt đúng chỗ hai người nói chen nhau.
WhisperX lấp khoảng trống này theo ba cách. Nó căn chỉnh bằng wav2vec2 để có timestamp chính xác cho từng từ, và dùng pyannote-audio để phân biệt người nói, trả về nhãn speaker ID.
Nó còn chạy VAD (phát hiện đoạn có giọng nói) ở bước tiền xử lý để giảm hallucination, đồng thời suy luận theo lô mà không làm tăng WER, đạt khoảng 70 lần thời gian thực với large-v2.
Cần nói rõ một điểm: các tính năng trên là của WhisperX, và chưa có gì bảo đảm bản chép lời của PhoWhisper đi thẳng vào bước căn chỉnh wav2vec2 của WhisperX. Hãy coi việc ghép hai công cụ này là một thiết kế bạn phải tự thử và tự kiểm chứng.
Ý tưởng là có một luồng cho ra từng từ kèm thời điểm, một luồng cho ra các khoảng thời gian kèm nhãn người nói, và việc của bạn là ghép chúng theo thời gian.
Lệnh và tham số cụ thể để chạy căn chỉnh và diarization, bạn nên lấy trực tiếp từ README của kho m-bain/whisperX cho đúng phiên bản đang cài.
Đoạn ghép thì bạn tự viết được, và đây là chỗ đáng luyện nhất. Code dưới đây là phiên bản rút gọn do bạn tự định nghĩa cấu trúc dữ liệu, không phải API của WhisperX: mỗi từ được gán cho người nói có khoảng thời gian chồng lấn nhiều nhất với từ đó.
# Rút gọn: words và turns là dữ liệu bạn tự chuyển về dạng này
# words = [{"word": "alo", "start": 0.4, "end": 0.7}, ...]
# turns = [{"speaker": "SPEAKER_00", "start": 0.0, "end": 3.2}, ...]

def chong_lan(a_start, a_end, b_start, b_end):
    return max(0.0, min(a_end, b_end) - max(a_start, b_start))

def gan_nguoi_noi(words, turns):
    for w in words:
        best = max(turns, key=lambda t: chong_lan(w["start"], w["end"], t["start"], t["end"]))
        w["speaker"] = best["speaker"]
    return words
Kiểm tra: diarization chỉ cho bạn SPEAKER_00 và SPEAKER_01, nó không biết ai là agent. Bạn phải tự đặt luật đổi nhãn, chẳng hạn người nói câu chào mở đầu theo kịch bản là agent. Hãy kiểm tra luật đó trên từng cuộc gọi, vì chỉ cần một cuộc khách hàng nói trước là cả bản tóm tắt bị đảo vai.
Bước 4: tóm tắt cái gì thì người dùng mới cần?
Khi đã có hội thoại gắn nhãn, bạn đưa nó cho một mô hình ngôn ngữ để tóm tắt. Đừng hỏi chung chung kiểu “tóm tắt cuộc gọi này”. Hãy hỏi đúng những trường mà quản lý tổng đài cần đọc. Khung dưới đây chỉ là gợi ý minh hoạ, bạn nên thay bằng các trường mà khách hàng thực sự dùng:
# Khung tóm tắt minh hoạ
- Lý do khách gọi:
- Khách hàng có hài lòng ở cuối cuộc gọi không:
- Agent đã cam kết gì (kèm thời hạn nếu có):
- Việc cần làm tiếp:
Tách theo trường như vậy giúp bạn so sánh hàng nghìn cuộc gọi, thay vì phải đọc hàng nghìn đoạn văn tự do. Cách này còn giúp phát hiện lỗi ở các bước trước: nếu mục “Agent đã cam kết gì” lại chứa lời của khách, gần như chắc chắn bước 3 đã gán sai người nói.
Bước 5: đo trên dữ liệu của chính khách hàng
Vì chất lượng Whisper dao động mạnh theo ngôn ngữ, con số công bố của bất kỳ ai cũng không thay được phép đo của bạn trên chính các cuộc gọi tiếng Việt của khách hàng.
Thước đo phổ biến là WER, tức tỷ lệ lỗi từ. Thử hình dung một câu chuẩn có 20 từ, model đọc sai 3 từ và bỏ sót 1 từ. Khi đó WER bằng 4 chia 20, tức 20%.
Hãy làm phép tính này cho từng cuộc gọi chứ đừng chỉ lấy trung bình, vì một cuộc gọi giọng địa phương với WER cao có thể bị che đi bởi mười cuộc gọi giọng chuẩn.
Thêm một lời cảnh báo về việc mượn số liệu công bố: một bài báo arXiv về pipeline đánh giá chất lượng dịch vụ tiếng Việt từ giọng nói đã bị chính các tác giả rút lại vì kết quả có sai sót đáng kể. Trước khi đưa con số của ai vào slide cho khách hàng, hãy kiểm tra nguồn đó còn đứng vững hay không.
| Cách thất bại | Dấu hiệu | Cách xử lý đầu tiên |
|---|---|---|
| Quên resample một phần file | Chất lượng chênh lệch bất thường giữa các file | Kiểm tra tần số lấy mẫu 16000 cho toàn bộ file |
| Hallucination ở đoạn im lặng | Xuất hiện câu không ai nói lúc chờ máy | Bật VAD trước khi chép lời |
| Đảo vai agent và khách | Tóm tắt ghi khách “hứa hoàn tiền” | Rà lại luật đổi nhãn speaker |
Kỹ năng này xuất hiện ở khách hàng ra sao?
Nếu bạn là FDE trong một dự án như vậy, nên dành những ngày đầu để đo trước khi chọn model. Hãy xin 20 đến 30 cuộc gọi đại diện cho các vùng miền, khung giờ và loại khiếu nại, ngồi cùng một trưởng ca để gõ bản chép lời chuẩn, rồi chạy pipeline và đưa ra bảng WER theo từng nhóm.
Bảng đó sẽ giúp quyết định nên dùng cỡ model nào, có cần GPU hay không và cuộc gọi nào phải chuyển cho người duyệt.
Khi đọc mô tả công việc FDE hay solutions engineer, hãy chú ý các cụm như “call analytics”, “speech”, “contact center” hoặc “ASR”. Trong CV, đừng chỉ ghi “đã dùng Whisper”. Hãy ghi bạn đã đo WER trên dữ liệu tiếng Việt, đã tìm ra lỗi do audio 8kHz hoặc do đảo vai người nói, và đã sửa nó như thế nào.
Chọn model chỉ mất một dòng code. Biết pipeline sai ở cuộc gọi nào và vì sao mới là phần khách hàng trả tiền để có.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!