Lỗi AI vẫn trả mã 200, nên helpdesk của khách cần runbook riêng
Tuyến một không cần hiểu model, chỉ cần biết hỏi cái gì vừa thay đổi, gom đủ ba bằng chứng và được phép báo động sớm.
Tóm tắt nhanh
- Câu trả lời sai của LLM vẫn trả về HTTP 200, nên checklist helpdesk dựa trên status code không bắt được nó.
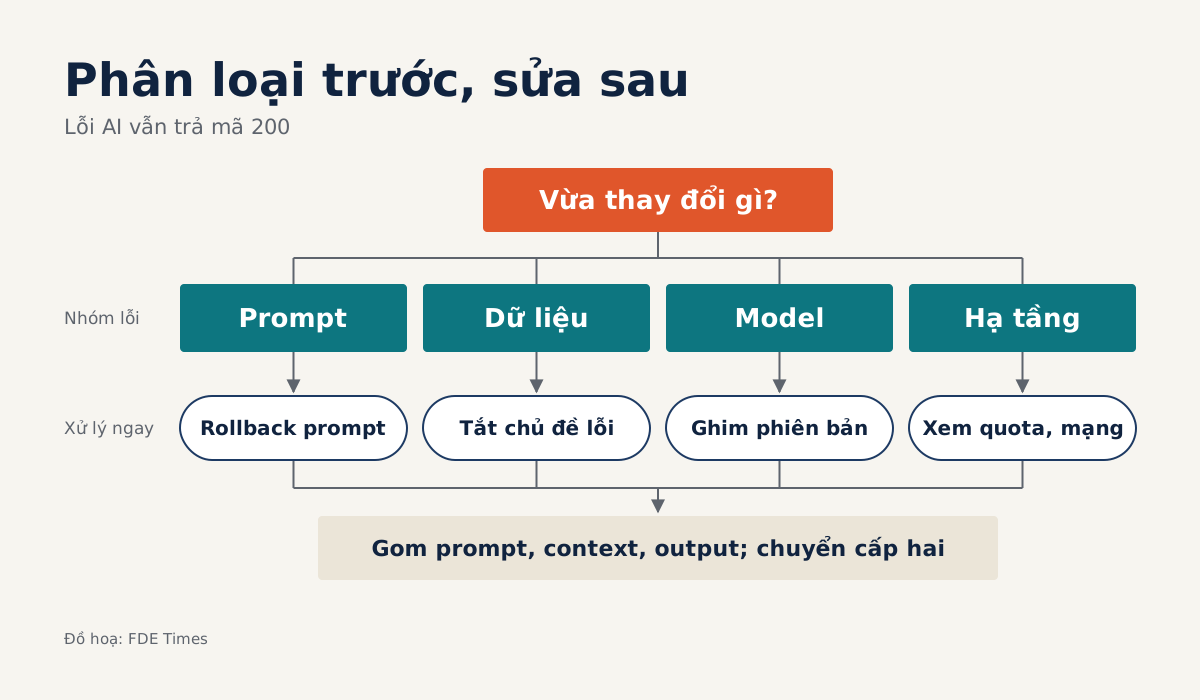
- Cấp một chỉ làm ba việc: hỏi cái gì vừa thay đổi, xếp lỗi vào một trong bốn nhóm, đính kèm phiên bản prompt, context truy xuất và output đã lưu.
- Cấp hai cầm máu bằng thao tác duyệt sẵn, với rollback dưới mười phút; cấp ba tìm nguyên nhân rồi ghi lại vào runbook.
Tuần cuối của một engagement. Helpdesk tuyến một của khách đã quen với các ticket kiểu đăng nhập không được, trang trắng, lỗi 500. Rồi một nhân viên gửi ảnh chụp màn hình: trợ lý AI nội bộ trả lời sai số ngày phép năm. Log không có dòng đỏ nào, nên người trực đóng ticket với ghi chú “không tái hiện được”.
Đây là loại sự cố mà checklist helpdesk cũ không bắt được. Bài “AI Incident Response Playbooks” trên blog tianpan.co chỉ ra rằng một câu bịa của LLM vẫn trả về mã 200, kèm payload JSON đúng cấu trúc đến từng trường. Mọi cảnh báo dựa trên status code đều coi đó là một request thành công.
Nếu bạn rút khỏi khách mà không để lại cách phân loại loại lỗi này, ticket sẽ quay về hộp thư của bạn. Tệ hơn, nó có thể không về tay ai cả. Việc của FDE trước ngày bàn giao là dạy tuyến một nhận ra lỗi AI, xếp nó vào đúng nhóm và chuyển lên đúng người.
Helpdesk không cần hiểu model, chỉ cần phân loại đúng
Sai lầm phổ biến là cố dạy helpdesk về embedding hay temperature. Họ không cần những thứ đó. Họ cần một runbook ba cấp, mỗi cấp có quyền hạn rõ ràng.
Cấp một là helpdesk: tiếp nhận, phân loại, gom bằng chứng, mở sự cố. Cấp hai là đội vận hành của khách, những người được phép làm một số thao tác chặn thiệt hại đã duyệt sẵn. Cấp ba là đội kỹ sư sở hữu hệ thống, có thể vẫn là bạn qua hợp đồng hỗ trợ, phụ trách tìm nguyên nhân gốc.
Bài trên tianpan.co đề xuất chia sự cố AI thành bốn nhóm: model, prompt, dữ liệu và hạ tầng. Mỗi nhóm có chủ sở hữu và cách sửa khác nhau. Vì thế, những phút đầu của việc xử lý nên dành để xếp sự cố vào đúng nhóm, chứ chưa phải để sửa.
Danh mục lỗi phải lấy từ trace của chính khách
Bốn nhóm trên mới là khung chung. Helpdesk cần ví dụ cụ thể của hệ thống họ đang dùng, và bạn chỉ có được những ví dụ đó bằng cách đọc trace thật. Hamel Husain, trong bộ Eval FAQ, gọi error analysis là hoạt động quan trọng nhất trong evals, vì nó làm lộ ra những kiểu lỗi chỉ ứng dụng và dữ liệu của bạn mới có.
Cách làm gồm hai bước. Bước đầu là open coding: đọc từng trace và ghi chú tự do, không dùng danh mục định sẵn, Husain ví nó như viết nhật ký. Bước sau là axial coding: gom các ghi chú thành một danh mục lỗi và đếm số lỗi trong từng nhóm. Husain coi đây là bước quan trọng nhất.
Thử hình dung bạn đọc trace của trợ lý HR và ghi chú tự do từng cái: “trích quy chế cũ dù đã có bản mới”, “đúng tài liệu nhưng lấy sai đoạn”, “câu trả lời bị cắt ở câu cuối”, “timeout khi hỏi về bảng lương”, “đổi sang gạch đầu dòng từ hôm qua”. Lúc ghi, bạn chưa cần đặt tên nhóm nào.
Khi gom lại, hai ghi chú đầu thành nhóm “truy xuất sai tài liệu hoặc sai đoạn”, thuộc nhóm dữ liệu. Ghi chú cắt ngang và timeout thuộc hạ tầng, còn chuyện đổi định dạng gợi ý prompt vừa bị sửa. Giả sử đếm ra nhóm truy xuất chiếm phần lớn: đó là dòng bạn viết kỹ nhất trong checklist cấp một.
Bạn dừng lại khi trace mới không còn cho thấy kiểu lỗi mới, cũng không làm thay đổi các nhóm đã có. Husain gọi điểm này là bão hòa lý thuyết. Kết quả là một danh sách lỗi có số liệu đi kèm, và bạn đặt từng kiểu lỗi vào một trong bốn nhóm.
| Nhóm | Dấu hiệu helpdesk nhìn thấy | Câu hỏi đầu tiên |
|---|---|---|
| Prompt | Giọng điệu hay định dạng câu trả lời đổi đột ngột với mọi người dùng | Prompt có vừa được sửa không? |
| Dữ liệu | Sai ở một chủ đề cụ thể, trích dẫn tài liệu cũ hoặc sai tài liệu | Có ai vừa tải lên hay xóa tài liệu? |
| Model | Chất lượng giảm trên diện rộng dù prompt và dữ liệu không đổi | Nhà cung cấp có đổi phiên bản model không? |
| Hạ tầng | Chậm, timeout, câu trả lời bị cắt giữa chừng | Mạng, quota hoặc cấu hình có vừa thay đổi? |
Cột giữa là phần bạn phải tự điền bằng ví dụ từ trace của khách. Bảng trên chỉ là gợi ý để bắt đầu.
Một ticket đi qua ba cấp
Quay lại ticket ngày phép. Một runbook gỡ lỗi LLM đăng trên dev.to đặt câu hỏi phân loại là: cái gì đã thay đổi, và thay đổi ở phía ai. Câu hỏi đó cũng nên là dòng đầu tiên trên checklist cấp một, trước cả khi nghĩ đến chuyện model.
Thử hình dung người trực hỏi đội HR và biết họ vừa tải lên bộ chính sách mới hôm thứ Hai. Lỗi chỉ xảy ra với câu hỏi về ngày phép, còn các chủ đề khác vẫn đúng. Như vậy đây là nhóm dữ liệu. Người trực mở ticket và điền theo mẫu sau:
[SỰ CỐ AI] Trợ lý HR trả lời sai số ngày phép
Thời điểm phát hiện: thứ Tư, 9:40
Nhóm nghi ngờ: Dữ liệu
Gần đây có gì thay đổi: HR tải bộ chính sách mới vào thứ Hai
Bằng chứng:
  - Phiên bản prompt đang chạy lúc đó: (lấy từ dashboard)
  - Context truy xuất được: (danh sách tài liệu và đoạn trích)
  - Output model đã lưu: (nguyên văn, không chép tay)
Tái hiện được không: Có, 3/3 lần với câu hỏi gốc
Chuyển lên: Cấp hai
Ba dòng bằng chứng lấy từ runbook trên dev.to: phiên bản prompt đang chạy, context truy xuất được và output đầy đủ đã lưu. Nếu thiếu ba thứ này, cấp ba phải đoán. Vì vậy trước khi bàn giao, bạn cần chắc rằng hệ thống lưu đủ cả ba và helpdesk biết lấy chúng ở đâu.
Cấp hai cầm máu trước, tìm nguyên nhân sau
Bài trên tianpan.co nói thẳng: cần chặn thiệt hại trước khi biết vì sao nó xảy ra. Các công cụ là rollback prompt, ghim phiên bản model hoặc dùng feature flag. Đây đúng là những thao tác bạn nên duyệt sẵn để đội vận hành của khách được tự làm, không phải chờ ai.
Runbook trên dev.to thêm hai chi tiết đáng chép vào tài liệu bàn giao. Thời gian rollback nên dưới mười phút. Ngoài ra nên có một prompt kill-switch, tức một phiên bản đã được review và biết chắc là chạy đúng, để chuyển sang khi mọi thứ khác đều không ổn.
Với ticket ngày phép, cấp hai có thể dùng feature flag tắt chủ đề nghỉ phép và hiện lời nhắn trỏ người dùng tới trang chính sách gốc. Cấp ba sau đó mới xem tài liệu mới bị chia chunk sai hay tài liệu cũ chưa được gỡ khỏi index.
Báo động sớm phải được cho phép bằng văn bản
Nhân viên tuyến một thường sợ mở sự cố khi chưa chứng minh được nguyên nhân. Incident Response Workbook của Google SRE đặt nguyên tắc ngược lại: khai báo sự cố sớm và thường xuyên. Workbook cũng khuyên nên nói rõ với người trực rằng họ được phép giao việc và chuyển lên trên khi đang xử lý.
Hãy ghi điều đó thành một dòng trong runbook: chuyển lên không bị trách, kể cả khi hóa ra là báo nhầm. Không có dòng này, helpdesk sẽ quay lại thói quen đóng ticket với lý do “không tái hiện được”.
Cuối cùng, mỗi sự cố ở cấp ba phải quay ngược về runbook. Sách SRE của Google viết rằng không cách học nào tốt hơn việc ghi lại những gì đã hỏng. Kiểu lỗi mới thì thêm vào bảng, dấu hiệu mới thì thêm vào cột giữa.
Runbook thường chết theo những cách nào
Cách phổ biến nhất là viết danh mục lỗi từ trí tưởng tượng thay vì từ trace. Helpdesk sẽ gặp các ví dụ không khớp với thực tế rồi bỏ runbook. Cách thứ hai là liệt kê bằng chứng cần đính kèm khi hệ thống chưa lưu chúng, nên người trực không có gì để điền.
Cách thứ ba là để cấp hai chỉ có quyền “báo lên trên”, không có thao tác nào được duyệt sẵn, nên mọi sự cố đều chờ kỹ sư. Cách thứ tư là bàn giao một lần rồi thôi, không ai sở hữu việc cập nhật runbook sau mỗi sự cố.
Khi đã làm trọn việc này, hãy ghi vào CV cụ thể hơn một dòng “viết tài liệu bàn giao”: bạn dựng danh mục lỗi từ trace thật và thiết kế runbook ba cấp để đội khách tự xử lý sự cố AI.
Thước đo của bản bàn giao là ticket “trả lời sai” đầu tiên sau khi bạn rút: nó có được phân loại đúng và đến đúng người mà không cần ai gọi cho bạn hay không.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
5 nguồn
- Q: Why is "error analysis" so important in AI evals, and how is it performed? – Hamel's Blog · 2025-06-27
- AI Incident Response Playbooks: Why Your On-Call Runbook Doesn't Work for LLMs · 2026-04-20
- Debugging an LLM Bug at 3 AM: The Runbook I Wish I'd Had · 2026-04-18
- Chapter 13 - Emergency Response (Site Reliability Engineering)
- Chapter 9 - Incident Response (Site Reliability Workbook)