Người dùng gõ không dấu, RAG tiếng Việt cần hai đường tìm song song
Bỏ dấu cả kho thì 'khóa học' ra 'khoa học', nên hãy giữ hai bản index và để bộ test chọn trọng số.
Tóm tắt nhanh
- Bỏ dấu cả kho thì câu không dấu tìm được, nhưng câu có dấu lại ra sai: 'khóa học' bị đưa sang 'khoa học'.
- Nên giữ hai trường, gốc và bỏ dấu, chuẩn hoá NFC trước, rồi gộp với nhánh vector bằng RRF.
- Đo recall trên từng cặp câu hỏi có dấu và không dấu. Khoảng cách giữa hai con số đó là chỉ số cần kéo xuống.
Một báo cáo lỗi trên Phabricator của Wikimedia ghi lại chuyện này: gõ “khóa học” vào ô tìm kiếm của Wikipedia tiếng Việt thì bị đưa tới trang “khoa học”, một chủ đề hoàn toàn khác. Hệ thống đã bỏ dấu để chiều người gõ không dấu, và người gõ đúng dấu lãnh hậu quả.
Bạn sẽ gặp đúng chuyện này khi deploy RAG tiếng Việt cho khách hàng. Log truy vấn sẽ lẫn cả “đường đi” với “duong di”, cả “hóa đơn” với “hoa don”.
Nếu chỉ tìm theo bản có dấu thì mọi câu gõ không dấu đều có nguy cơ trượt, còn tỷ lệ những câu đó là bao nhiêu thì bạn chỉ biết khi đếm trong log.
Bỏ dấu toàn bộ thì bạn lại lặp lại lỗi của Wikipedia.
Việc của FDE ở đây là thiết kế đường tìm phục vụ được cả hai kiểu gõ, rồi chứng minh bằng số liệu rằng nó chạy. Toàn bộ chỉ cần vài chục dòng Python, nhưng phải làm đúng thứ tự.
Bỏ dấu giúp được một nửa và làm hỏng nửa kia
Hướng dẫn của Elasticsearch giải thích rằng bỏ dấu khỏi từ giúp rôle khớp với role và ngược lại. Họ dùng bộ lọc asciifolding cho các ngôn ngữ phương Tây. Cũng tài liệu đó cảnh báo ngay sau: bỏ dấu là mất nghĩa. Ví dụ họ đưa ra là “está” và “esta” trong tiếng Tây Ban Nha, hai từ khác nhau.
Với tiếng Việt, cái giá còn cao hơn. Báo cáo của Wikimedia nhận định tác động lên các wiki tiếng Việt rất lớn, vì khi bỏ dấu thì phần lớn từ đều trùng với những từ hoàn toàn không liên quan. “Đường”, “dương”, “dưỡng” đều thành “duong”.
Lời giải mà Elasticsearch đề xuất áp dụng được ngay cho tiếng Việt: đánh index văn bản hai lần, một lần ở dạng gốc và một lần đã bỏ dấu. Câu hỏi có dấu thì dựa chủ yếu vào trường gốc. Câu hỏi không dấu thì dựa vào trường bỏ dấu, vì người gõ đã không cho bạn thông tin về dấu.
Trước khi bỏ dấu, chuẩn hoá Unicode
Bước này hay bị quên nhất. Tài liệu Python giải thích rằng cùng một chữ nhìn thấy trên màn hình có thể được lưu bằng những dãy code point khác nhau. Dạng NFD tách mỗi ký tự thành chữ cái gốc cộng các dấu kết hợp.
Tài liệu cũng cảnh báo hai chuỗi trông giống hệt nhau vẫn có thể không bằng nhau khi so sánh, nếu một chuỗi dùng ký tự kết hợp còn chuỗi kia thì không.
Vì thế cả kho tài liệu lẫn câu hỏi phải về cùng một dạng, thường là NFC, trước khi so sánh hay bỏ dấu. Dưới đây là phần lõi:
import unicodedata

def nfc(s: str) -> str:
    return unicodedata.normalize("NFC", s)

def fold(s: str) -> str:
    # Tách chữ gốc và dấu, bỏ các dấu kết hợp (category Mn)
    s = unicodedata.normalize("NFD", s.lower())
    s = "".join(c for c in s if unicodedata.category(c) != "Mn")
    # 'đ' là một ký tự riêng, không tách ra được, phải đổi tay
    return s.replace("đ", "d")

def has_marks(q: str) -> bool:
    q = nfc(q.lower())
    return fold(q) != q
Chú ý dòng replace("đ", "d"). Chạy thử fold("đường") khi chưa có dòng đó, bạn sẽ thấy chữ đ vẫn còn nguyên, và câu “duong” của người dùng sẽ không bao giờ khớp. Lúc ghi dữ liệu, mỗi đoạn văn được lưu vào hai trường: text = nfc(raw) và text_folded = fold(raw).
Câu hỏi về khoá học được chấm điểm thế nào
Giả sử bạn dựng trợ lý tra cứu quy chế cho một trường đại học, và kho có cả tài liệu về đăng ký khoá học lẫn tài liệu về nghiên cứu khoa học. Hàm tìm kiếm chọn nhánh theo câu hỏi, rồi luôn chạy thêm nhánh vector.
Một nghiên cứu năm 2026 tại EACL Findings đã so sánh tìm theo từ khoá, tìm dense và tìm hybrid cho tiếng Việt trên nhiều lĩnh vực. Kết quả đó ủng hộ việc kết hợp BM25 với vector.
def rrf(ranked_lists, weights, k=60):
    scores = {}
    for lst, w in zip(ranked_lists, weights):
        for rank, doc_id in enumerate(lst, start=1):
            scores[doc_id] = scores.get(doc_id, 0.0) + w / (k + rank)
    return sorted(scores, key=scores.get, reverse=True)

def search(q, top=10, n=150):
    q = nfc(q)
    branches, weights = [], []
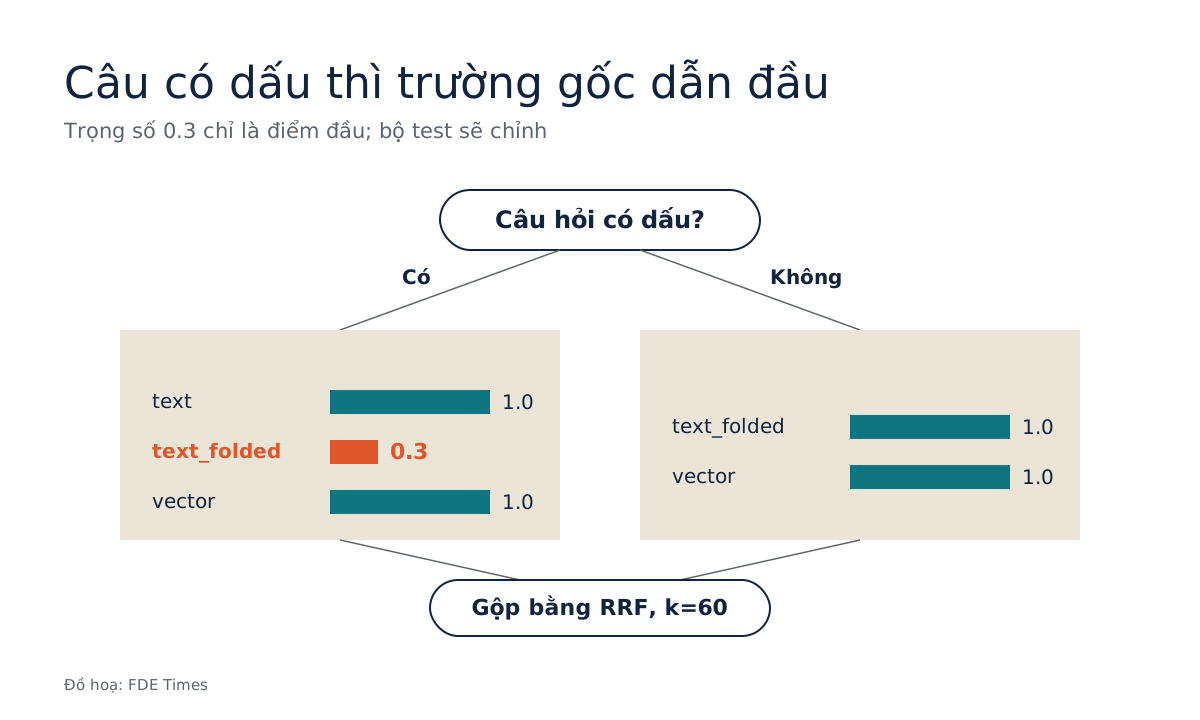
    if has_marks(q):
        branches.append(bm25("text", q, limit=n)); weights.append(1.0)
        branches.append(bm25("text_folded", fold(q), limit=n)); weights.append(0.3)
    else:
        branches.append(bm25("text_folded", fold(q), limit=n)); weights.append(1.0)
    branches.append(vector_search(q, limit=n)); weights.append(1.0)
    return rrf(branches, weights)[:top]
Giá trị k=60 lấy từ tài liệu Reciprocal Rank Fusion của ParadeDB, nơi gọi nó là mặc định phổ biến và là điểm khởi đầu tốt. Cũng tài liệu đó khuyên lấy 100 đến 200 ứng viên cho mỗi nhánh nếu cần top-10, nên code để n=150 cho mọi nhánh. Trọng số 0.3 thì chỉ là phỏng đoán ban đầu, sẽ được chỉnh ở phần sau.
Giờ thử tính tay với câu “khóa học đăng ký muộn”. Câu này có dấu, nên trường gốc giữ vai trò chính. Tài liệu về đăng ký khoá học đứng hạng 1 ở BM25 gốc và hạng 3 ở vector, nên được 1/61 + 1/63 ≈ 0,0323.
Còn tài liệu về nghiên cứu khoa học, nếu chỉ đứng hạng 1 ở nhánh bỏ dấu, sẽ được 0,3/61 ≈ 0,0049, thấp hơn sáu lần, nên không thể vượt lên.
Với “khoa hoc dang ky muon”, trường bỏ dấu khớp cả hai loại tài liệu. Từ khoá không đủ để phân biệt, nên chữ “dang ky muon” và nhánh vector phải gánh phần quyết định. Hệ thống có làm tốt việc đó hay không thì phải đo, và phần dưới cho thấy cách đo.
Trọng số phải đến từ bộ test
ParadeDB khuyên chỉnh trọng số trên một bộ câu hỏi có nhãn, đừng dựa vào cảm tính.
Với tiếng Việt, cách tiện nhất là một bảng: mỗi dòng là một câu hỏi, cột có dấu chứa bản gõ đúng, cột không dấu chứa bản gõ vội, cả hai trỏ tới cùng một tài liệu đúng. Sau đó tính recall@10 riêng trên cột có dấu và riêng trên cột không dấu.
Quay lại trợ lý quy chế. Bảng dưới đây dùng số giả định cho một bộ test 30 cặp câu, chỉ để minh hoạ cách đọc kết quả:
| Cấu hình | Recall@10 cột có dấu | Recall@10 cột không dấu |
|---|---|---|
| Chỉ trường gốc, cộng vector | 27/30 | 14/30 |
| Thêm trường bỏ dấu, trọng số phụ 0.3 | 27/30 | 24/30 |
| Thêm trường bỏ dấu, trọng số phụ 1.0 | 23/30 | 24/30 |
Dòng đầu là hệ thống chưa có trường bỏ dấu: gần một nửa câu không dấu trượt. Dòng hai kéo cột không dấu lên, còn cột có dấu giữ nguyên.
Dòng ba cho nhánh bỏ dấu nặng ngang trường gốc ngay cả với câu có dấu. Lúc đó tài liệu “khoa học” bắt đầu chen vào top-10 của những câu như “khóa học”, và cột có dấu tụt xuống.
Trọng số phụ chỉ tác động lên câu có dấu, vì câu không dấu luôn lấy trường bỏ dấu làm chính, nên cột không dấu ở dòng hai và ba bằng nhau. Trong ví dụ này, 0.3 là mức kéo được cột không dấu lên mà không làm cột có dấu tụt. Sáu câu không dấu còn trượt là việc tiếp theo của nhánh vector.
Đây cũng là thứ nên ghi vào CV. Một dòng kiểu “đo và thu hẹp khoảng cách recall@10 giữa câu hỏi có dấu và không dấu trên bộ test N câu” cho người phỏng vấn thấy bạn biết đo, và nó đúng ở bất kỳ ngôn ngữ nào có dấu.
Khi đọc tin tuyển dụng FDE có nhắc tới search đa ngôn ngữ, đây là ví dụ đáng mang vào buổi phỏng vấn.
Những lỗi thường gặp
Lỗi đầu tiên là chỉ giữ index bỏ dấu, chuyện “khóa học” thành “khoa học” chính là hậu quả. Lỗi thứ hai là bỏ dấu khi chưa chuẩn hoá NFC, khiến hai chuỗi trông giống nhau vẫn không khớp. Lỗi thứ ba là quên chữ đ, và mọi câu hỏi chứa “duong” hay “dang” đều trượt.
Có hai lỗi khó thấy hơn. Một là bỏ dấu kho tài liệu bằng một hàm nhưng bỏ dấu câu hỏi bằng hàm khác, chẳng hạn hàm của thư viện search ở phía index và hàm tự viết ở phía API, rồi hai bên lệch nhau đúng ở những ký tự hiếm.
Cách tránh là dùng chung một hàm fold cho cả hai phía và kiểm tra nó bằng unit test.
Hai là lấy quá ít ứng viên mỗi nhánh, nên RRF không có đủ tài liệu để gộp. Mức 100 đến 200 ứng viên mỗi nhánh mà ParadeDB gợi ý là chỗ nên bắt đầu.
Khi đến chỗ khách hàng, việc đầu tiên là xin log truy vấn và đếm xem bao nhiêu phần trăm câu hỏi không dấu. Con số đó cho bạn biết bộ test cần bao nhiêu câu không dấu, và vì nó đến từ dữ liệu của chính khách hàng, nó là điểm khởi đầu tốt cho cuộc trao đổi về chất lượng tìm kiếm.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
5 nguồn
- asciifolding token filter (Elasticsearch: The Definitive Guide)
- Wikimedia Phabricator T78485 (Vietnamese search and diacritics) · 2014-12-13
- unicodedata — Unicode Database (Python docs)
- Which Works Best for Vietnamese? A Practical Study of Information Retrieval Methods across Domains · 2026-03
- Reciprocal Rank Fusion (ParadeDB pg_search docs)