Câu SQL đầu tiên ở chỗ khách có thể chạy êm mà vẫn sai số
Một phép JOIN âm thầm cộng đơn hàng hai lần là lý do FDE phải đếm khóa và kiểm tra dữ liệu trước khi gửi con số cho khách.
Tóm tắt nhanh
- Dữ liệu của khách hàng thường lộn xộn, nên SQL trước hết là công cụ để kiểm tra dữ liệu, sau đó mới là công cụ làm báo cáo.
- Lỗi nguy hiểm nhất là JOIN sai: không báo lỗi gì nhưng nhân đôi dòng hoặc làm mất dữ liệu.
- Python dùng để biến những phép kiểm tra đó thành code lặp lại được, có assert, rồi mới chuyển thành sản phẩm.
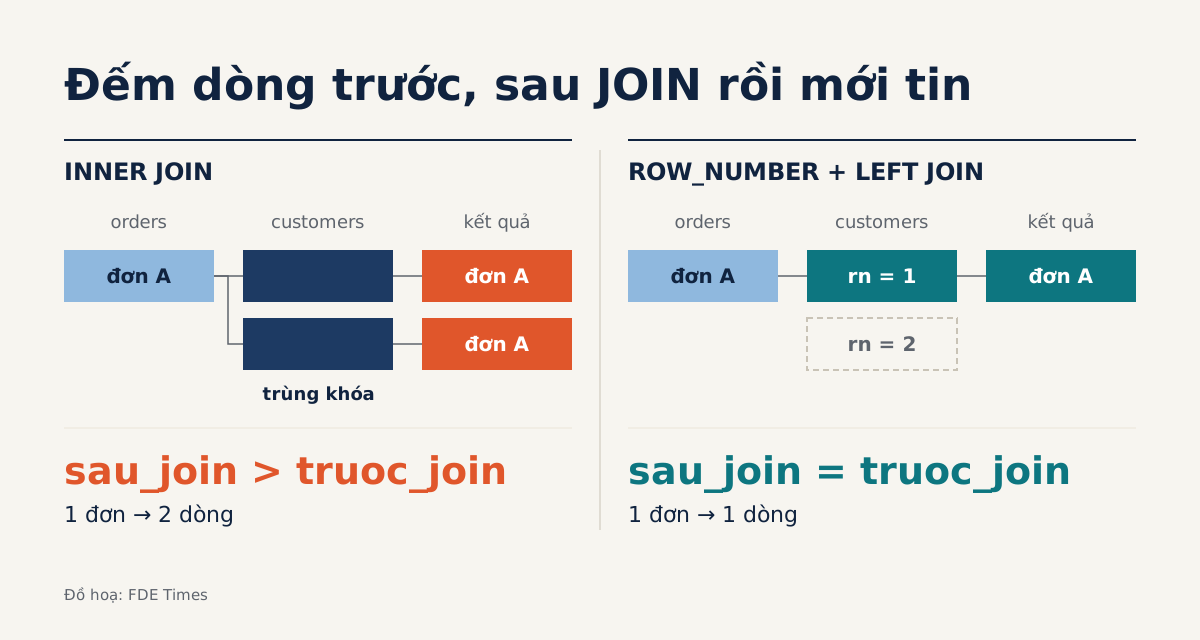
Thứ Hai, bạn được cấp quyền đọc vào database Postgres của khách hàng. Đến trưa, trưởng phòng kinh doanh bên đó hỏi doanh thu theo từng khu vực. Bạn viết một câu JOIN giữa bảng orders và customers, chạy mất ba giây, rồi gửi bảng kết quả đi.
Chiều hôm đó người ta gọi lại. Tổng doanh thu trong bảng của bạn cao hơn số kế toán đang có. Câu SQL không sai cú pháp, cũng không báo lỗi. Nó chỉ âm thầm cộng một số đơn hàng hai lần.
Tình huống kiểu này là lý do Python và SQL được xem là mức sàn của nghề FDE. Bạn không cần biết thật nhiều framework. Thứ bạn cần là thói quen kiểm tra dữ liệu trước khi tin nó, và đủ tay nghề để biến những phép kiểm tra đó thành code chạy lại được.
Job description nói gì về mức sàn này?
Capicua mô tả công việc FDE là viết production code chạy thẳng trên hạ tầng và dữ liệu của khách hàng. Các tin tuyển dụng đi theo cùng hướng đó, chỉ khác nhau ở chỗ SQL có được gọi tên hay không.
Databricks ghi rõ Python và SQL trong yêu cầu cho vị trí Sr. FDE ở Singapore, và còn muốn FDE tích hợp được API AI như OpenAI, Anthropic, Gemini vào ứng dụng. Palantir đòi hỏi thành thạo một ngôn ngữ như Python, Java hay C++, nêu Python cho việc xử lý và phân tích dữ liệu, nhưng không gọi tên SQL.
Dù vậy, một tin khác của Palantir nhắc đến Postgres, Cassandra, Hadoop và Spark. Paraform thì gói lại thành một ngôn ngữ backend cộng khả năng lấy và định hình dữ liệu nhanh.
Khi đọc job description, bạn nên để ý những cụm như “pulling and shaping data”, “data processing” hay tên các hệ thống như Postgres và Spark: đó là dấu hiệu bạn sẽ làm việc thẳng trên dữ liệu thật. Ngay cả việc tích hợp API AI cũng chạy trên nền dữ liệu, và dữ liệu sai thì sản phẩm cũng sai theo.
Chi tiết quan trọng nằm ở chữ “của khách hàng”: dữ liệu đó do người khác thiết kế, và bạn không biết nó đã bị sửa qua bao nhiêu đời hệ thống.
Vì sao SQL trước hết là công cụ kiểm tra?
HCL GUVI cho rằng SQL là một trong những kỹ năng thực dụng nhất của FDE. Lý do họ đưa ra là môi trường khách hàng đầy database, bản ghi vận hành và dữ liệu không nhất quán. Họ cũng cảnh báo rằng JOIN sai có thể tạo bản ghi trùng hoặc âm thầm xóa mất thông tin quan trọng.
Lời khuyên của họ là phải điều tra dữ liệu khách hàng, không tự động tin nó.
Vậy SQL của FDE có hai việc. Việc đầu tiên là đặt câu hỏi cho dữ liệu: khóa có thật sự duy nhất không, JOIN có làm tăng số dòng không, có dòng nào bị rơi mất không. Chỉ khi xong việc đó mới đến lượt trả lời câu hỏi kinh doanh.
Ví dụ: mổ xẻ con số doanh thu bị đội lên
Quay lại buổi chiều thứ Hai. Giả sử bảng customers có các cột customer_id, region, updated_at. Câu hỏi đầu tiên là customer_id có thật sự là khóa duy nhất không.
-- 1. Khóa có duy nhất không?
SELECT COUNT(*) AS so_dong,
       COUNT(DISTINCT customer_id) AS so_khach
FROM customers;

-- Nếu so_dong > so_khach, xem ai bị trùng
SELECT customer_id, COUNT(*) AS so_ban_ghi
FROM customers
GROUP BY customer_id
HAVING COUNT(*) > 1
ORDER BY so_ban_ghi DESC
LIMIT 10;
Thử hình dung kết quả cho thấy một số khách có hai, ba bản ghi, mỗi lần đổi địa chỉ hệ thống lại thêm một dòng mới chứ không cập nhật dòng cũ. Mỗi đơn của những khách đó sẽ bị nhân lên khi JOIN. Đó chính là phần doanh thu bị đội lên.
Bước tiếp theo là đo trực tiếp tác động của JOIN, thay vì đoán:
-- 2. JOIN có làm thay đổi số dòng không?
SELECT
  (SELECT COUNT(*) FROM orders) AS truoc_join,
  (SELECT COUNT(*) FROM orders o
     JOIN customers c ON c.customer_id = o.customer_id) AS sau_join;

-- 3. Có đơn nào không khớp khách hàng (sẽ bị INNER JOIN bỏ mất)?
SELECT COUNT(*) AS don_khong_khop
FROM orders o
LEFT JOIN customers c ON c.customer_id = o.customer_id
WHERE c.customer_id IS NULL;
Hai con số truoc_join và sau_join phải bằng nhau. Nếu sau_join lớn hơn, bạn đang nhân dòng. Nếu don_khong_khop lớn hơn 0, câu INNER JOIN ban đầu đang lặng lẽ bỏ qua những đơn đó.
Cách sửa: với mỗi khách, chỉ giữ bản ghi mới nhất, và dùng LEFT JOIN để không đơn nào bị mất.
WITH kh AS (
  SELECT customer_id, region,
         ROW_NUMBER() OVER (PARTITION BY customer_id
                            ORDER BY updated_at DESC) AS rn
  FROM customers
)
SELECT COALESCE(kh.region, '(không rõ)') AS region,
       SUM(o.amount) AS doanh_thu
FROM orders o
LEFT JOIN kh ON kh.customer_id = o.customer_id AND kh.rn = 1
GROUP BY 1
ORDER BY doanh_thu DESC;
Dòng (không rõ) không phải lỗi cần giấu đi. Nó là một phát hiện để mang lại cho khách hàng: có bao nhiêu đơn không gắn được với khách nào, và vì sao.
Python biến phép kiểm tra thành thứ chạy lại được
Câu SQL ở trên chỉ trả lời cho hôm nay. Tuần sau, khi dữ liệu mới đổ vào, bạn cần những phép kiểm tra đó tự chạy và tự báo lỗi. Python làm việc này, và đây cũng là chỗ “xử lý và phân tích dữ liệu” trong tin tuyển của Palantir trở thành việc cụ thể.
import os
import pandas as pd
from sqlalchemy import create_engine

engine = create_engine(os.environ["CUSTOMER_DB_URL"])

orders = pd.read_sql("SELECT order_id, customer_id, amount FROM orders", engine)
customers = pd.read_sql(
    "SELECT customer_id, region, updated_at FROM customers", engine
)

# Giữ bản ghi mới nhất cho mỗi khách
customers = (customers.sort_values("updated_at")
                      .drop_duplicates("customer_id", keep="last"))

# validate sẽ ném lỗi nếu phía customers vẫn còn trùng khóa
merged = orders.merge(customers, on="customer_id",
                      how="left", validate="many_to_one")
assert len(merged) == len(orders), "JOIN làm thay đổi số dòng"

ty_le_khong_khop = merged["region"].isna().mean()
print(f"Tỷ lệ đơn không khớp khách hàng: {ty_le_khong_khop:.1%}")

report = (merged.fillna({"region": "(không rõ)"})
                .groupby("region")["amount"].sum()
                .sort_values(ascending=False))
Ba dòng đáng giá nhất ở đây là validate="many_to_one", câu assert và dòng in tỷ lệ đơn không khớp khách hàng. Chúng biến kinh nghiệm của buổi chiều thứ Hai thành điều kiện bắt buộc. Lần sau dữ liệu có vấn đề, pipeline sẽ dừng lại trước khi con số sai kịp đến tay khách hàng.
Tự làm theo thứ tự nào?
Mỗi khi gặp một bảng mới của khách hàng, hãy làm theo cùng một trình tự. Đầu tiên đếm số dòng và số khóa phân biệt để biết khóa có thật sự duy nhất không. Sau đó đo số dòng trước và sau mỗi JOIN, đồng thời đếm bản ghi bị rơi bằng LEFT JOIN kèm IS NULL.
Khi đã thấy vấn đề, sửa ngay ở tầng truy vấn bằng ROW_NUMBER() hoặc một quy tắc chọn bản ghi mà bạn đã xác nhận với khách hàng. Cuối cùng, chuyển toàn bộ các phép kiểm tra sang Python dưới dạng assert, và luôn báo cáo kèm tỷ lệ dữ liệu không khớp thay vì chỉ đưa ra con số tổng.
Những lỗi hay gặp
Lỗi phổ biến nhất là dùng INNER JOIN theo thói quen. Nó trông gọn gàng nhưng bỏ đi đúng những bản ghi bạn cần thấy. Cũng hay gặp là tự quyết định quy tắc khử trùng lặp: “lấy bản ghi mới nhất” là một quyết định nghiệp vụ, nên phải hỏi khách hàng, không tự đoán.
Một lỗi khác là chữa cháy bằng SELECT DISTINCT ở cuối truy vấn. Cách này che triệu chứng nhưng không cho bạn biết nguyên nhân, và có thể gộp mất những dòng vốn khác nhau thật.
Lỗi cuối cùng là chỉ kiểm tra bằng tay trong notebook mà không lưu lại thành script. Tuần sau dữ liệu đổi, lỗi cũ quay lại và không ai nhớ đã từng kiểm tra gì.
Thể hiện kỹ năng này trên CV thế nào?
Với một developer Việt Nam đang muốn chuyển sang FDE, dòng “thành thạo Python, SQL” trên CV gần như không nói lên điều gì. Một dòng thuyết phục hơn sẽ kể chuyện: phát hiện bảng khách hàng bị trùng khóa làm doanh thu báo cáo bị đội lên, viết phép kiểm tra tự động bằng pandas, và báo cáo tỷ lệ đơn không khớp cho bên vận hành.
Bài tập tuần này
Lấy một database thật mà bạn có quyền đọc, ở công ty hoặc từ một bộ dữ liệu công khai có ít nhất hai bảng liên quan. Chọn một câu báo cáo bạn hoặc đồng nghiệp từng viết, chạy ba phép kiểm tra ở trên, rồi viết lại nó thành một script Python có validate và assert.
Nếu cả ba phép kiểm tra đều sạch, bạn vừa có bằng chứng con số đó đúng. Nếu không, bạn vừa tìm ra lỗi trước khi khách hàng tìm ra, và đó là công việc của một FDE.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
6 nguồn
- Forward Deployed Software Engineer - US Government (Palantir)
- Forward Deployed Software Engineer - Japan Forward Deployed (Palantir)
- Sr. Forward Deployed Engineer (Singapore, Job ID CSQ427R248) - Databricks
- SQL Skills Every Forward Deployed Engineer Needs · 2026-09-27
- What is a forward deployed engineer? A complete guide · 2026-09-03
- The Forward Deployed Engineer Role (Capicua) · 2026-07-23