Phỏng vấn FDE ở Snowflake có thể mở đầu bằng chính sếp tương lai
Tin tuyển dụng mới là đề cương đáng ôn: biến mục tiêu kinh doanh mơ hồ thành SQL chạy được, rồi thành con số chất lượng khách hàng tin.

Tóm tắt nhanh
- Trang tuyển dụng chính thức của Snowflake mô tả bốn vòng cho các vị trí kỹ thuật, kéo dài hai đến bốn tuần, có live coding, kiểm tra tham chiếu và kiểm tra lý lịch.
- Tin tuyển FDE Applied AI yêu cầu Python và SQL, RAG, agentic workflow, eval, và dành ít nhất 25% thời gian làm việc tại chỗ khách hàng.
- Cách ôn hiệu quả nhất là luyện cả chuỗi: làm rõ mục tiêu, viết SQL lấy baseline, dựng golden dataset, rồi đọc kết quả theo từng nhóm.
Bạn vừa nhận lịch phỏng vấn vị trí Forward Deployed Engineer ở Snowflake và định bật LeetCode lên luyện. Khoan đã: theo trang tuyển dụng của Snowflake, buổi gặp đầu tiên có thể là với chính người sẽ làm quản lý của bạn. Họ gọi đó là cách “phá băng” ngay từ ngày đầu.
Còn muốn biết nên ôn gì, hãy đọc tin tuyển dụng. Theo tin tuyển FDE Applied AI, người làm vị trí này phải dành nhiều thời gian ở chỗ khách hàng, nhận những mục tiêu kinh doanh chưa rõ ràng rồi biến chúng thành giải pháp bằng Python và SQL.
Vì vậy cách ôn tốt nhất là luyện đúng chuỗi việc đó, từ câu hỏi làm rõ đến con số chất lượng cuối cùng.
Những gì đã biết chắc, và những gì mới là phỏng đoán
Trang tuyển dụng chính thức của Snowflake viết rằng quy trình cho các vị trí kỹ thuật nói chung gồm bốn vòng, có thể kéo dài từ hai đến bốn tuần. Ứng viên được dặn chuẩn bị live coding và các bài đánh giá cùng người phỏng vấn. Cuối cùng là kiểm tra tham chiếu và kiểm tra lý lịch tiêu chuẩn theo luật lao động sở tại.
Snowflake không công bố từng vòng gồm những gì, và mô tả bốn vòng này áp dụng chung cho kỹ sư chứ không riêng FDE. Phần còn lại đến từ nguồn bên ngoài, nên bạn chỉ nên coi là giả thuyết.
Một hướng dẫn của Aced (trước đây là Exponent) mô tả vòng cuối của kỹ sư phần mềm là 3 đến 5 buổi panel, gồm kỹ thuật, chuyên môn, system design, hành vi và cộng tác.
Dữ liệu ứng viên chia sẻ trên interviewing.io cho thấy câu hỏi coding thường ở mức LeetCode medium, còn system design nghiêng về hệ thống dữ liệu và thiết kế cơ sở dữ liệu.
Aced cũng ghi nhận Snowflake muốn xem bạn xử lý dữ liệu lớn và làm việc với database ra sao. Vì thế, nếu thời gian ôn có hạn, hãy ưu tiên SQL và thiết kế dữ liệu hơn các bài thuật toán đồ thị.
Đề bài thật sự là “mục tiêu mơ hồ”
Tin tuyển FDE Applied AI của Snowflake yêu cầu biến những mục tiêu kinh doanh còn mơ hồ thành giải pháp vững, mở rộng được và chạy nhanh, bằng Python và SQL. Cũng tin này yêu cầu dành ít nhất 25% thời gian tại chỗ với những khách hàng chiến lược nhất của Snowflake.
Tin còn đòi kinh nghiệm xây ứng dụng LLM, đặc biệt là RAG và agentic workflow. Bạn cũng phải từng tự tay đặt chỉ số chất lượng và chạy eval cho hệ thống LLM hoặc agent.
Tin tuyển cấp staff nói rõ hơn nữa: chuyển mục tiêu mơ hồ của khách hàng thành chỉ số đo được, eval framework và golden dataset.
Một bài tập mẫu: “giảm tải cho đội support”
Thử hình dung đề bài sau: khách hàng là một công ty bán lẻ, lưu ticket hỗ trợ trong Snowflake và muốn một trợ lý AI “giảm tải cho đội support”. Nếu bạn lao vào vẽ kiến trúc RAG ngay, bạn đã bỏ qua bước quan trọng nhất.
Hãy hỏi trước: giảm tải được đo bằng gì, thời gian phản hồi hay số ticket người phải xử lý? Nhóm ticket nào chiếm nhiều nhất? Dữ liệu nằm ở những bảng nào?
Giả sử người phỏng vấn trả lời: đo bằng thời gian phản hồi đầu tiên, dữ liệu nằm ở hai bảng tickets và messages. Việc đầu tiên là lấy baseline, vì không có baseline thì không chứng minh được giá trị. Câu SQL dưới đây chạy được trên Snowflake:
-- Thời gian phản hồi đầu tiên theo danh mục, 90 ngày gần nhất
WITH first_reply AS (
  SELECT ticket_id, MIN(sent_at) AS first_agent_reply_at
  FROM messages
  WHERE sender_type = 'agent'
  GROUP BY ticket_id
)
SELECT t.category,
       COUNT(*) AS tickets,
       COUNT(f.ticket_id) AS replied_tickets,
       MEDIAN(DATEDIFF('minute', t.created_at, f.first_agent_reply_at)) AS median_first_reply_min
FROM tickets t
LEFT JOIN first_reply f ON f.ticket_id = t.ticket_id
WHERE t.created_at >= DATEADD('day', -90, CURRENT_DATE)
GROUP BY t.category
ORDER BY tickets DESC;
Điểm đáng nói nằm ở CTE first_reply. Nếu join thẳng tickets với messages, một ticket có sáu tin nhắn sẽ thành sáu dòng, và COUNT(*) sẽ đếm số tin nhắn chứ không phải số ticket. Hãy tập thói quen gom mỗi ticket về một dòng trước khi join, và nói rõ lý do khi đang viết.
LEFT JOIN cũng có lý do. Nó giữ lại những ticket chưa ai trả lời, và cột replied_tickets cho thấy có bao nhiêu ticket như vậy. Hãy nói thành lời rằng median chỉ tính trên ticket đã có phản hồi, nên nhóm chưa được trả lời phải báo cáo riêng.
Con số 80% đang che giấu điều gì?
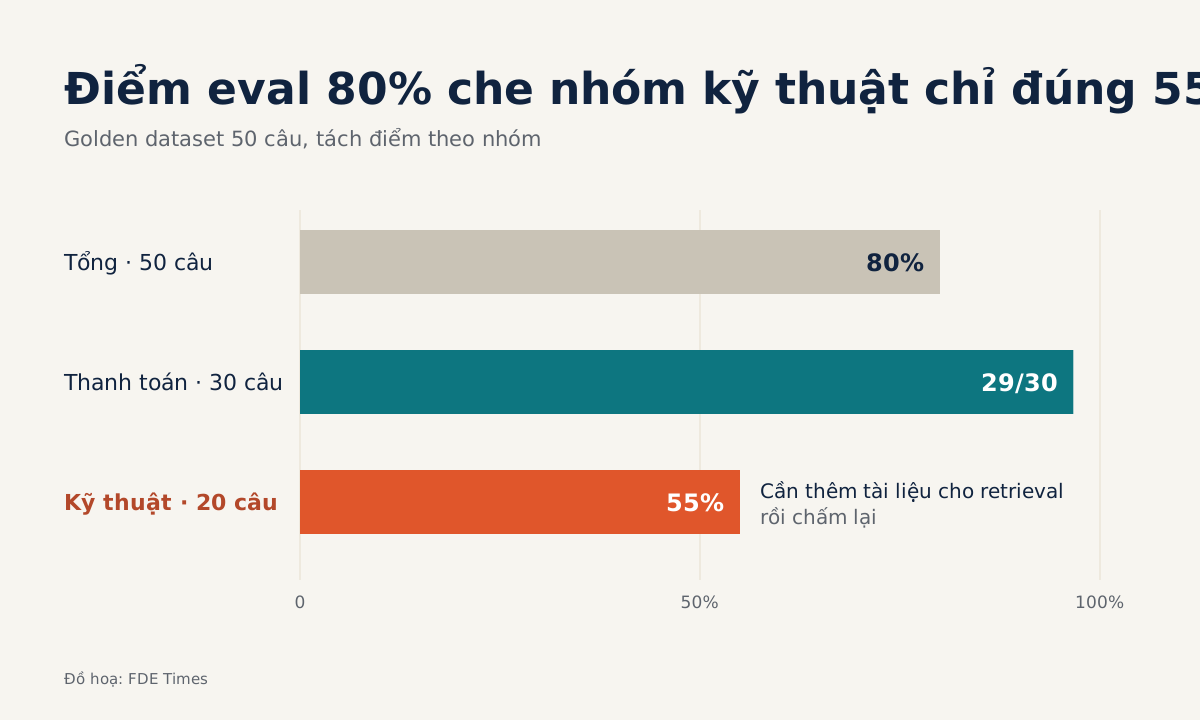
Sang phần eval. Giả sử bạn dựng golden dataset gồm 50 câu hỏi lấy từ ticket thật: 30 câu về thanh toán và 20 câu về lỗi kỹ thuật. Agent trả lời đúng 40 câu, tức 80%. Nghe ổn, cho đến khi bạn tách theo nhóm: thanh toán đúng 29/30, kỹ thuật chỉ đúng 11/20, tức 55%.
from collections import defaultdict

def score_by_category(results):
    totals, correct = defaultdict(int), defaultdict(int)
    for r in results:
        totals[r["category"]] += 1
        correct[r["category"]] += int(r["is_correct"])
    return {c: correct[c] / totals[c] for c in totals}
Đến đây, nối ngược lại câu SQL ban đầu. Nếu baseline cho thấy ticket kỹ thuật là nhóm đông nhất, con số 80% đang che đúng chỗ khách hàng cần nhất. Một khuyến nghị hợp lý là: “Triển khai trước cho nhóm thanh toán, còn nhóm kỹ thuật cần thêm tài liệu cho retrieval rồi chấm lại.”
Tin tuyển cấp staff liệt kê các công cụ eval và observability như Braintrust, LangSmith, Arize, Weave, Promptfoo ở mục kỹ năng ưu tiên. Biết một trong số đó là lợi thế. Nhưng nếu bạn giải thích được vì sao phải tách điểm theo nhóm, công cụ nào cũng chỉ là chi tiết.
Nội dung từng vòng chưa công bố, ôn thế nào?
Vì Snowflake không nói vòng nào kiểm tra gì, hãy ôn theo những thứ đã chắc chắn và những gì tin tuyển đòi hỏi. Bắt đầu từ live coding: luyện bài LeetCode medium bằng Python, vừa làm vừa nói thành tiếng. Song song, ôn SQL theo kiểu dân dữ liệu: window function, CTE, LEFT JOIN với giá trị NULL, và lỗi nhân bản dòng khi join quan hệ một-nhiều.
Với system design, hãy luyện thiết kế hệ thống dữ liệu thay vì mạng xã hội hay app gọi xe. Một đề tốt để tự luyện: đưa ticket mới vào bảng, cập nhật index cho RAG, lưu kết quả eval theo từng phiên bản prompt. Vẽ schema, chỉ ra khóa chính, và giải thích bạn sẽ truy vấn bảng eval thế nào để so hai phiên bản.
Với hiring manager và các buổi nói về hành vi, chuẩn bị hai câu chuyện: một lần bạn biến yêu cầu mơ hồ thành chỉ số, và một lần bạn làm việc trực tiếp với người dùng hoặc khách hàng. Vì có kiểm tra tham chiếu, hãy báo trước cho người sẽ xác nhận cho bạn, để họ kể đúng những dự án bạn nhắc đến.
Trên CV, đừng ghi chung chung “có kinh nghiệm với LLM”. Hãy viết một dòng kiểm chứng được, kiểu “dựng golden dataset 50 câu, tách điểm theo danh mục, phát hiện nhóm kỹ thuật chỉ đạt 55%”. Lời khuyên này đúng với mọi vị trí FDE, không riêng Snowflake.
Những lỗi khiến ứng viên giỏi vẫn trượt
Lỗi dễ mắc nhất là giải ngay đề bài trước khi hỏi mục tiêu được đo bằng gì. Với vai trò mà tin tuyển ghi rõ chữ “mơ hồ”, bỏ qua bước làm rõ tức là bỏ qua chính kỹ năng tin tuyển nhấn mạnh.
Kế đến là viết SQL cho ra số mà không kiểm tra số đó có hợp lý không. Chỉ cần đếm thử số ticket trước và sau khi join là đã bắt được lỗi nhân bản dòng. Cũng đừng báo một con số eval tổng rồi dừng ở đó, trong khi khách hàng cần biết agent hỏng ở đâu.
Lỗi cuối cùng ít người để ý: coi buổi gặp hiring manager chỉ là buổi làm quen. Snowflake gọi đó là cách phá băng, nhưng với một vị trí dành ít nhất 25% thời gian ở chỗ khách hàng, bạn nên tận dụng buổi đó để cho thấy cách mình trao đổi và đặt câu hỏi.
Nếu tuần này chỉ làm được một việc, hãy luyện trọn vẹn bài “giảm tải cho đội support” trên một bộ dữ liệu thật, từ câu hỏi làm rõ đến bảng điểm theo nhóm. Làm được trơn tru chuỗi đó thì vòng nào bạn cũng có cái để nói.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!