Vì sao câu truy vấn đầu tiên trên database của khách ra sai doanh thu
Bảng bạn đọc có thể chỉ là một shard, dữ liệu khách hàng nằm ở database khác, hoặc cột region là bản chép cũ chưa từng cập nhật.
Tóm tắt nhanh
- Federation tách theo chức năng, sharding chia cùng một bảng thành nhiều phần có chung schema. Khi một bảng quá lớn, federation hết tác dụng và sharding là lựa chọn còn lại.
- Shard key là quyết định thiết kế quan trọng nhất và rất tốn kém để đổi, nên nó cho bạn biết khách thường hỏi dữ liệu theo trục nào.
- Truy vấn xuyên shard chậm bằng shard chậm nhất, và cả hai cách chia đều khiến JOIN phức tạp hơn, nên phải lập bản đồ dữ liệu trước khi viết SELECT.
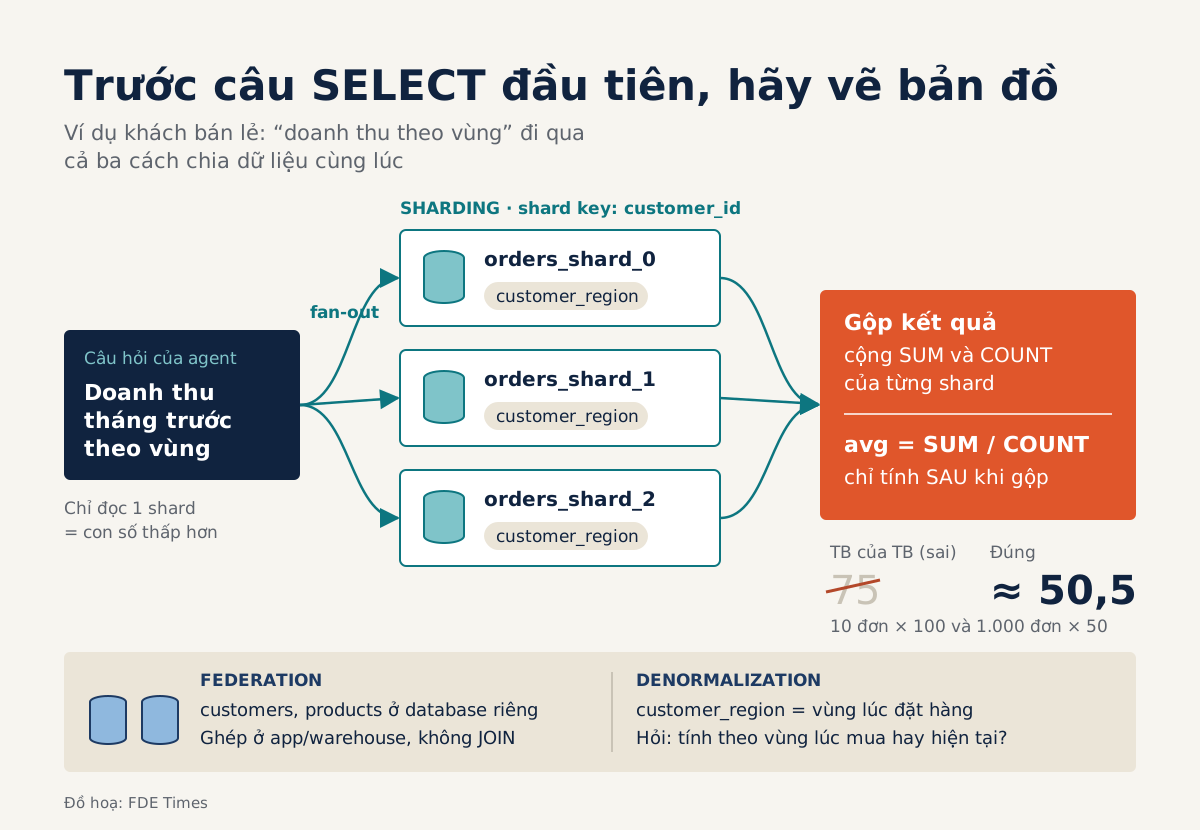
Thử hình dung tuần đầu ở một khách hàng bán lẻ. Bạn có quyền read-only và phải làm một agent trả lời “doanh thu tháng trước theo vùng”. Bạn viết SELECT ... JOIN customers ... GROUP BY region, chạy thử, và nhận về con số thấp hơn báo cáo tài chính đến mức khó hiểu.
Câu truy vấn không sai cú pháp, database cũng không hỏng. Có thể bảng orders bạn đang đọc chỉ là một shard. Có thể customers nằm ở một database khác hẳn, hoặc cột region trong orders là bản chép từ lâu và chưa từng được cập nhật.
Muốn biết chuyện gì đang xảy ra, bạn cần phân biệt hai cách chia database. Federation tách database theo chức năng, ví dụ users một nơi, orders một nơi. Sharding chia dữ liệu của cùng một bảng ra nhiều database có chung schema, mỗi nơi giữ một tập con riêng.
Khi một chức năng hay một bảng phình quá lớn, federation không còn hiệu quả, và đó là lúc sharding trở thành lựa chọn. Nhưng với một FDE, câu hỏi thực tế hiếm khi là “nên chọn bên nào”. Câu hỏi là khách đã chọn gì, và điều đó thay đổi câu truy vấn của bạn ra sao.
Federation vs sharding: khác nhau ở tiêu chí nào?
Bảng dưới đây là cách nhanh nhất để nhận diện hai kỹ thuật khi bạn mở hệ thống của khách.
| Tiêu chí | Federation | Sharding |
|---|---|---|
| Chia theo gì | Theo chức năng nghiệp vụ | Theo dòng dữ liệu, mỗi shard một tập con |
| Schema | Mỗi database một schema riêng | Mọi shard cùng một schema |
| Dấu vết thường gặp | Mỗi database mang tên một miền: users, products, orders | Nhiều database cùng cấu trúc, tên đánh số |
| JOIN | Ghép dữ liệu giữa hai database phức tạp hơn | Truy vấn xuyên shard chậm bằng shard chậm nhất |
| Khi nào hết tác dụng | Khi một chức năng hay một bảng quá lớn | Khi dữ liệu dồn lệch về vài shard |
| Truy vấn của bạn phải làm gì | Ghép ở tầng ứng dụng hoặc warehouse | Fan-out, gộp bằng SUM và COUNT |
Cả hai đều đòi hỏi logic ứng dụng phải thay đổi, theo system-design-primer. Federation còn được mô tả là cách làm nhiều database vật lý trông như một database logic, nên đừng ngạc nhiên nếu một lớp truy cập dữ liệu của khách giấu đi chuyện dữ liệu đang nằm ở nhiều nơi.
Vì sao database của khách không còn là một khối?
MongoDB chỉ ra rằng database SQL theo truyền thống được scale theo chiều dọc: thêm CPU, ổ lưu trữ hay bộ nhớ vào một server duy nhất. Khi một server không gánh nổi nữa, khách phải chia dữ liệu ra nhiều nơi, và federation lẫn sharding đều là những cách chia như thế.
Kỹ thuật thứ ba hay đi cùng là denormalization: một chiến lược áp lên database vốn đã chuẩn hóa để tăng hiệu năng. Nó giúp đọc nhanh hơn, nhưng phải trả bằng một phần hiệu năng ghi.
Ba kỹ thuật này hay xuất hiện cùng nhau. Chính Azure khuyên các thiết kế sharded nên denormalize để những thực thể thường được truy vấn chung, như khách hàng và đơn hàng của họ, nằm trên cùng một shard. Vì thế gặp một kỹ thuật thì bạn nên đi tìm luôn hai kỹ thuật còn lại.
Shard key cho bạn biết khách hỏi dữ liệu theo trục nào
Azure gọi shard key là quyết định thiết kế quan trọng nhất. Muốn đổi nó sau này, khách thường phải chuyển toàn bộ dữ liệu sang một bố cục shard mới, một việc tốn kém và rủi ro trên hệ thống đang chạy. Vì thế shard key cho thấy đội kỹ thuật của khách đã đặt cược phần lớn truy vấn sẽ đi theo trục nào.
Nếu khách shard theo customer_id, câu hỏi kiểu “đơn hàng của khách X” rơi vào đúng một shard. Còn câu hỏi của bạn, doanh thu theo vùng trên toàn bộ khách hàng, phải đi qua tất cả các shard. Azure nhắc rằng dù chạy song song, độ trễ chung vẫn do shard chậm nhất quyết định.
Kiểu sharding cũng là điều nên hỏi. Azure liệt kê bốn chiến lược: lookup (còn gọi là directory-based, dùng một bản đồ định tuyến request tới shard chứa dữ liệu), range, hash và theo địa lý. Bản đồ shard trong kiểu lookup thường là tài liệu đầu tiên bạn nên xin.
Nếu khách chia bằng hash(key) mod N, bạn có thể tự tính cái giá của việc thêm shard. Khi tăng từ 4 lên 5 shard, một key chỉ đứng yên nếu h mod 4 bằng h mod 5.
Vì 20 là bội chung nhỏ nhất của 4 và 5, chỉ cần xét 20 khả năng của h mod 20: bốn khả năng 0, 1, 2, 3 thỏa điều kiện, 16 khả năng còn lại thì không.
Nếu hash phân bố đều, chỉ khoảng 4/20 số key đứng yên, tức khoảng 80% key phải chuyển chỗ. Bạn cần để ý con số này vì trong lúc dữ liệu đang được chuyển, một đơn hàng có thể tạm nằm ở shard cũ, shard mới, hoặc cả hai. Hãy hỏi xem có đợt di chuyển nào đang chạy trước khi tin vào một con số tổng.
Ví dụ từ đầu đến cuối: doanh thu theo vùng
Quay lại khách bán lẻ giả định. Sau một buổi đọc connection string và hỏi DBA, bạn vẽ được bức tranh: orders được shard theo customer_id ra 3 shard. customers và products nằm ở hai database riêng theo kiểu federation. Trong orders có cột customer_region, được chép từ customers lúc tạo đơn.
Nhờ cột chép trùng này, bạn không cần JOIN sang database khách hàng, và đó chính là lý do người ta denormalize. Việc còn lại là fan-out tới từng shard rồi gộp kết quả:
from collections import defaultdict

SHARDS = ["orders_shard_0", "orders_shard_1", "orders_shard_2"]

SQL = """
SELECT customer_region AS region,
       SUM(total)      AS revenue,
       COUNT(*)        AS n_orders
FROM orders
WHERE order_date >= %s AND order_date < %s
GROUP BY customer_region
"""

def revenue_by_region(start, end):
    agg = defaultdict(lambda: {"revenue": 0, "n_orders": 0})
    for dsn in SHARDS:
        for region, revenue, n in run_query(dsn, SQL, [start, end]):
            agg[region]["revenue"] += revenue
            agg[region]["n_orders"] += n
    for r in agg.values():
        r["avg_order"] = r["revenue"] / r["n_orders"]
    return dict(agg)
Chi tiết đáng chú ý là dòng tính avg_order. Mỗi shard chỉ trả về SUM và COUNT, còn giá trị trung bình được tính sau khi gộp.
Giả sử shard 0 có 10 đơn với trung bình 100, shard 1 có 1.000 đơn với trung bình 50. Trung bình của hai trung bình là 75, trong khi con số đúng là (1.000 + 50.000) / 1.010, xấp xỉ 50,5.
Giờ đến cột denormalized. customer_region là vùng của khách tại thời điểm đặt hàng. Nếu khách chuyển từ vùng Bắc sang vùng Nam, các đơn cũ vẫn mang nhãn vùng Bắc. Đây là câu hỏi nghiệp vụ: phòng tài chính muốn tính theo vùng lúc mua hay vùng hiện tại? Hãy hỏi trước khi agent tự trả lời thay họ.
Giả sử họ cần thêm doanh thu theo danh mục sản phẩm, mà danh mục chỉ có trong database products. Đây là chỗ federation gây khó, vì JOIN giữa hai database phức tạp hơn. Một cách làm thực tế là kéo bảng ánh xạ product_id → category (thường nhỏ) vào bộ nhớ hoặc warehouse, rồi gộp ở tầng ứng dụng.
Năm bước trước câu truy vấn đầu tiên
Bước đầu là lập bản đồ: có bao nhiêu database, mỗi cái giữ chức năng gì, bảng nào bị chia shard. Connection string, file cấu hình ORM và những tên kiểu orders_shard_07 là manh mối nhanh nhất. Bước hai là tìm shard key và chiến lược sharding, rồi hỏi có đợt chuyển dữ liệu nào đang chạy không.
Bước ba là liệt kê các cột bị chép trùng và tìm nguồn gốc từng cột: cột ấy được cập nhật khi nào, bằng job nào, có bị trễ không.
Bước bốn là xếp mỗi câu hỏi nghiệp vụ vào một trong ba nhóm: chỉ chạm một shard, phải fan-out, hoặc phải ghép dữ liệu từ nhiều database chức năng.
Bước cuối là thống nhất với khách về độ tươi của số liệu: con số tổng hợp từ nhiều nơi được phép trễ bao lâu so với hệ thống nguồn. Đây là thỏa thuận nên có bằng văn bản trước khi agent trả lời câu hỏi đầu tiên.
Những lỗi FDE hay mắc
Lỗi phổ biến nhất là tưởng mình đang đọc toàn bộ dữ liệu trong khi chỉ đọc một shard. Lỗi thứ hai là lấy trung bình của các trung bình, hoặc chạy COUNT(DISTINCT) trên từng shard rồi cộng lại, trong khi cùng một giá trị có thể xuất hiện ở nhiều shard.
Lỗi thứ ba khó thấy hơn: chạy fan-out nặng vào giờ cao điểm trên production. Dữ liệu có thể phân bố lệch, nên một shard “nóng” có thể kéo chậm cả truy vấn của bạn lẫn hệ thống của khách. Hãy hỏi có read replica không trước khi chạy.
Lỗi cuối cùng là đề xuất “gom hết về một database cho gọn”, hoặc ngược lại “shard thêm cho nhanh”, ngay tuần đầu. Azure nói sharding mang lại độ phức tạp đáng kể và vĩnh viễn, và liệt kê những trường hợp nó không phù hợp, trong đó có nút thắt nằm ở phía đọc. Hệ thống của khách là kết quả của những đánh đổi có thật.
Federation có phải là một kiểu sharding không?
Không hẳn, nhưng đừng tranh cãi chữ nghĩa với khách. Một bài viết năm 2007 trên High Scalability xếp federation và sharding là hai trường hợp cụ thể của partitioning, nên khách có thể dùng ba từ này lẫn cho nhau. Hãy hỏi họ dữ liệu được chia theo chức năng hay theo dòng, rồi tự ghi lại cho đúng.
Còn denormalization có phải là dấu hiệu thiết kế kém? Thường thì không. Cột chép trùng báo cho bạn biết hệ thống được tối ưu cho đọc, và việc của bạn là tìm cột gốc.
Trên CV, một dòng như “dựng lớp truy vấn fan-out qua 3 shard, thống nhất với khách cách xử lý cột chép trùng và độ trễ số liệu” nói nhiều hơn hẳn hai chữ “biết sharding”.
Lần tới khi được cấp quyền vào database của khách, đừng viết SELECT ngay. Hãy dành một giờ vẽ bản đồ shard, các database chức năng và những cột bị chép trùng, vì phần lớn câu trả lời đúng nằm ở đó.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
6 nguồn
- Sharding Pattern - Azure Architecture Center | Microsoft Learn · 2026-04-02
- System Design: Database Federation · 2022-09-12
- GitHub - donnemartin/system-design-primer: Learn how to design large-scale systems.
- Denormalization - Wikipedia
- NoSQL Vs SQL Databases | MongoDB
- Is there a difference between partitioning and federation and sharding? · 2007-09-10