Ba lỗi metering khiến khách khiếu nại hoá đơn token
Hai lỗi chặn được từ lúc thiết kế sự kiện, lỗi thứ ba cần đối soát xong trước khi hoá đơn bị chốt.
Tóm tắt nhanh
- Với Anthropic, input_tokens chỉ đếm phần nằm sau cache breakpoint cuối cùng. Muốn có tổng input phải cộng thêm hai trường cache.
- Retry khi mạng chậm dễ làm một lần gọi bị đếm hai lần. Chặn lỗi này bằng một identifier tất định cho mỗi sự kiện.
- Stripe xử lý meter event bất đồng bộ, và usage đến sau khi hoá đơn đã chốt thì không được tính tiền. Vì vậy phải đối soát xong trong thời gian ân hạn.
Khách gửi email cho bạn kèm một file CSV. Log của họ ghi một con số token, hoá đơn tháng này ghi một con số khác, và họ muốn biết vì sao. Lúc đó bạn không còn là người viết integration nữa. Bạn đang phải trả lời một câu hỏi về tiền, và câu trả lời phải khớp tới từng dòng.
Chuyện này không cần đến sự cố lớn mới xảy ra. Ba lỗi nhỏ có sẵn trong thiết kế là đủ: đếm thiếu vì hiểu sai trường usage, đếm trùng vì retry, và đếm trễ vì sự kiện tới sau khi kỳ thanh toán đã khoá.
Nếu bạn là FDE triển khai sản phẩm AI tính tiền theo token, cả ba lỗi này là việc của bạn chứ không phải của đội finance.
Tin tốt là lỗi nào cũng chặn trước được. Điều kiện là bạn coi mỗi lần gọi model là một bút toán kế toán, không chỉ là một dòng log.
input_tokens có phải tổng input không?
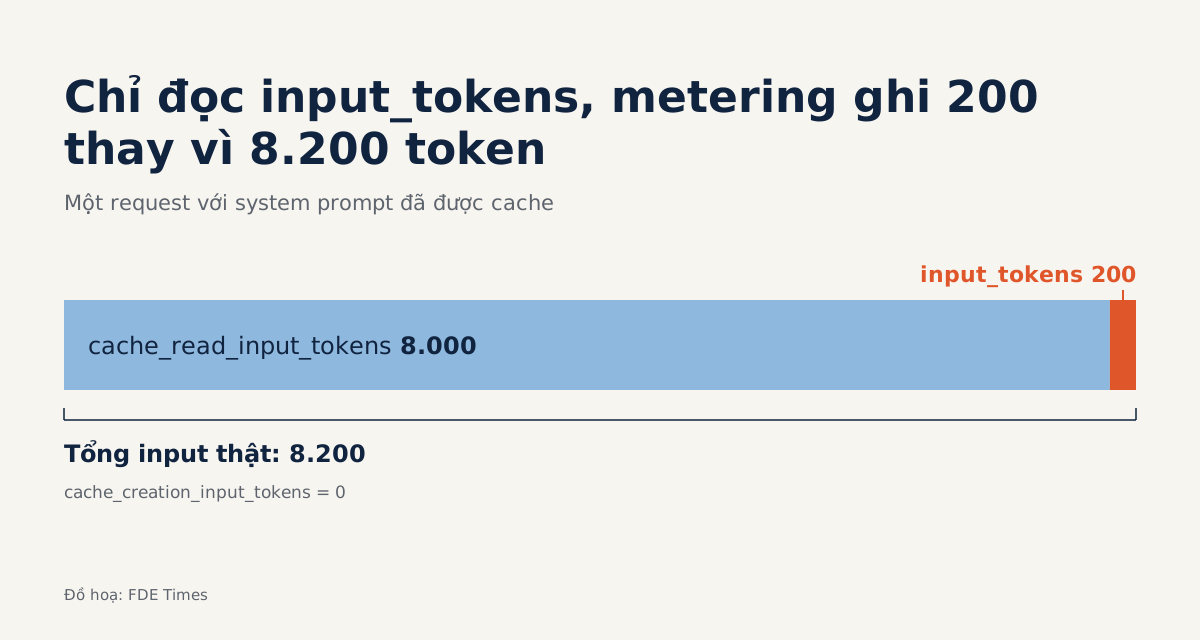
Không, ít nhất là với Anthropic. Tài liệu về prompt caching của Anthropic ghi rõ trường input_tokens chỉ đếm những token nằm sau cache breakpoint cuối cùng, không phải toàn bộ input bạn đã gửi. Tổng input phải tính bằng cache_read_input_tokens + cache_creation_input_tokens + input_tokens.
Thử hình dung một agent có system prompt dài đã được cache. Một request trả về input_tokens = 200, cache_read_input_tokens = 8000, cache_creation_input_tokens = 0 và 500 token output. Nếu hệ thống metering chỉ đọc input_tokens, nó ghi 200 token input, trong khi con số thật là 8.200.
Khó hơn nữa, các provider không đếm giống nhau. Tài liệu của thư viện ReqLLM ghi rằng usage của Anthropic thường mang cờ input_includes_cached: false, còn của OpenAI thường là true. Đem công thức cộng ba trường áp cho một provider đã gộp sẵn cache vào input thì cache sẽ bị đếm hai lần.
Kể cả khi tổng đã đúng, bạn cũng không nên gửi đi một con số gộp. ReqLLM lưu ý rằng cache read và cache write có bộ đếm riêng vì provider có thể tính giá khác nhau, và reasoning token cũng có thể có giá riêng. Nếu hợp đồng với khách có nhiều mức giá, sự kiện của bạn phải giữ riêng từng loại token.
Gửi hai lần mà chỉ tính tiền một lần
Lỗi thứ hai xảy ra ở tầng mạng. Bạn gửi usage lên hệ thống billing, request bị timeout, code retry, trong khi lần gửi đầu thực ra đã thành công. Stripe khuyên dùng idempotency key chính vì trường hợp này: mỗi meter event có một identifier mà bạn tự đặt được, còn nếu bạn bỏ trống thì Stripe tự sinh.
Chỗ dễ sai là phần “Stripe tự sinh”. Nếu mỗi lần retry lại để Stripe tạo identifier mới, hai lần gửi sẽ thành hai sự kiện khác nhau. Identifier phải tất định, nghĩa là suy ra được từ chính lần gọi model, chẳng hạn ghép mã khách với request id của provider.
Bài viết về kiến trúc ingestion của Lago định nghĩa exactly-once theo đúng hướng này: chống trùng dựa trên event_id và một idempotency_key do phía client sinh ra. Hàm dưới đây làm cả hai việc, chuẩn hoá usage và gắn định danh:
def build_usage_event(provider, customer_id, request_id, usage, ts):
    # usage đã được map về tên trường chung; tên gốc tuỳ provider
    cache_read = usage.get("cache_read", 0)
    cache_write = usage.get("cache_write", 0)
    raw_input = usage["input"]

    INPUT_INCLUDES_CACHED = {"anthropic": False, "openai": True}
    if INPUT_INCLUDES_CACHED[provider]:
        uncached_input = raw_input - cache_read - cache_write
    else:
        uncached_input = raw_input

    return {
        "identifier": f"{customer_id}:{provider}:{request_id}",
        "customer_id": customer_id,
        "timestamp": ts,  # lúc gọi model, không phải lúc gửi
        "uncached_input": uncached_input,
        "cache_read": cache_read,
        "cache_write": cache_write,
        "output": usage["output"],
    }
Gọi hàm này hai lần cho cùng một request, bạn nhận về cùng một identifier. Cơ chế chống trùng chỉ có vậy: hệ thống phía sau thấy sự kiện đã tồn tại và bỏ qua bản gửi sau.
Hãy để ý trường timestamp được lấy theo lúc gọi model. Tài liệu của Stripe yêu cầu timestamp nằm trong 35 ngày lịch gần nhất và không vượt quá 5 phút trong tương lai. Chỉ cần đồng hồ máy chủ chạy nhanh vài phút, hoặc một job backfill chạy quá muộn, sự kiện đã có thể bị từ chối.
Lưu lượng lớn thì gộp trước rồi mới gửi
Stripe giới hạn Meter Event ở 1000 lời gọi mỗi giây trên một tài khoản, và mỗi cặp khách với meter chỉ được một lời gọi đồng thời. Một agent chạy nhiều tác vụ song song cho cùng một khách sẽ đụng giới hạn thứ hai rất sớm.
Cách hợp lý là ghi từng lần gọi vào sổ cái nội bộ, rồi gộp theo cửa sổ thời gian trước khi gửi đi. Khi đó identifier cũng phải tất định theo cửa sổ, ví dụ customer:meter:2026-11-17T10:05, để gửi lại một cửa sổ không bao giờ sinh ra hai sự kiện.
Đổi lại, bạn phải quyết định khi nào đóng một cửa sổ. Sự kiện đến sau khi cửa sổ đã gửi phải vào một cửa sổ mới, không được sửa cửa sổ cũ, nếu không bạn sẽ tự phá cơ chế chống trùng của chính mình.
Đối soát phải xong trước khi hoá đơn bị khoá
Lỗi thứ ba khó thấy nhất vì không có gì báo hỏng ngay. Stripe xử lý meter event bất đồng bộ, nên tổng usage trong meter summary và trên hoá đơn sắp tới có thể chưa tính những sự kiện vừa gửi. Sự kiện không hợp lệ cũng chỉ được báo sau, qua các Event lỗi mà bạn phải lắng nghe, sửa rồi gửi lại.
Thời gian để làm những việc đó có hạn. Mặc định mỗi hoá đơn Stripe có 1 giờ ân hạn trước khi chốt, chỉnh được tối đa 72 giờ, và trong khoảng này bạn vẫn báo được usage cho kỳ trước. Usage đến sau khi chốt vẫn hiện trong meter summary nhưng không được cộng vào hoá đơn đã chốt, cũng không vào hoá đơn kế tiếp.
Đó chính là tình huống dẫn tới khiếu nại: dashboard một con số, hoá đơn một con số khác. Lago cũng nhận xét rằng sự kiện đến trễ làm hỏng việc đối soát. Vì thế đối soát cần chạy theo lịch cố định, không đợi khách hỏi mới làm.
Lịch tối thiểu có bốn bước. Bước một, mỗi ngày so tổng của sổ cái nội bộ với meter summary, tách theo từng khách và từng loại token. Bước hai, với mỗi khoản chênh, truy tới từng identifier để biết sự kiện đó chưa gửi, bị lỗi hay đang chờ xử lý.
Bước ba, đọc các Event lỗi Stripe trả về, sửa sự kiện hỏng và gửi lại với đúng identifier cũ. Bước bốn, khi kỳ kết thúc, chạy lại phép so sánh ngay trong khoảng ân hạn và gửi bù phần còn thiếu trước khi hoá đơn khoá.
| Triệu chứng khi đối soát | Nguyên nhân thường gặp | Việc cần làm |
|---|---|---|
| Sổ cái cao hơn meter, lệch đều ở các request có cache | Chỉ đọc input_tokens |
Sửa chuẩn hoá, gửi bù trong kỳ |
| Meter cao hơn sổ cái | Retry sinh identifier mới | Chuyển sang identifier tất định |
| Lệch vài sự kiện, rải rác | Lỗi bất đồng bộ hoặc timestamp ngoài khoảng cho phép | Đọc Event lỗi, sửa và gửi lại |
| Lệch dồn vào cuối kỳ | Gửi sau khi hoá đơn đã chốt | Nới ân hạn, chạy đối soát sớm hơn |
Những lỗi FDE dễ mắc
Lỗi dễ mắc nhất là tin input_tokens là tổng, vì cái tên gợi ý như vậy. Lỗi kế tiếp là dùng timestamp lúc gửi thay vì lúc gọi model, khiến những lần gọi ngay trước giờ chốt kỳ bị ghi sang kỳ sau. Lỗi còn lại là để billing là nơi duy nhất lưu usage, nên khi khách hỏi bạn không có gì để so.
Có một lỗi nằm ở phía con người: không nói trước với khách cách bạn đếm. Một trang ngắn mô tả các loại token, cách tính cache và giờ chốt kỳ cho khách đủ thông tin để tự so log của họ với hoá đơn, trước khi phải viết email hỏi bạn.
Nếu tin tuyển dụng nhắc tới usage-based billing hay metering, hãy đưa vào CV một dòng cụ thể như “thiết kế pipeline metering có chống trùng và đối soát hằng ngày”. Khi phỏng vấn, kể lại cách bạn truy một khoản chênh tới tận từng sự kiện.
Bài tập trong tuần
Dựng một sổ cái giả lập với 1.000 lần gọi model, trong đó một phần có cache read. Cố ý gây ra ba lỗi: chỉ đếm input_tokens, cho 5% request retry với identifier ngẫu nhiên, và để vài sự kiện đến sau giờ chốt kỳ. Sau đó viết phép đối soát và xem nó có chỉ ra đủ cả ba không.
Nếu phép đối soát tìm ra cả ba lỗi trên dữ liệu giả, bạn đã sẵn sàng hơn cho lần tới có khách gửi file CSV kèm một câu hỏi.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!