Bốn khái niệm LLM giải thích vì sao model bịa ra một điều khoản
Thêm câu “đừng bịa” đôi khi có tác dụng, nhưng chỉ khi hiểu model đã thấy gì và chọn chữ ra sao, bạn mới biết vì sao.
Tóm tắt nhanh
- LLM sinh lần lượt từng token dựa trên prompt và những gì nó vừa viết ra. Nó không tra cứu sự thật.
- Mọi thứ trong request đều chiếm chỗ trong context window, và context dài hơn có thể làm model kém chính xác hơn (context rot).
- Model bịa một phần vì quá trình huấn luyện và đánh giá thưởng cho việc đoán hơn là thừa nhận không chắc, nên phải thiết kế hệ thống để “không biết” trở thành câu trả lời hợp lệ.
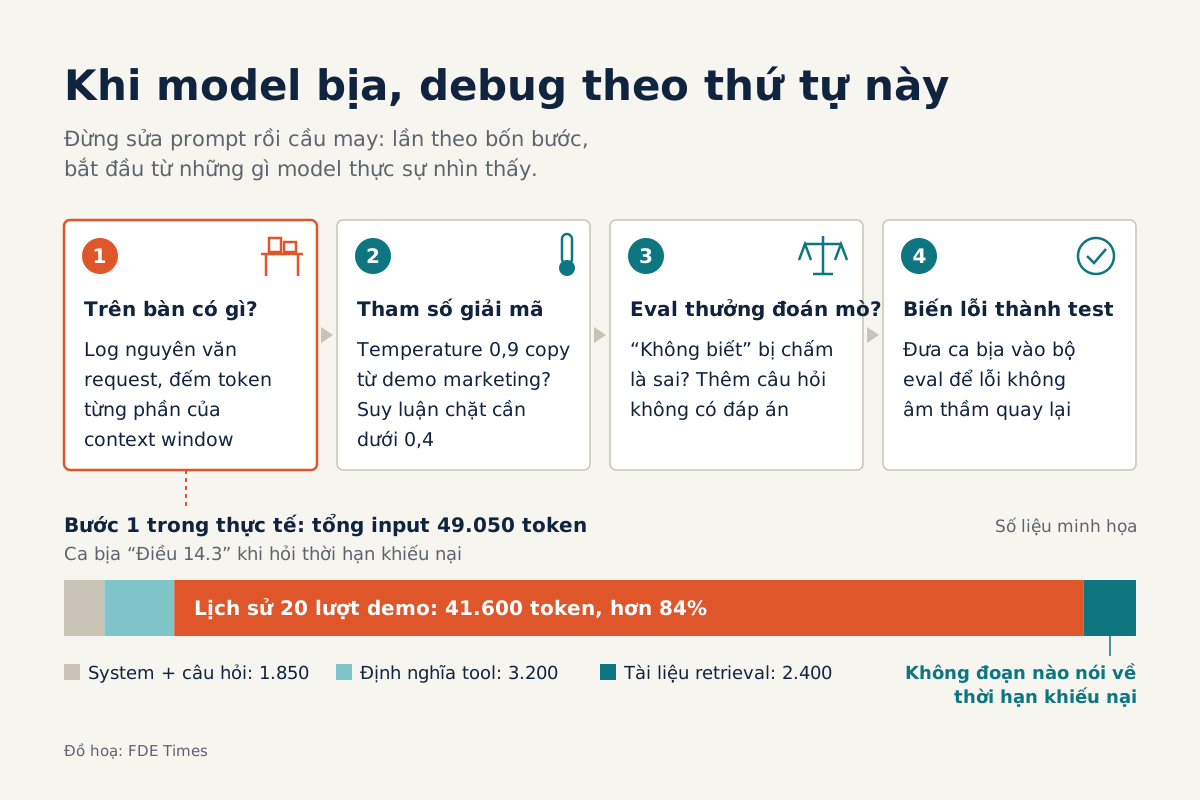
Thử hình dung buổi demo thứ ba ở một công ty bảo hiểm. Trưởng phòng pháp chế hỏi trợ lý nội bộ về thời hạn khiếu nại, và model trả lời rất trôi chảy, có trích hẳn “Điều 14.3”. Trong bộ tài liệu khách hàng đưa không hề có Điều 14.3.
Lúc đó phản xạ của nhiều kỹ sư là sửa prompt thêm câu “đừng bịa” rồi chạy lại. Đôi khi cách này có tác dụng, nhưng bạn không biết tại sao nó có tác dụng, nên tuần sau lỗi quay lại thì bạn cũng không biết đường mà lần.
Một FDE cần trả lời được câu hỏi khó hơn: model đã nhìn thấy những gì, nó được cấu hình để chọn chữ ra sao, và vì sao nó chọn đoán thay vì nói “không biết”.
Bốn khái niệm token, context window, temperature và hallucination là bộ công cụ để chẩn đoán lỗi đó. Bài này giải thích từng khái niệm theo đúng thứ tự bạn sẽ dùng khi debug ở chỗ khách hàng.
Model không tra cứu, nó viết tiếp
Tài liệu Transformers của Hugging Face mô tả LLM như sau: model được huấn luyện để sinh token tiếp theo, dựa trên đoạn văn ban đầu (prompt) cùng với những gì chính nó vừa sinh ra.
Phải nắm điều này trước tiên vì “Điều 14.3” không được lấy ra từ một cơ sở dữ liệu nào cả. Model viết “Điều”, rồi thấy sau chữ “Điều” thường là một con số, rồi một dấu chấm, rồi thêm một con số nữa. Với model, chuỗi đó nghe rất hợp lý, còn đúng hay sai là chuyện nó không kiểm tra.
Cách model chọn token tiếp theo là một tham số bạn điều khiển được. Mặc định của hàm generate() trong Transformers là greedy search, tức là luôn chọn token có xác suất cao nhất. Cách này hợp với các tác vụ cần bám sát đầu vào như dịch hay phiên âm, nhưng lại kém với tác vụ sáng tạo.
Sampling thì cho đầu ra đa dạng hơn, và temperature quyết định token được chọn khó đoán tới mức nào.
Hugging Face gợi ý temperature trên 0,8 cho tác vụ sáng tạo và dưới 0,4 cho tác vụ cần suy luận chặt. Lưu ý là temperature chỉ có tác dụng khi bật sampling. Một trợ lý tra cứu chính sách mà chạy ở temperature cao là đang nhận thêm rủi ro mà chẳng được lợi gì.
Context window là cái bàn làm việc, không phải thư viện
Tài liệu Claude API định nghĩa context window là toàn bộ văn bản model có thể tham chiếu khi sinh câu trả lời, tính cả chính câu trả lời. Đây là bộ nhớ làm việc, khác hẳn dữ liệu huấn luyện. Những gì không có trên cái bàn này thì model chỉ còn cách nhớ mang máng từ lúc được huấn luyện, hoặc đoán.
Chỗ người mới hay đánh giá thấp là trên bàn có những gì. Theo cùng tài liệu đó, mọi thứ trong request đều chiếm chỗ: system prompt, từng tin nhắn trong messages (kể cả kết quả tool, hình ảnh, tài liệu), các định nghĩa tool, và output của model.
Trong hội thoại nhiều lượt, output của lượt trước trở thành input của lượt sau, nên lịch sử cứ dày dần cho tới khi chạm giới hạn.
Khi đó, phản xạ nhét thêm tài liệu cho chắc lại phản tác dụng. Tài liệu Claude ghi rõ: số token càng tăng thì độ chính xác và khả năng nhớ lại càng giảm, hiện tượng này gọi là context rot. Context lớn hơn không tự động cho kết quả tốt hơn, nên việc chọn đưa gì vào là một quyết định kỹ thuật thật sự.
Mổ xẻ ca “Điều 14.3”
Quay lại công ty bảo hiểm. Bước đầu tiên là log nguyên văn request đã gửi đi, chứ không chỉ log câu hỏi của người dùng. Sau đó đếm token cho từng phần bằng token counting API, thứ mà tài liệu Claude khuyên dùng để ước lượng trước khi gửi.
Mẹo là đếm nhiều lần, mỗi lần thêm một thành phần, rồi lấy hiệu số để biết từng phần chiếm bao nhiêu:
import anthropic
client = anthropic.Anthropic()

MODEL = "TEN_MODEL_DU_AN"  # thay bằng model dự án đang dùng

def dem(messages, tools=None):
    kw = dict(model=MODEL, system=SYSTEM, messages=messages)
    if tools:
        kw["tools"] = tools
    return client.messages.count_tokens(**kw).input_tokens

hoi = {"role": "user", "content": QUESTION}
hoi_kem_tai_lieu = {"role": "user", "content": DOCS + QUESTION}

nen        = dem([hoi])
co_tool    = dem([hoi], TOOLS)
co_lich_su = dem(HISTORY + [hoi], TOOLS)
day_du     = dem(HISTORY + [hoi_kem_tai_lieu], TOOLS)

print("system + câu hỏi:", nen)
print("định nghĩa tool: ", co_tool - nen)
print("lịch sử hội thoại:", co_lich_su - co_tool)
print("tài liệu retrieval:", day_du - co_lich_su)
print("tổng input:      ", day_du)
Giả sử với ca này, output trông như sau (số liệu minh họa):
system + câu hỏi:  1850
định nghĩa tool:   3200
lịch sử hội thoại: 41600
tài liệu retrieval: 2400
tổng input:        49050
Đọc bảng này: lịch sử của hai mươi lượt demo trước chiếm 41.600 trên tổng 49.050 token, tức hơn 84% ngân sách. Ba đoạn tài liệu do bước retrieval lấy về chỉ chiếm 2.400 token, và khi mở ra đọc thì không đoạn nào nói về thời hạn khiếu nại.
Như vậy là đã có hai nghi phạm: thông tin cần thiết không hề nằm trên bàn, trong khi phần lớn chỗ trên bàn lại bị lịch sử không liên quan chiếm mất.
Tiếp theo, mở file cấu hình ra xem. Nếu trợ lý đang chạy temperature 0,9 vì ai đó copy từ demo viết email marketing, thì đó là nghi phạm thứ ba. Ba lỗi này sửa được bằng kỹ thuật thông thường: cắt bớt lịch sử, sửa retrieval và hạ temperature.
Nhưng kể cả khi đã sửa cả ba, vẫn còn một câu hỏi: vì sao model không nói luôn là tài liệu không có thông tin này?
Vì sao model thích đoán hơn là nói “không biết”
Bài nghiên cứu “Why Language Models Hallucinate” của Kalai, Nachum, Vempala và Zhang đưa ra câu trả lời khá thẳng. Theo các tác giả, quy trình huấn luyện và đánh giá đang thưởng cho việc đoán, chứ không thưởng cho việc thừa nhận không chắc chắn.
Model được tối ưu để trở thành một thí sinh đi thi giỏi, mà khi đi thi thì đoán bừa lúc không chắc vẫn có lợi cho điểm số.
Họ cũng cho rằng hallucination chẳng có gì bí ẩn: nó bắt nguồn từ những lỗi phân loại nhị phân bình thường, tức là phân biệt sai một phát biểu đúng với một phát biểu sai. Từ đó, việc của FDE ở chỗ khách hàng trở nên khá rõ ràng.
Nếu bộ eval của bạn chỉ chấm “trả lời đúng” và coi “không biết” là sai, thì chính bạn đang lặp lại động cơ khiến model đoán.
Cách làm hợp lý là biến “không có trong tài liệu” thành một câu trả lời hợp lệ ở cả hai đầu. Trong prompt, nói rõ model được phép từ chối và phải nêu điều khoản nào nó đang dựa vào. Trong eval, đưa vào những câu hỏi cố tình không có đáp án, rồi chấm điểm cao cho câu từ chối đúng lúc.
Những sai lầm hay gặp
Sai lầm phổ biến nhất là coi context window như ổ cứng, cứ nhét càng nhiều càng tốt, trong khi nó là bộ nhớ làm việc và sẽ kém đi khi bị nhồi quá đầy. Sai lầm thứ hai là quên rằng định nghĩa tool và output cũng chiếm chỗ, nên request chạy ổn lúc demo ba lượt nhưng vỡ khi người dùng thật chat tới lượt ba mươi.
Sai lầm thứ ba là chỉnh temperature theo cảm tính hoặc copy từ một dự án khác. Sai lầm thứ tư khó thấy hơn cả: xây bộ eval chỉ đếm câu đúng, nên nó không bắt được, cũng không ngăn được, những câu trả lời tự tin nhưng bịa.
Cả bốn sai lầm đều tránh được nếu bạn debug theo thứ tự trong sơ đồ trong bài: xem trên bàn có gì trước, tham số giải mã sau, cách hệ thống thưởng cho việc đoán sau cùng, rồi biến lỗi thành test case để lỗi không âm thầm quay lại.
Quy trình đó, chứ không phải dòng “thành thạo prompt engineering”, mới là thứ nên vào CV, chẳng hạn “giảm tỉ lệ trả lời bịa bằng eval có câu hỏi không có đáp án và ngân sách token theo từng thành phần”.
Khách hàng sẽ không nhớ bạn đã giải thích token là gì. Họ sẽ nhớ lần trợ lý của họ trả lời “tài liệu hiện có không quy định thời hạn này” thay vì bịa ra Điều 14.3, và lần đó mới là lúc họ bắt đầu tin hệ thống.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!