Đưa phần mềm vào máy chủ của khách mà vẫn thấy được nó chạy
Ở full VPC hay on-prem, bạn không giữ cluster lẫn dữ liệu, nên tín hiệu chẩn đoán phải được thiết kế từ ngày đầu.
Tóm tắt nhanh
- FDE hạ tầng ở Reducto lo trọn việc đưa phần mềm vào môi trường của khách, từ khâu lên kế hoạch, cấu hình, kiểm thử đến rollout.
- Telemetry chỉ gồm metadata như job ID, trạng thái, thời lượng và nhóm lỗi đã làm sạch, nên mã lỗi phải đủ cụ thể ngay từ đầu.
- Upgrade có điều kiện chặn, còn bản air-gapped chỉ gửi tín hiệu ra ngoài khi có người tạo support bundle.
Hợp đồng đã ký xong. Bên bảo mật của khách chỉ đặt một điều kiện: không tài liệu nào được rời khỏi hạ tầng của họ. Từ giờ, phần mềm của bạn sẽ chạy trên cluster bạn không sở hữu, sau firewall bạn không cấu hình, và khi nó hỏng lúc 2 giờ sáng thì người đầu tiên biết chuyện có khi lại là khách.
Reducto, công ty làm phần mềm xử lý tài liệu, tuyển hẳn một vị trí cho việc này: Forward Deployed Engineer, Infrastructure Specialist. Theo mô tả công việc, người này đưa Reducto vào môi trường của khách và lo trọn từ khâu lên kế hoạch, cấu hình, kiểm thử đến rollout.
Nếu bạn muốn làm FDE ở mảng hạ tầng, đây là kỹ năng nên luyện trước tiên. Chạy được trên máy mình mới là phần dễ. Cái khó là chạy được trên máy của người khác, và vẫn biết nó đang khỏe hay ốm.
Ai giữ dữ liệu, ai giữ compute?
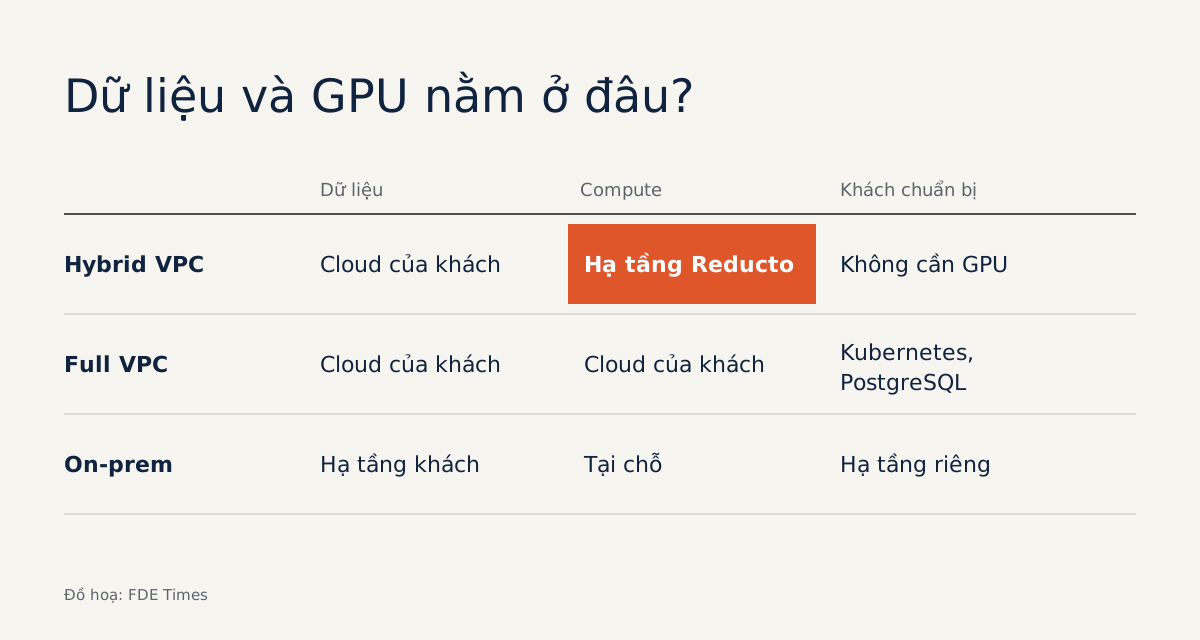
Trước khi gõ lệnh nào, bạn cần biết khách đang mua mô hình nào, vì câu trả lời quyết định ai giữ dữ liệu, ai chạy compute và bạn sẽ debug ở đâu. Reducto có ba mô hình triển khai, trong đó VPC và on-premise chỉ dành cho khách Enterprise. Hai kiểu mà FDE hạ tầng hay gặp nhất khác nhau như sau.
| Hybrid VPC | Full VPC / on-prem | |
|---|---|---|
| Dữ liệu và storage | Ở lại trong tài khoản cloud của khách | Trong môi trường của khách |
| Compute | Reducto quản lý toàn bộ, bằng worker tạm thời dành riêng cho một tenant, không lưu gì ngoài bộ nhớ | Chạy bên trong môi trường của khách |
| Bạn thấy được gì | Bản ghi job trong database của Reducto: trạng thái, thiết lập request, nơi lưu kết quả | Chỉ những gì khách cho phép, vì khách nắm quyền truy cập observability và egress |
| Khách kiểm soát | Tài khoản cloud và storage nhận kết quả | Mạng, truy cập API, chính sách Kubernetes, chính sách storage, observability, egress |
Dòng cuối của bảng cho thấy quyền kiểm soát của khách lớn dần thế nào, và cột full VPC/on-prem là ca khó nhất. Với hybrid VPC, kết quả được ghi về storage của khách nhưng bạn vẫn còn bản ghi job để tra trạng thái. Với full VPC hay on-prem, ngay cả quyền nhìn vào hệ thống cũng là thứ phải xin.
Vì thế, câu nên hỏi trong buổi kickoff không chỉ là dữ liệu nằm ở đâu, mà còn là ai cấp cho bạn quyền xem log và metric, và tín hiệu được phép đi ra bằng đường nào.
Thấy được hệ thống mà không chạm vào tài liệu
Chính sách bảo mật của Reducto vạch một ranh giới rõ: telemetry là observability chỉ gồm metadata, không phải một đường ống dữ liệu. Nó có thể chứa job ID, số đếm, trạng thái, thời lượng, nhóm lỗi đã được làm sạch và các metadata khác phục vụ debug.
Trách nhiệm cũng được chia rạch ròi. Reducto lo bảo mật ứng dụng và quyền truy cập ở cấp tenant; khách lo việc mở mạng ra ngoài, phân quyền người gọi, kiểm soát egress, gia cố Kubernetes, cùng việc định tuyến và lưu giữ telemetry. Nói cách khác, telemetry của bạn đi đâu và sống bao lâu là quyết định của khách.
Thử hình dung một sự kiện telemetry bạn có thể thiết kế cho một job xử lý tài liệu. Ví dụ dưới đây là giả định, không phải schema của Reducto:
{
  "event": "job_completed",
  "job_id": "j_8f2c",
  "pages": 42,
  "file_type": "pdf",
  "duration_ms": 18350,
  "worker": "cpu-3",
  "status": "partial",
  "error_code": "TABLE_PARSE_TIMEOUT"
}
Không có tên file, không có đoạn chữ nào trích từ tài liệu. Vậy mà khi khách báo “file hợp đồng hôm qua ra kết quả thiếu”, bạn vẫn lọc được các job partial, thấy chúng đều quá 40 trang và cùng dính một mã lỗi timeout. Từ đó bạn có giả thuyết để kiểm tra trên dữ liệu thử của chính mình.
Bài học ở đây là nhóm lỗi phải đủ cụ thể. Một trường error: "failed" chung chung buộc bạn phải xin khách gửi tài liệu, và đó chính là thứ hợp đồng cấm.
Một lần upgrade, làm từng bước
Lần cài đầu chỉ là khởi đầu, vì bản on-prem còn phải nâng cấp nhiều lần sau đó. Changelog on-prem của Reducto, bản v1.12.6, ghi rằng Helm đòi có Redis cùng các worker io/cpu khỏe mạnh, trên v1.12.6 trở lên, rồi mới cho phép upgrade.
Câu này đọc được theo hai cách: hoặc worker phải chạy image từ v1.12.6, hoặc cơ chế chặn chỉ có từ chart v1.12.6 trở đi. Vì vậy, đừng mã hóa cứng một cách hiểu vào script. Hãy hỏi vendor, và để phần kiểm tra phiên bản ở dạng tùy chọn.
Điều kiện chặn này bảo vệ bạn, nhưng nó cũng có thể khiến upgrade dừng lại ngay giữa buổi bảo trì mà khách đã đặt lịch. Nên tự chạy kiểm tra trước khi Helm kịp từ chối. Script dưới đây minh họa ý tưởng; tên namespace, label, tên deployment và việc tag image chứa số phiên bản đều là giả định:
#!/usr/bin/env bash
set -euo pipefail
NS="${1:-reducto}"
CHECK_VERSION="${CHECK_VERSION:-0}"   # bật =1 khi đã xác nhận với vendor
MIN="1.12.6"

echo "== Redis =="
redis_ready=$(kubectl -n "$NS" get pods -l app=redis \
  -o jsonpath='{.items[*].status.containerStatuses[*].ready}')
[[ -n "$redis_ready" && "$redis_ready" != *false* ]] \
  || { echo "Redis chưa có hoặc chưa sẵn sàng"; exit 1; }

for role in io cpu; do
  echo "== worker $role =="
  d="worker-$role"
  ready=$(kubectl -n "$NS" get deploy "$d" -o jsonpath='{.status.readyReplicas}')
  want=$(kubectl -n "$NS" get deploy "$d" -o jsonpath='{.spec.replicas}')
  [ "${ready:-0}" = "$want" ] \
    || { echo "$d chưa sẵn sàng: ${ready:-0}/$want"; exit 1; }

  if [ "$CHECK_VERSION" = "1" ]; then
    image=$(kubectl -n "$NS" get deploy "$d" \
      -o jsonpath='{.spec.template.spec.containers[0].image}')
    ver="${image##*:}"; ver="${ver#v}"
    lowest=$(printf '%s\n%s\n' "$MIN" "$ver" | sort -V | head -n1)
    [ "$lowest" = "$MIN" ] \
      || { echo "$d đang ở $ver, thấp hơn $MIN"; exit 1; }
  fi
done

echo "Preflight OK, có thể chạy helm upgrade"
Mặc định, script dừng khi Redis không có pod nào hoặc có container chưa ready, hay khi worker thiếu replica. Chạy với CHECK_VERSION=1 thì nó còn so phiên bản tag image của worker với v1.12.6. Nó không thay thế phép kiểm tra của chính Helm, và nếu khách dùng tag kiểu latest hay digest thì bạn phải đọc phiên bản theo cách khác.
Giá trị của script còn nằm ở chỗ khách tự chạy được nó. Nếu khách không cấp kubeconfig cho bạn, một công cụ chẩn đoán gói gọn trong một lệnh, in ra kết quả dễ đọc, sẽ thay cho quyền truy cập mà bạn không có.
Khi cluster không có đường ra internet
Honeycomb chia việc này thành hai mô hình: vendor tự vận hành nền tảng, hoặc khách tự quản lý toàn bộ hạ tầng. Mô hình thứ hai hợp với môi trường air-gapped, và ở đó mọi tín hiệu bạn mặc định sẽ “tự gửi về” đều phải đi đường khác.
Replicated giải bài này bằng cách thu telemetry của bản air-gapped và lưu ngay trong một Kubernetes Secret ở môi trường của khách. Dữ liệu đó chỉ đến tay vendor khi có người tạo support bundle trong môi trường, và kho lưu tại chỗ có giới hạn dung lượng.
Hệ quả rất thực tế: nếu khách mấy tháng mới tạo support bundle một lần, phần tín hiệu cũ có thể đã bị đẩy ra khỏi kho. Với mỗi luồng như usage, log hay bản vá, hãy hỏi khách ngay từ đầu nó đi ra thế nào, ai mang ra và bao lâu một lần.
Tự làm: năm việc trước ngày rollout
Việc đầu tiên là xác định mô hình với khách bằng ba câu hỏi: dữ liệu nằm ở đâu, compute chạy ở đâu, và cluster có đường ra internet không. Ghi câu trả lời vào tài liệu kickoff, có chữ ký của bên bảo mật.
Tiếp theo, lập bảng xem phía khách ai phụ trách từng việc: mở mạng ra ngoài, egress, chính sách Kubernetes, quyền truy cập observability, định tuyến và lưu giữ telemetry. Mỗi dòng cần một tên người cụ thể.
Sau đó, thống nhất danh sách trường telemetry bằng văn bản, sao cho đội bảo mật duyệt được từng trường. Rồi viết preflight cho mọi thao tác upgrade và cho khách chạy thử trên staging. Cuối cùng, viết runbook sự cố giả định rằng bạn không có quyền truy cập: khách chạy lệnh gì, gửi lại cho bạn kết quả gì.
Những lỗi khiến dự án trễ cả tháng
Lỗi phổ biến nhất là coi môi trường của khách giống môi trường dev của mình. Bạn có thể gặp registry nội bộ, proxy, chính sách mạng và quy trình phê duyệt thay đổi mà tài liệu của vendor không nói tới.
Lỗi tiếp theo là để telemetry thành chuyện tính sau. Vì khách nắm việc định tuyến telemetry, thêm một trường log khi sự cố đầu tiên xảy ra có khi phải qua thêm một vòng duyệt bảo mật. Ngược lại là log quá tay: chỉ một dòng in nội dung tài liệu ra stdout cũng đủ phá vỡ lời hứa metadata-only mà cả hợp đồng dựa vào.
Lỗi cuối cùng là coi upgrade như một lệnh. Thực ra nó là một buổi làm việc có lịch hẹn, có điều kiện tiên quyết và có đường rollback. Nếu bạn chưa thử rollback trên staging thì bạn chưa có đường rollback.
Cách chứng minh kỹ năng này khi đi xin việc
Khi đọc tin tuyển dụng FDE, hãy để ý những cụm như “customer environments”, “on-prem”, “VPC” hay “air-gapped”.
Trong CV, đừng viết “có kinh nghiệm Kubernetes”. Hãy viết một dòng kiểu: đã triển khai và nâng cấp một hệ thống trên cluster do khách vận hành, kèm công cụ chẩn đoán mà người vận hành phía khách tự chạy được.
Nếu chưa có dự án thật, một repo có Helm chart, script preflight và schema telemetry chỉ gồm metadata là bằng chứng mà người phỏng vấn đọc được trong năm phút.
Cluster của khách sẽ không bao giờ là của bạn. Bạn vẫn làm tốt được việc của mình nếu thiết kế để nhìn thấy nó ngay từ ngày đầu.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
8 nguồn
- Forward Deployed Engineer, Infrastructure Specialist
- On-prem changelog (Reducto docs) · 2026-08-18
- Hybrid VPC deployment (Reducto docs)
- Enterprise deployment options (Reducto docs)
- Security model (Reducto docs)
- Enterprise readiness (Reducto docs)
- Telemetry for air gap instances (Replicated docs)
- Deployment models (Honeycomb docs)