Multi-tenancy cho giải pháp AI: chặn rò dữ liệu giữa khách ở bốn lớp
Khi một hệ thống RAG phục vụ nhiều khách hàng, chỉ cần quên một mệnh đề WHERE là tài liệu của khách này có thể lọt vào câu trả lời cho khách khác. Muốn chặn được, ranh giới phải nằm sẵn trong database, vector store và khoá mã hoá.
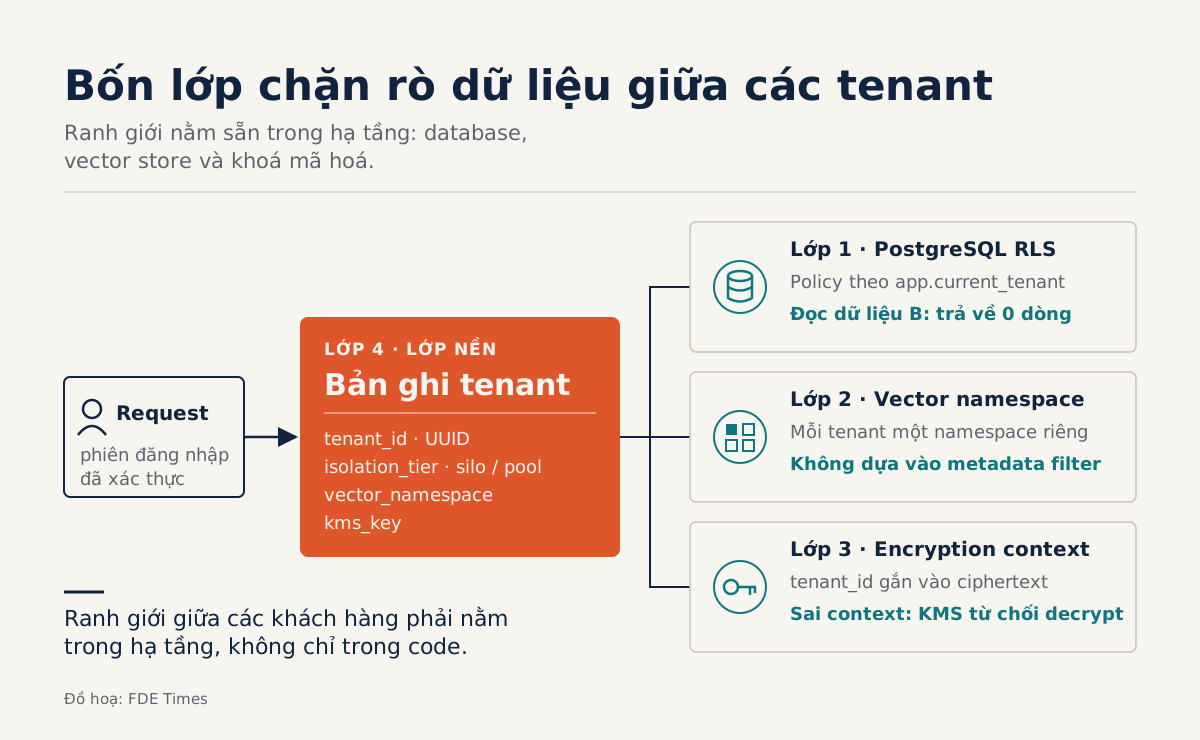
Tóm tắt nhanh
- Rò dữ liệu giữa các tenant có thể là sự cố không gượng dậy được, nên cách ly phải nằm ở hạ tầng chứ không chỉ trong code ứng dụng.
- Hệ thống RAG có ba mô hình: silo cách ly mạnh nhất và tốn kém nhất, pool dùng chung toàn bộ, bridge nằm giữa hai mô hình kia.
- Bốn lớp cần làm: RLS trong Postgres, mỗi tenant một namespace trong vector store, KMS encryption context theo tenant, và mỗi tenant một bản ghi cấu hình tra từ một nguồn duy nhất.
Thứ Sáu, demo trợ lý tài liệu nội bộ. Người dùng bên khách hàng A hỏi về chính sách hoàn tiền, và câu trả lời trích nguyên một đoạn hợp đồng của khách hàng B. Chẳng có ai tấn công hệ thống cả. Chỉ là có một câu query thiếu điều kiện tenant_id.
Các FDE làm giải pháp AI sớm muộn cũng sẽ gặp tình huống này. Khi một nền tảng phục vụ nhiều khách cùng lúc, mỗi khách đều có tài liệu, khoá mã hoá và cấu hình của riêng mình.
Whitepaper của AWS về chiến lược cách ly tenant định nghĩa yêu cầu rất gọn: kể cả khi chạy chung một môi trường, tài nguyên của tenant này không được để tenant khác truy cập. Theo AWS, chỉ cần ranh giới đó bị vượt qua một lần, dù theo cách nào, cũng có thể là sự cố mà doanh nghiệp SaaS không gượng dậy được.
Vì vậy cách ly tenant phải được quyết định ngay từ thiết kế ban đầu, không để dành cho sprint cuối. Bài này đi qua bốn lớp phải khoá: dữ liệu quan hệ, vector, khoá mã hoá và cấu hình. Tất cả gắn với một ví dụ chạy được.
Silo, bridge hay pool: chọn mô hình nào?
AWS nói thẳng rằng không có chiến lược nào dùng được cho mọi trường hợp. Cách làm phụ thuộc vào domain, yêu cầu compliance, mô hình triển khai và các dịch vụ bạn chọn. Với RAG trên Amazon Bedrock Knowledge Bases, AWS mô tả ba mô hình, và bảng dưới đây xếp chúng theo mức độ cách ly.
| Silo | Bridge | Pool | |
|---|---|---|---|
| Phần riêng cho mỗi tenant | Knowledge base, S3 bucket, OpenSearch Serverless collection | Chỉ knowledge base | Không có, toàn bộ kiến trúc dùng chung |
| Khoá KMS theo tenant | Làm được, vì mỗi tenant có bucket riêng | Không mã hoá đầu-cuối theo tenant được | Dùng chung một khoá |
| Cách lọc khi truy vấn | Tách sẵn về mặt hạ tầng | Theo knowledge base | Dựa vào trường metadata tenant |
| Hợp với | Khách có yêu cầu cách ly cao nhất, chấp nhận chi phí cao nhất | Trường hợp cần cân bằng | Rất nhiều tenant nhỏ |
Thử hình dung bạn triển khai cho một nền tảng có một khách là ngân hàng và vài chục cửa hàng bán lẻ nhỏ. Ngân hàng gần như chắc chắn sẽ đòi khoá mã hoá riêng, nên chỉ có silo đáp ứng được.
Các cửa hàng nhỏ đi theo pool là hợp lý. Một nền tảng hoàn toàn có thể chạy cả hai mô hình, miễn là mỗi tenant được gắn rõ thuộc tầng cách ly nào.
Lớp một: để PostgreSQL tự chặn
Khi dữ liệu quan hệ được dùng chung trong một database, hướng dẫn của AWS ghi rằng row-level security (RLS) là bắt buộc để giữ cách ly giữa các tenant.
RLS dời việc kiểm soát từ hàng trăm câu query trong code ứng dụng về một chỗ duy nhất là database. Cách AWS khuyến nghị là để ứng dụng đặt một biến ngữ cảnh tenant lúc runtime, thay vì tạo cho mỗi tenant một user database riêng.
ALTER TABLE documents ENABLE ROW LEVEL SECURITY;
ALTER TABLE documents FORCE ROW LEVEL SECURITY;

CREATE POLICY tenant_isolation ON documents
  USING (tenant_id = current_setting('app.current_tenant')::uuid);
Phía ứng dụng, mọi truy vấn đều phải đi qua một hàm duy nhất:
def query_as_tenant(conn, tenant_id, sql, params):
    with conn.transaction():
        conn.execute(
            "SELECT set_config('app.current_tenant', %s, true)",
            (str(tenant_id),),
        )
        return conn.execute(sql, params).fetchall()
Tham số true khiến giá trị chỉ có hiệu lực trong transaction hiện tại. Nếu đặt ở mức session trong một connection pool, request kế tiếp có thể nhận lại kết nối mà vẫn còn tenant của request trước. Đó là một kiểu rò dữ liệu rất khó phát hiện khi test.
Vì sao cần thêm dòng FORCE? Tài liệu PostgreSQL ghi rằng superuser và các role có thuộc tính BYPASSRLS luôn bỏ qua RLS. Chủ sở hữu bảng cũng bỏ qua RLS, trừ khi bảng được bật FORCE ROW LEVEL SECURITY.
Ngược lại, nếu bảng đã bật RLS mà chưa có policy nào, PostgreSQL mặc định chặn hết: không dòng nào hiện ra và không dòng nào sửa được. Tức là khi cấu hình thiếu, hệ thống trả về rỗng chứ không trả nhầm dữ liệu.
Lớp hai: mỗi tenant một namespace
Trong vector store, lỗi hay gặp nhất là gắn tenant_id làm metadata rồi lọc lúc query. Tài liệu của Pinecone khuyên dùng mỗi tenant một namespace. Lý do là mỗi namespace được lưu tách riêng, nên dữ liệu giữa các tenant được cách ly về mặt vật lý.
Còn khi chỉ lọc bằng metadata, Pinecone lưu ý rằng query vẫn quét toàn bộ namespace bất kể bộ lọc là gì. Cách này vừa yếu hơn vừa tốn hơn.
Nghe thì có vẻ ngược với bảng ở trên, nơi mô hình pool của Bedrock dựa đúng vào trường metadata tenant. Thật ra đó là hai lựa chọn khác nhau: pool trên Bedrock Knowledge Bases dùng chung toàn bộ kiến trúc, nên bộ lọc metadata là thứ duy nhất còn lại để tách tenant.
Pinecone thì cho bạn thêm một lựa chọn là namespace. Nếu vector store của bạn có cơ chế này, nên giữ pool cho phần còn lại như pipeline và khoá KMS dùng chung, nhưng vẫn cho mỗi tenant nhỏ một namespace riêng thay vì chỉ trông vào bộ lọc.
results = index.query(
    vector=embedding,
    top_k=5,
    namespace=tenant_cfg["vector_namespace"],
)
Chi tiết đáng chú ý là namespace không được lấy từ input của người dùng. Nó phải lấy từ cấu hình tenant, mà cấu hình này được tra từ phiên đăng nhập đã xác thực. Nếu namespace đi theo tham số trên URL thì phần cách ly vật lý phía dưới không còn tác dụng gì.
Lớp ba: gắn tenant vào khoá mã hoá
Ngay cả khi buộc phải dùng chung một khoá KMS, bạn vẫn kéo được ranh giới tenant vào tầng mật mã nhờ encryption context. Đây là các cặp key-value không bí mật, được AWS KMS gắn chặt về mặt mật mã vào ciphertext.
Muốn giải mã, bạn phải đưa đúng encryption context đó. Encryption context còn dùng được làm điều kiện trong key policy và grant để giới hạn quyền theo từng tenant.
dk = kms.generate_data_key(
    KeyId=tenant_cfg["kms_key"],
    KeySpec="AES_256",
    EncryptionContext={"tenant_id": tenant_cfg["tenant_id"]},
)
Nếu code của tenant B lấy blob của tenant A rồi gọi decrypt với context tenant_id của B, KMS sẽ từ chối. Encryption context cũng được ghi vào CloudTrail, nên bạn có sẵn nhật ký dùng khoá cho từng tenant để đưa cho đội audit của khách.
Tuy nhiên, chính vì encryption context bị ghi vào log, AWS yêu cầu không đưa thông tin nhạy cảm vào đó. Hãy dùng một mã UUID không mang nghĩa, đừng dùng tên khách hàng hay mã số thuế.
Lớp bốn: cấu hình là nơi mọi thứ hội tụ
Ba lớp trên chỉ chắc chắn khi có một nguồn duy nhất trả lời câu hỏi “tenant này dùng gì”. Nên có một bản ghi cấu hình cho mỗi tenant, và request nào vào hệ thống cũng phải tra bản ghi này trước, rồi mọi thứ phía sau đọc từ đó. Với ví dụ ngân hàng và cửa hàng ở trên, hai bản ghi có thể trông như sau:
- tenant_id: 8f1c2e4a-5b7d-4c21-9a3e-0d6f7b2c1a90
  isolation_tier: silo
  vector_namespace: ns-8f1c2e4a
  kms_key: alias/tenant-8f1c2e4a
  model: <model của khách>
  system_prompt: prompts/8f1c2e4a.md
  limits: { requests_per_minute: 60 }

- tenant_id: 3a9d7c10-2e4f-4b88-b1c5-7e0a9f6d2b34
  isolation_tier: pool
  vector_namespace: ns-3a9d7c10
  kms_key: alias/pool-shared
  model: <model mặc định>
  system_prompt: prompts/default.md
  limits: { requests_per_minute: 20 }
Để ý rằng cả hai đều dùng UUID làm định danh, không có tên khách hàng ở đâu cả, nên giá trị này đưa thẳng vào encryption context được. Tenant pool dùng chung khoá đúng như mô hình pool, nhưng vẫn có namespace riêng theo cách làm ở lớp hai.
Khi đội bảo mật của ngân hàng hỏi “dữ liệu của chúng tôi nằm ở đâu, khoá nào mã hoá”, bạn mở bản ghi của họ ra và chỉ vào từng dòng, thay vì phải đi lục code.
Bản ghi cấu hình cũng là đầu vào cho bộ test cách ly. Test dưới đây đăng nhập bằng tenant A rồi chủ động đọc, tìm kiếm và giải mã dữ liệu của B:
def test_tenant_a_cannot_reach_tenant_b(conn, index, kms, b_doc_ids, b_blob):
    a, b = load_tenant(TENANT_A), load_tenant(TENANT_B)

    # Đọc: RLS phải trả 0 dòng, kể cả khi hỏi thẳng tenant_id của B
    rows = query_as_tenant(conn, a["tenant_id"],
        "SELECT id FROM documents WHERE tenant_id = %s", (b["tenant_id"],))
    assert rows == []

    # Tìm kiếm: namespace của A không được chứa tài liệu nào của B
    hits = index.query(vector=PROBE_VECTOR, top_k=50,
                       namespace=a["vector_namespace"])
    assert not {m.id for m in hits.matches} & set(b_doc_ids)

    # Giải mã: blob của B với context của A phải bị KMS từ chối
    with pytest.raises(kms.exceptions.InvalidCiphertextException):
        kms.decrypt(CiphertextBlob=b_blob,
                    EncryptionContext={"tenant_id": a["tenant_id"]})
Chạy test này trong CI bằng đúng role mà ứng dụng dùng ở production. Nếu chạy bằng role owner, phần đọc có thể vẫn pass dù RLS chưa bao giờ được áp dụng thật.
Những lỗi làm cách ly mất tác dụng
Lỗi phổ biến nhất là cho ứng dụng kết nối bằng chính role sở hữu bảng hoặc một role có BYPASSRLS. Policy vẫn còn đó nhưng không áp dụng cho role này, nên test vẫn qua hết. Hãy tách riêng role dùng cho migration và role dùng cho ứng dụng.
Lỗi thứ hai là coi metadata filter trong vector store như một cơ chế cách ly. Bộ lọc đó chỉ là một điều kiện trong query, và chỉ cần một đoạn code quên truyền vào là dữ liệu lọt ra.
Lỗi thứ ba là chọn bridge cho tiện rồi mới phát hiện khách đòi mã hoá đầu-cuối bằng khoá riêng. Mô hình bridge không đáp ứng được yêu cầu này, nên hãy hỏi về khoá mã hoá ngay trong buổi discovery đầu tiên.
Lỗi cuối cùng là chỉ test happy path. Bộ test cách ly ở lớp bốn chỉ có giá trị khi nó cố tình làm điều sai: đọc, tìm kiếm và giải mã dữ liệu của tenant khác, rồi khẳng định cả ba thao tác đều thất bại.
Biến kỹ năng này thành lợi thế khi đi phỏng vấn
Khi đọc JD của các vị trí FDE hay solutions engineer, hãy để ý các từ khoá như “multi-tenant”, “data isolation”, “customer-managed keys” hay “compliance”. Gặp những từ này, bạn nên chuẩn bị sẵn một câu chuyện cụ thể về việc mình đã tách dữ liệu, khoá và cấu hình giữa các khách như thế nào.
Trong CV, đừng chỉ ghi “có kinh nghiệm multi-tenancy”. Hãy viết cụ thể: dùng RLS với biến ngữ cảnh tenant đặt theo từng transaction, mỗi tenant một namespace trong vector store, KMS encryption context theo tenant, và test tự động thử đọc chéo giữa các tenant. Một dòng như vậy cho người phỏng vấn thấy bạn hiểu chỗ hệ thống dễ vỡ, không chỉ biết các thuật ngữ.
Lần tới có ai bảo “để sau hẵng tách tenant”, bạn đã biết cái giá của chữ “sau” đó: chỉ cần một đoạn hợp đồng hiện nhầm trong buổi demo là đủ.
6 nguồn
- SaaS Tenant Isolation Strategies: Isolating Resources in a Multi-Tenant Environment (AWS Whitepaper) · 2020-08-01
- Multi-tenant RAG with Amazon Bedrock Knowledge Bases · 2024-12-16
- Implement multitenancy (Pinecone docs)
- Row-level security recommendations - AWS Prescriptive Guidance
- PostgreSQL Documentation: Row Security Policies
- Encryption context - AWS Key Management Service Developer Guide