Ôn thi FDE: DSA chỉ cần đủ, điểm nặng nằm ở vòng decomposition
Databricks ra đề viết một hàm xử lý dictionary trong notebook, OpenAI giao một bài implementation chia nhiều phần, còn Palantir dành 60 phút decomposition cho một đề cố ý thiếu thông tin và không quan tâm bạn có thuộc Dijkstra hay không.
Tóm tắt nhanh
- Vòng coding FDE ở Databricks là bài dễ đến trung bình với dictionary, string, list. Ở OpenAI là một bài implementation kiểu production, được dùng công cụ AI.
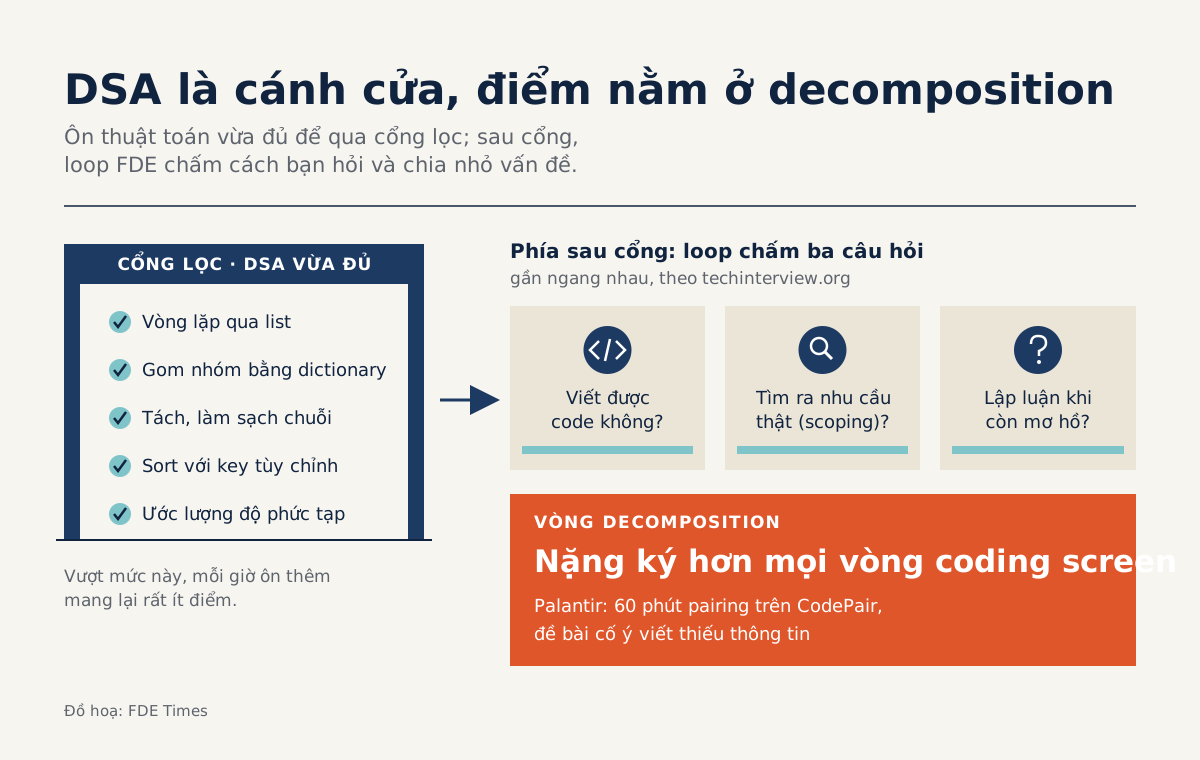
- Loop FDE chấm gần ngang nhau ba thứ: viết code, scoping nhu cầu thật của khách và lập luận khi đề mơ hồ. Vòng decomposition nặng ký hơn mọi vòng coding.
- Luyện DSA đến khi thạo dict, sort và xử lý chuỗi. Thời gian còn lại dành cho bài toán mở và thói quen nói to lập luận.
Còn ba tuần nữa là đến loop FDE của bạn. Phản xạ quen thuộc của dân phần mềm là mở LeetCode, lọc tag Hard rồi cày đồ thị và quy hoạch động đến khuya. Nếu bạn nhắm Databricks, OpenAI hay Palantir, phần lớn công sức đó sẽ rơi vào phần ít được chấm điểm nhất.
Lý do nằm ngay trong đề thi. Vòng coding FDE ở những công ty này giống một ngày làm việc ở chỗ khách hơn là một kỳ thi Olympic: viết một hàm xử lý dữ liệu, dựng một tính năng, rồi sửa lại khi yêu cầu đổi. DSA vẫn cần, nhưng chỉ cần đủ để qua cửa.
Phần dưới đây giúp bạn xác định “đủ” là đến đâu. Sau đó là một bài mẫu làm từ đầu đến cuối, và cách chuyển thời gian còn lại sang những phần nặng điểm hơn.
Vòng coding FDE thật ra hỏi gì?
Theo Aced (trước đây là Exponent), vòng coding FDE của Databricks yêu cầu viết một hàm thực tế trong notebook, độ khó từ dễ đến trung bình. Nội dung xoay quanh xử lý dữ liệu bằng dictionary, string và list. Không có đồ thị, cũng không có cây phân đoạn.
Ở OpenAI, vòng coding FDE gồm các bài kiểu production: một bài implementation lớn, đôi khi chia thành nhiều phần nối tiếp. Bạn được dùng công cụ AI, và lời khuyên đi kèm là chia sẻ màn hình rồi nói to lập luận trong lúc làm. Khi máy viết hộ được vòng lặp, cách bạn suy nghĩ trở thành thứ người phỏng vấn dễ nhìn thấy nhất.
Palantir cũng đi theo hướng đó. Một bài phân tích trên techinterview.org nhận xét công ty này không kiểm tra xem bạn có thuộc lòng Dijkstra hay không. Bài online assessment cũng làm nhiều người bất ngờ vì nó không phải một bộ đề kiểu Codeforces.
| Công ty | Dạng vòng coding | Nên luyện gì |
|---|---|---|
| Databricks | Hàm thực tế trong notebook, dễ đến trung bình | Dict, string, list, gom nhóm, sắp xếp |
| OpenAI | Một bài implementation lớn, có thể chia nhiều phần, được dùng AI | Thiết kế code dễ sửa, nói to lập luận |
| Palantir | Online assessment không theo kiểu Codeforces, cộng vòng decomposition | Bài toán mở, đặt câu hỏi làm rõ |
Vì sao “đủ” là đủ?
Theo techinterview.org, một loop FDE muốn trả lời ba câu hỏi và chấm chúng gần ngang nhau. Bạn có viết được code không? Bạn có tìm ra nhu cầu thật của khách (scoping) không? Bạn có lập luận được khi mọi thứ còn mơ hồ không? Code chỉ là một trong ba phần đó.
Cũng nguồn này cho rằng vòng decomposition nặng ký hơn mọi vòng coding screen trong loop. Ở Palantir, đó là một buổi pairing 60 phút, thường làm trên CodePair, với đề bài cố ý viết thiếu thông tin. Tác giả kết luận khá thẳng: nếu chỉ ôn thuật toán, bạn đang học cho phần ít quan trọng nhất của bài thi.
Vì vậy có thể nói cụ thể “đủ” là gì. Bạn viết trôi chảy vòng lặp qua list, gom nhóm bằng dictionary, tách và làm sạch chuỗi, sắp xếp với key tùy chỉnh, và ước lượng được độ phức tạp của chính code mình viết. Vượt qua mức đó, mỗi giờ ôn thêm mang lại rất ít điểm.
Làm thử một bài kiểu notebook
Thử hình dung một đề theo kiểu Databricks. Khách gửi log hoạt động là một danh sách chuỗi "user_id,action,timestamp" và muốn biết mỗi user làm những hành động nào nhiều nhất. Trước khi gõ code, hãy hỏi lại: dòng sai định dạng thì bỏ qua hay báo lỗi? Nếu số lần bằng nhau thì xếp thế nào? Mỗi user lấy bao nhiêu hành động?
Giả sử người phỏng vấn trả lời: bỏ dòng hỏng, nếu số lần bằng nhau thì xếp theo thứ tự chữ cái, lấy top 3. Một lời giải gọn:
def top_actions(lines, k=3):
    counts = {}
    for line in lines:
        parts = [p.strip() for p in line.split(",")]
        if len(parts) != 3 or not parts[0]:
            continue  # bỏ dòng hỏng, như đã thống nhất
        user, action, ts = parts
        user_counts = counts.setdefault(user, {})
        user_counts[action] = user_counts.get(action, 0) + 1
    return {
        user: sorted(acts.items(), key=lambda x: (-x[1], x[0]))[:k]
        for user, acts in counts.items()
    }
Cả bài chỉ dùng dictionary, string, list và một lần sort, đúng phạm vi Aced mô tả. Điểm cộng không đến từ độ khó mà từ những gì bạn nói trong lúc viết.
Hãy giải thích vì sao bỏ dòng hỏng thay vì để chương trình crash, vì sao key sort là tuple, và vì sao độ phức tạp là O(n) cho bước đếm cộng thêm phần sắp xếp cho từng user.
Khi đề đổi giữa chừng
Bài của OpenAI có thể chia thành nhiều phần nối tiếp, nên hãy luyện cả lúc yêu cầu thay đổi. Giả sử phần hai là: “Giờ khách muốn xem theo từng ngày.” Người mới thường sửa ngay thành ts[:10] rồi chạy. Người làm FDE dừng lại để hỏi: timestamp có cùng định dạng không, có múi giờ không, và “ngày” tính theo giờ của ai?
Có câu trả lời rồi thì phần sửa rất nhỏ: đổi key thành tuple (user, day) hoặc lồng thêm một tầng dictionary. Nếu phần một được viết tách bạch thì phần hai chỉ phải sửa một chỗ, nên ngay từ đầu hãy giữ code đơn giản. Nếu bạn dùng công cụ AI để sinh đoạn sửa, hãy đọc to từng dòng và giải thích vì sao bạn chấp nhận nó.
Phản xạ này cũng chính là kỹ năng của vòng decomposition. Nhận một đề thiếu thông tin, biến nó thành vài quyết định rõ ràng, rồi mới bắt đầu code.
Chia ba tuần ôn thế nào?
Tuần đầu, dành vài buổi kiểm tra xem mình đã “đủ” chưa: làm mười đến mười lăm bài easy-medium về chuỗi, dictionary và sắp xếp, trong notebook chứ không phải trong editor của LeetCode. Nếu làm trôi chảy thì dừng ở đó. Lời khuyên trên techinterview.org là đừng làm thêm năm mươi bài LeetCode nữa, hãy luyện các bài toán mở.
Tuần hai và tuần ba, luyện decomposition theo cặp. Một người đưa ra đề mơ hồ chỉ trong một câu, người kia có 60 phút để hỏi, chia nhỏ vấn đề và code một phần chạy được. Hãy ghi âm lại rồi nghe xem bạn có im lặng quá lâu không, hoặc có đưa ra giả định mà không nói ra hay không.
Song song với đó, đọc kỹ các tin tuyển dụng. Tin FDE của Anthropic yêu cầu kỹ năng giao tiếp tốt để làm discovery với khách và giải thích khái niệm kỹ thuật cho nhiều kiểu stakeholder.
Tin của HackerRank mô tả người phù hợp là người thích kết hợp kỹ thuật, tư vấn và delivery, và tự lo trọn mọi bước từ đầu đến cuối. Nếu bạn là developer Việt Nam làm outsource hay làm product, CV nên có ít nhất một dòng kể lần bạn tự làm rõ yêu cầu với khách. Đừng chỉ liệt kê framework.
Những cái bẫy hay gặp
Bẫy đầu tiên là lao vào code ngay khi đọc xong đề. Với đề cố ý thiếu thông tin, nếu bạn im lặng gõ code thì tức là bạn đã tự trả lời thay khách những câu lẽ ra phải hỏi.
Bẫy thứ hai là dùng AI mà không nói gì. Khi được phép dùng công cụ, một màn hình đầy code đúng nhưng không có lời giải thích gần như không cho người phỏng vấn thấy bạn suy nghĩ thế nào.
Bẫy thứ ba thì ngược lại: nghe nói “DSA không quan trọng” rồi bỏ hẳn, đến lúc phải gom nhóm bằng dictionary lại lúng túng. Vòng lọc vẫn có thể loại bạn.
Bẫy cuối cùng là over-engineer: dựng class, interface và design pattern cho một hàm hai mươi dòng. Ở bài nhiều phần, code đơn giản và tách bạch thường dễ sửa hơn code có “kiến trúc đẹp”.
Hãy ôn DSA vừa đủ để qua vòng lọc. Sau đó, phần lớn kết quả phụ thuộc vào những câu hỏi bạn đặt ra trước khi gõ dòng code đầu tiên.
5 nguồn
- Databricks Forward Deployed Engineer Interview (Aced, formerly Exponent)
- OpenAI Forward Deployed Engineer Interview (Aced, formerly Exponent)
- What the forward deployed engineer interview really tests · 2026-08-05
- Inside the Palantir engineering interview loop · 2026-07-21
- WTF is a forward deployed engineer? (and why everyone is hiring them) · 2026-02-11