Bộ nhớ của agent: ba tầng lưu trữ, mỗi tầng một lịch xoá riêng
Khi agent quên sạch hội thoại sau một lần deploy, hay nhớ mãi điều người dùng đã bảo bỏ, đừng vội đổ lỗi cho model mà hãy tự hỏi: bạn đã quyết định lưu gì, lưu ở đâu và bao giờ xoá chưa?
Tóm tắt nhanh
- Short-term memory là rolling buffer hoặc context window, không giữ được gì qua phiên. Long-term memory phải nằm trong database, knowledge graph hoặc vector embedding.
- LangGraph chia hai lớp: checkpointer giữ state của từng thread, store giữ sở thích, sự kiện, tri thức dùng chung giữa các thread. Production cần checkpointer bền vững.
- Xoá cũng là một phần của thiết kế: dọn tool result cũ bằng context editing, prune checkpoint theo retention, và đừng nhồi quá nhiều vào store.
Thử hình dung tuần thứ hai ở site khách hàng. Agent hỗ trợ nội bộ chạy ổn trên máy bạn, nhưng deploy lại một lần là mọi hội thoại đang dở biến mất. Cùng tuần đó, một người dùng than rằng agent vẫn xưng hô theo cách họ đã yêu cầu bỏ từ ba hôm trước.
Hai lỗi này trông ngược nhau, một bên quên, một bên nhớ dai. Trong tình huống giả định này, gốc rễ lại giống nhau: thông tin bị đặt sai tầng và không ai quy định khi nào xoá. Với FDE, đó là việc thiết kế. Khách hàng sẽ hỏi bạn chứ không hỏi nhà cung cấp LLM.
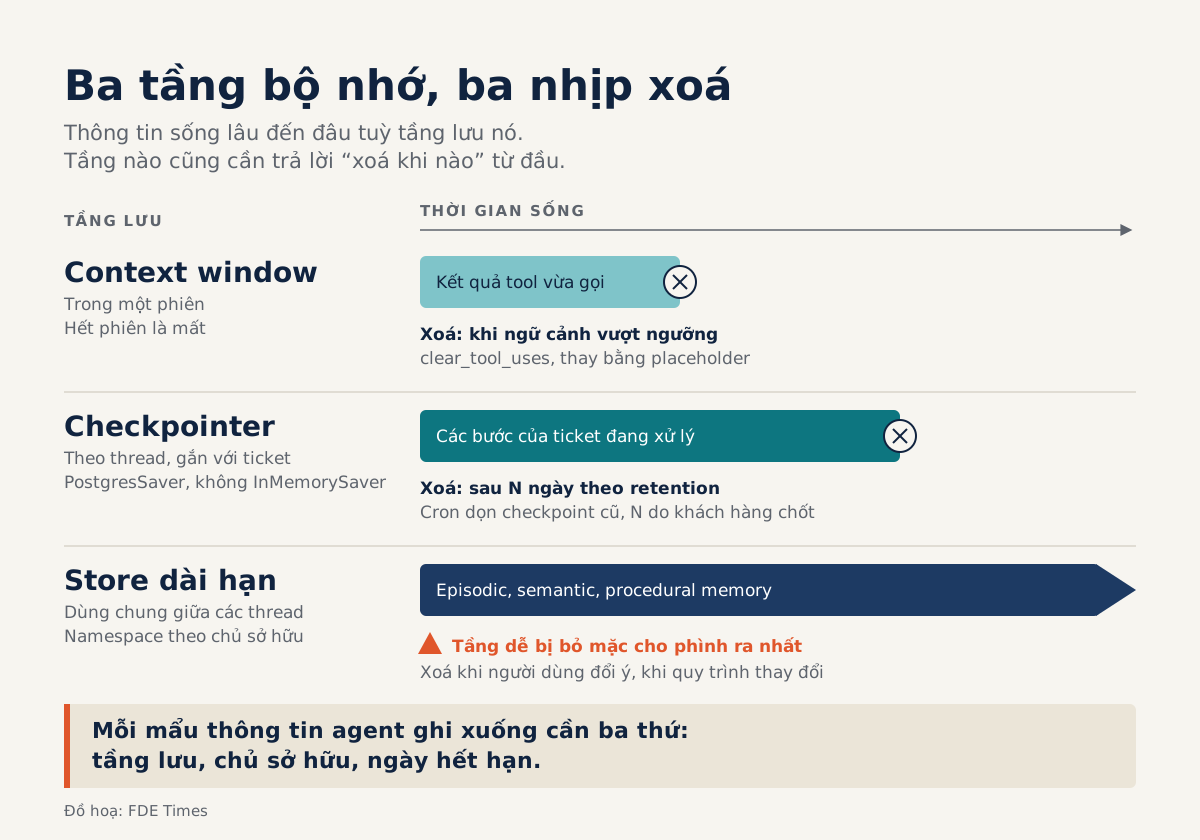
Cách gỡ là chia bộ nhớ thành ba tầng: context window, checkpointer theo thread và store dài hạn. Với mỗi tầng, hãy trả lời câu hỏi “xoá khi nào” ngay từ đầu.
Context window không giữ được gì qua phiên
IBM mô tả short-term memory của agent thường là một rolling buffer hoặc chính context window. Tầng này có một đặc tính quan trọng: nó không giữ được gì sang phiên sau. Thứ gì chỉ nằm trong prompt thì hết phiên là mất.
Long-term memory, cũng theo IBM, thường được lưu trong database, knowledge graph hoặc vector embedding. IBM còn tách long-term memory thành ba loại. Cả ba đều thuộc tầng dài hạn, nhưng cách tách này rất có ích khi bạn ngồi phân loại dữ liệu cùng khách hàng.
Loại đầu là episodic memory, tức chuyện gì đã xảy ra, thường được triển khai bằng cách ghi log sự kiện, hành động và kết quả theo cấu trúc. Loại thứ hai là semantic memory, lưu tri thức dạng sự kiện có cấu trúc, ví dụ “khách hàng A dùng hợp đồng loại B”.
Loại thứ ba là procedural memory, gồm kỹ năng, quy tắc và hành vi đã học, như “luôn xin xác nhận trước khi huỷ đơn”.
Phân loại xong, câu hỏi “lưu ở đâu” gần như tự có lời giải.
Hai lớp trong code: thread và cross-thread
LangGraph biến ý tưởng trên thành hai thành phần cụ thể. Checkpointer lưu state của graph trong một thread dưới dạng các checkpoint, nên đây là bộ nhớ ngắn hạn theo thread. Store dùng cho bộ nhớ dài hạn dùng chung giữa các thread: sở thích người dùng, sự kiện, tri thức chung.
Tài liệu LangGraph nói thẳng rằng hầu hết ứng dụng nên dùng cả hai. Checkpointer theo dõi thread hiện tại, còn store giữ những gì cần tồn tại lâu dài giữa các thread.
Quay lại hai lỗi ở đầu bài. Hội thoại biến mất sau khi deploy là dấu hiệu kinh điển của InMemorySaver: theo LangGraph, checkpointer này mất hết dữ liệu khi process khởi động lại, và production nên dùng loại bền vững như PostgresSaver. Còn lỗi xưng hô sai là chuyện của store: sở thích đã được ghi nhưng không bao giờ được cập nhật.
Ví dụ: agent hỗ trợ cho một công ty logistics
Thử hình dung bạn deploy một agent trả lời nhân viên vận hành của một công ty giao hàng. Trước khi viết dòng code nào, hãy ngồi với khách hàng điền bảng dưới đây. Các dòng trong bảng là ví dụ giả định, không phải quy chuẩn.
| Thông tin | Loại | Tầng lưu | Xoá khi nào |
|---|---|---|---|
| Kết quả tool tra cứu đơn hàng vừa gọi | Ngắn hạn trong phiên | Context window | Khi ngữ cảnh vượt ngưỡng |
| Các bước của một ticket đang xử lý | Ngắn hạn theo thread | Checkpointer | Sau N ngày theo retention |
| “Anh Minh thích trả lời ngắn, xưng anh” | Semantic | Store, namespace theo user | Khi người dùng đổi ý hoặc yêu cầu xoá |
| “Lần trước đổi kho thì hỏng route” | Episodic | Store, ghi dạng log có cấu trúc | Theo chính sách lưu log của khách hàng |
| “Huỷ đơn phải hỏi xác nhận” | Procedural | Store, namespace dùng chung | Khi quy trình thay đổi |
Đừng để trống cột cuối. Hãy điền nó ngay trong buổi discovery, khi người có quyền quyết định còn ngồi cùng bàn.
Khung code tương ứng gọn hơn bạn nghĩ. Checkpointer và store đều được tạo rõ ràng, gọi setup() một lần để tạo bảng, còn việc ghi sở thích nằm trong một node:
from langgraph.checkpoint.postgres import PostgresSaver
from langgraph.store.postgres import PostgresStore
from langgraph.store.base import BaseStore

# node ghi sở thích theo namespace của user
def ghi_so_thich(state, config, *, store: BaseStore):
    user_id = config["configurable"]["user_id"]
    store.put(("users", user_id), "style",
              {"tone": "ngắn", "xung_ho": "anh"})
    return {}

builder.add_node("ghi_so_thich", ghi_so_thich)

# checkpointer và store bền vững: sống qua mỗi lần deploy
with PostgresSaver.from_conn_string(DB_URI) as checkpointer, \
     PostgresStore.from_conn_string(DB_URI) as store:
    checkpointer.setup()  # tạo bảng ở lần chạy đầu
    store.setup()
    graph = builder.compile(checkpointer=checkpointer, store=store)

    config = {"configurable": {"thread_id": ticket_id, "user_id": user_id}}
    graph.invoke({"messages": [msg]}, config)
Chi tiết đáng chú ý là thread_id gắn với ticket chứ không gắn với người dùng. Ticket đóng thì checkpoint hết giá trị. Sở thích của anh Minh thì phải sống qua mọi ticket, nên nó nằm trong store, dưới namespace mang user_id.
Xoá khi nào? Ba tầng, ba nhịp
Nhịp đầu tiên diễn ra ngay trong một phiên, ở tầng context window. Context editing của Anthropic có strategy clear_tool_uses_20250919, tự xoá các tool result cũ khi ngữ cảnh vượt ngưỡng bạn cấu hình. Mỗi kết quả bị xoá được thay bằng một placeholder, nhờ vậy model biết đã có nội dung bị loại bỏ.
Cái giá là xoá nội dung sẽ làm mất hiệu lực phần prompt prefix đã cache, nên chi phí và độ trễ có thể tăng ở lượt kế tiếp. Nếu dùng kèm memory tool, Claude sẽ nhận cảnh báo tự động khi ngữ cảnh gần chạm ngưỡng để kịp lưu thông tin quan trọng.
Với agent logistics, điều đó có nghĩa là mã đơn đang xử lý phải được ghi ra ngoài trước khi kết quả tra cứu bị dọn.
Nhịp thứ hai thuộc về checkpointer. LangGraph khuyên định kỳ dọn checkpoint cũ hoặc đặt chính sách retention, chẳng hạn một cron xoá checkpoint quá N ngày. Con số N do khách hàng quyết định, còn việc của bạn là đề xuất và ghi lại.
Nhịp thứ ba thuộc về store dài hạn, và đây là tầng dễ bị bỏ mặc cho phình ra nhất. IBM xem tối ưu truy xuất là một trong những thách thức lớn nhất khi thiết kế bộ nhớ, vì lưu quá nhiều sẽ làm phản hồi chậm đi.
Nhồi mọi câu chat vào vector store không giúp agent thông minh hơn, chỉ làm nó chậm và dễ lôi nhầm ký ức.
Tự làm theo thứ tự nào
Bắt đầu bằng bảng phân loại ở trên, làm cùng khách hàng chứ đừng làm một mình. Tiếp theo, dùng checkpointer bền vững ngay từ môi trường dev, để lỗi mất state khi process khởi động lại lộ ra sớm, trước khi lên production.
Sau đó thiết kế namespace cho store theo chủ sở hữu dữ liệu, để khi có yêu cầu “xoá dữ liệu của tôi” bạn chỉ cần xoá một namespace.
Cuối cùng mới đến việc bật context editing và chỉnh ngưỡng. Hãy đo độ trễ trước và sau khi bật, vì cache bị vô hiệu là chuyện có thật.
Những lỗi gặp nhiều nhất
Lỗi phổ biến nhất là để InMemorySaver lên production vì “demo chạy được”. Lỗi thứ hai là trộn state của thread với sự thật về người dùng, khiến đóng ticket là mất luôn sở thích, hoặc ngược lại, rác của ticket cũ lẫn vào mọi hội thoại mới.
Lỗi thứ ba là coi store như thùng chứa vô hạn, rồi một quý sau phải đi điều tra vì sao agent chậm. Lỗi thứ tư khó thấy hơn: không ai sở hữu chính sách xoá, nên nếu đội pháp chế của khách hàng hỏi, không ai trả lời được.
Khi đọc JD cho vị trí FDE, nếu gặp những cụm như “stateful agents”, “conversation persistence” hay “data retention”, đó là chỗ nên kể kinh nghiệm này. Trên CV, một dòng như “thiết kế bộ nhớ hai lớp cho agent, có checkpointer bền vững và retention theo ticket” có sức nặng hơn hẳn “đã dùng LangGraph”.
Bài tập tuần này
Lấy một agent bạn từng viết, kể cả bản demo cá nhân. Điền bảng bốn cột cho mọi thứ nó đang nhớ, rồi restart process giữa chừng một hội thoại và ghi lại những gì còn, những gì mất.
Dòng nào trong bảng có cột “xoá khi nào” để trống thì đó là sự cố đang chờ xảy ra ở site khách hàng đầu tiên của bạn.