Dựng agent text-to-SQL trên kho dữ liệu của khách: viết định nghĩa trước, viết prompt sau
Câu SQL chạy không lỗi nhưng trả về một con số mà phòng tài chính không công nhận. Đó là kiểu lỗi bạn sẽ gặp nhiều nhất, và bài hướng dẫn này chỉ cách bắt nó trước khi khách bắt được.
Tóm tắt nhanh
- Một tác giả làm cho công ty bán semantic layer cho rằng ở production, text-to-SQL chủ yếu hỏng ở ngữ nghĩa chứ không ở cú pháp. Hãy tự kiểm chứng điều này trên dữ liệu của bạn.
- Thả agent vào dữ liệu lộn xộn khi định nghĩa nghiệp vụ còn mơ hồ thì kết quả sẽ sai. Giá trị thật nằm ở việc dựng và sửa dần semantic layer.
- Agent của Vercel vẫn chạy tốt sau khi bỏ phần lớn tool, vì semantic layer của họ đã được viết tài liệu kỹ.
Vercel đã bỏ phần lớn số tool khỏi agent text-to-SQL của họ, và agent vẫn chạy tốt. Lý do không nằm ở prompt hay ở model. Theo mô tả về case này, cách làm đó hiệu quả vì semantic layer của Vercel vốn đã được viết tài liệu kỹ.
Với một FDE, chi tiết này cho biết khá rõ bạn sẽ dành thời gian vào đâu khi khách nhờ “làm cái chatbot hỏi dữ liệu”. Phần lớn thời gian không đi vào code agent. Nó đi vào việc ghi lại cho rõ từng con số trong kho dữ liệu của khách được tính như thế nào.
Bài này dựng một agent nhỏ theo đúng thứ tự đó: định nghĩa đi trước, rồi tới chọn ngữ cảnh, sinh SQL, và cuối cùng là chấm điểm. Các đoạn code là giả mã hoặc cấu hình tự đặt, đã được rút gọn. Bạn ráp chúng vào framework và model mình đang dùng.
Bạn cần chuẩn bị những gì?
Bạn cần ba thứ: SQL đủ chắc để tự viết câu truy vấn đúng, một database mẫu chạy được trên laptop, và quyền gọi một LLM bất kỳ. Nếu chưa từng làm agent, hãy học trước khoá ngắn Building Your Own Database Agent mà DeepLearning.AI làm cùng Microsoft. Khoá ở mức beginner, dài khoảng 1 giờ 8 phút, dạy dựng agent dịch ngôn ngữ tự nhiên sang SQL.
Mục tiêu khoá học đặt ra là dùng ngôn ngữ tự nhiên để làm việc với dữ liệu dạng bảng và database SQL, giúp việc phân tích nhanh hơn và dễ tiếp cận hơn. Khoá học cho bạn một agent chạy được. Phần còn lại của bài này giúp agent đó trả lời đúng.
Để có ví dụ xuyên suốt, thử hình dung khách là một chuỗi bán lẻ với hai bảng:
-- Schema giả định, rút gọn
orders(order_id, customer_id, amount, status, created_at)
refunds(refund_id, order_id, refund_amount, refunded_at)
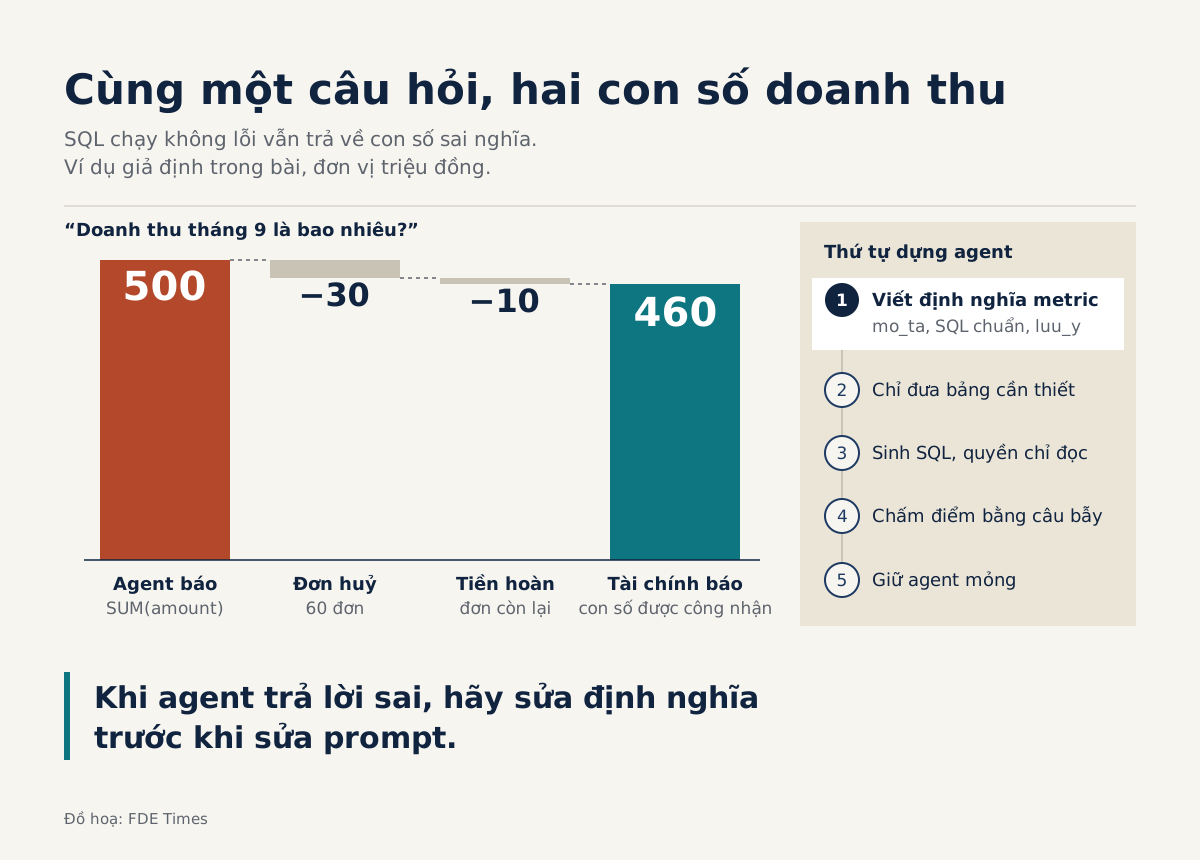
Bước 1: Hỏi “doanh thu” nghĩa là gì trước khi viết prompt
Câu hỏi đầu tiên khách gõ vào gần như chắc chắn sẽ là “Doanh thu tháng 9 là bao nhiêu?”. Một agent chưa được dạy gì sẽ sinh ra câu sau:
SELECT SUM(amount)
FROM orders
WHERE created_at >= '2026-09-01' AND created_at < '2026-10-01';
Câu này chạy không lỗi. Thử hình dung với số cụ thể: tháng 9 có 1.000 đơn, tổng 500 triệu đồng. Trong đó 60 đơn bị huỷ trị giá 30 triệu, và các đơn còn lại bị hoàn tổng cộng 10 triệu.
Agent báo 500 triệu. Phòng tài chính, vốn tính doanh thu sau khi trừ đơn huỷ và tiền hoàn, báo 500 − 30 − 10 = 460 triệu. Chỉ sau một câu hỏi, khách đã mất niềm tin.
Đây đúng là kiểu lỗi mà một bài viết về context engineering cho data agent mô tả: lỗi nằm ở ngữ nghĩa, không nằm ở cú pháp. Tác giả bài đó làm cho một công ty bán sản phẩm semantic layer, nên bạn hãy tự kiểm chứng trên dữ liệu của mình. Nhưng ví dụ doanh thu ở trên cho thấy kiểu lỗi này hoàn toàn có thể xảy ra.
Vì thế, việc đầu tiên là ngồi với người phụ trách số liệu của khách và ghi lại định nghĩa. Dưới đây là một file định nghĩa tối giản theo định dạng tự đặt, không theo chuẩn của công cụ nào:
# semantic_layer.yaml (định dạng tự đặt, rút gọn)
metrics:
  doanh_thu:
    mo_ta: "Doanh thu đơn không huỷ trong kỳ, trừ tiền hoàn của chính các đơn đó"
    sql_file: doanh_thu.sql
    bang: [orders, refunds]
    luu_y: "Kỳ tính theo created_at của đơn. Cộng orders và refunds ở hai truy vấn riêng"
Câu SQL chuẩn đi kèm metric này nằm trong một file riêng:
-- doanh_thu.sql (rút gọn)
(SELECT COALESCE(SUM(amount), 0) FROM orders
  WHERE status <> 'cancelled'
    AND created_at >= :tu_ngay AND created_at < :den_ngay)
-
(SELECT COALESCE(SUM(r.refund_amount), 0)
   FROM refunds r JOIN orders o ON r.order_id = o.order_id
  WHERE o.status <> 'cancelled'
    AND o.created_at >= :tu_ngay AND o.created_at < :den_ngay)
Lưu ý dòng luu_y. Nếu JOIN orders với refunds rồi cộng amount trong cùng một câu, đơn nào bị hoàn hai lần sẽ bị cộng amount hai lần. SQL vẫn chạy, con số vẫn sai, nên quy tắc này phải được ghi thẳng vào định nghĩa.
Sau bước này, hãy đọc lại từng dòng mo_ta cho chính người làm số liệu bên khách nghe. Nếu họ phải sửa dù chỉ một chữ, nghĩa là định nghĩa chưa xong.
Bước 2: Chỉ đưa cho model những bảng nó cần
Kho dữ liệu thật của khách có thể có hàng trăm bảng. Bài viết về context engineering khuyên rằng với mỗi câu hỏi, bạn chỉ chọn vài bảng và cột liên quan thay vì đưa cả schema. Cách đơn giản nhất là đi qua semantic layer: câu hỏi khớp với metric nào thì lấy đúng các bảng mà metric đó khai báo.
# Giả mã, rút gọn
def build_context(question, semantic_layer):
    metrics = match_metrics(question, semantic_layer)   # so khớp từ khoá hoặc embedding
    tables = {t for m in metrics for t in m["bang"]}
    return {
        "metrics": metrics,                 # định nghĩa + SQL chuẩn
        "schema": describe(tables),         # chỉ các cột của bảng liên quan
    }
Cách kiểm tra là in ra ngữ cảnh của 10 câu hỏi. Nếu câu hỏi về doanh thu mà ngữ cảnh lại chứa bảng inventory, hàm so khớp của bạn đang quá rộng. Nếu ngữ cảnh thiếu refunds, lỗi nằm ở file định nghĩa chứ không nằm ở code.
Bước 3: Sinh SQL và chạy bằng quyền chỉ đọc
Prompt lúc này ngắn hơn nhiều so với hình dung ban đầu. Bạn đưa vào định nghĩa, schema thu gọn và câu hỏi, rồi yêu cầu model ưu tiên dùng SQL chuẩn của metric khi có sẵn.
# Giả mã, rút gọn
ctx = build_context(question, semantic_layer)
sql = llm.generate(PROMPT.format(**ctx, question=question))
result = run_readonly(sql)   # tài khoản DB chỉ có quyền SELECT
return {"sql": sql, "result": result, "metrics_used": ctx["metrics"]}
Có hai điều nên làm ngay từ bản đầu. Tài khoản database của agent chỉ được cấp quyền đọc. Mỗi câu trả lời luôn kèm câu SQL và tên metric đã dùng, để người của khách tự soát lại được.
Tác giả một bài trên Forbes Tech Council cảnh báo về các rủi ro quản trị trong phân tích bằng AI: tính minh bạch, tính công bằng và trách nhiệm giải trình. Trả kèm SQL là cách rẻ nhất để đáp ứng yêu cầu minh bạch.
Bước 4: Chấm điểm bằng câu hỏi có cài bẫy
Một bộ test chỉ kiểm tra “SQL có chạy không” sẽ cho điểm tuyệt đối với câu 500 triệu ở trên. Vì vậy, mỗi câu hỏi kiểm thử phải đi kèm đáp án là một con số do chính người của khách xác nhận.
| Câu hỏi | Bẫy ngữ nghĩa | Đáp án kiểm bằng |
|---|---|---|
| Doanh thu tháng 9? | Đơn huỷ, tiền hoàn | Con số trên báo cáo tài chính |
| Có bao nhiêu khách mua trong quý 3? | Đếm đơn thay vì đếm khách | COUNT(DISTINCT customer_id) do người phân tích viết |
| Tỷ lệ huỷ tuần trước? | Mẫu số tính trên đơn nào | Định nghĩa trong semantic_layer.yaml |
Khi một câu trả lời sai, đừng vội sửa prompt. Hãy hỏi xem định nghĩa có thiếu hay không. Wobby, đơn vị dựng analytics agent cho môi trường production, cho rằng chính quá trình dựng và chỉnh dần semantic layer là nơi tạo ra giá trị.
Mỗi lỗi bắt được nên trở thành một dòng luu_y và một câu hỏi mới trong bộ test. Dòng luu_y không bảo đảm agent sẽ không bao giờ sai lại, nhưng câu test sẽ cho bạn biết ngay nếu lỗi tái phát.
Bước 5: Giữ agent mỏng
Khi gặp lỗi, phản xạ tự nhiên là thêm tool: một tool kiểm tra schema, một tool đoán join, một tool tự sửa câu SQL. Case của Vercel đi theo hướng ngược lại. Họ bỏ phần lớn tool, và bài học rút ra là những kiến trúc được dựng để bù cho điểm yếu hiện tại của model có thể trở thành gánh nặng khi model tốt lên.
Vì thế, hãy dồn công sức vào semantic layer, phần sẽ còn giá trị qua nhiều thế hệ model, và giữ phần khung bọc quanh model ở mức tối thiểu. Mỗi khi định thêm một tool, hãy tự hỏi liệu một dòng định nghĩa tốt hơn có giải quyết được vấn đề hay không.
Những bẫy nào bạn nên tự cài thử?
Lỗi phổ biến nhất là thả agent vào kho dữ liệu nguyên trạng rồi kỳ vọng nó tự hiểu. Wobby nói thẳng rằng làm vậy với dữ liệu tổ chức kém và định nghĩa nghiệp vụ mơ hồ sẽ cho ra kết quả sai. Các bẫy dưới đây là ví dụ giả định để bạn tự cài vào database mẫu và xem agent có rơi vào không.
Bẫy múi giờ: giả sử created_at lưu theo UTC, còn khách xem báo cáo theo giờ Việt Nam (UTC+7). Một đơn đặt lúc 3 giờ sáng ngày 1/10 giờ Việt Nam được lưu là 20 giờ ngày 30/9 UTC, nên rơi vào doanh thu tháng 9.
Hãy chèn vài đơn như vậy, rồi hỏi người làm số liệu của khách đơn đó thuộc tháng nào và ghi câu trả lời vào luu_y.
Bẫy tiền hoàn lệch kỳ: một đơn tạo ngày 28/9 nhưng được hoàn ngày 5/10. Theo định nghĩa ở Bước 1, khoản hoàn này trừ vào tháng 9, nghĩa là doanh thu tháng 9 hôm nay và tuần sau có thể khác nhau. Nếu agent lọc theo refunded_at, nó sẽ trừ khoản này vào tháng 10, và hai con số sẽ không khớp với báo cáo.
Bẫy JOIN nhân dòng: thêm hai bản ghi hoàn cho cùng một đơn, rồi xem agent có JOIN rồi cộng amount hay không. Bẫy cuối là nhồi cả schema vào prompt vì thấy context window còn rộng, rồi chấm điểm bằng việc SQL có chạy hay không thay vì bằng con số đúng.
Bài tập gợi ý: cài cả ba bẫy dữ liệu trên, viết ba câu hỏi tương ứng kèm đáp án tính tay, rồi chạy agent trước và sau khi thêm luu_y. Khoảng cách giữa hai lần chạy là thứ bạn sẽ đem đi trình bày với khách.
Ở chỗ khách, kỹ năng này trông như thế nào?
Bạn sẽ ngồi với người phụ trách số liệu để chốt 5 đến 10 metric quan trọng nhất và xin quyền đọc vào kho dữ liệu.
Devfi, trong một bài nhận định về phân tích dữ liệu bằng AI, nêu ba rào cản khi doanh nghiệp áp dụng: sự kháng cự về văn hoá, lo ngại về quyền riêng tư dữ liệu và giới hạn của hạ tầng kỹ thuật.
Tài khoản chỉ đọc và câu trả lời kèm SQL giúp bạn trả lời một phần nỗi lo về dữ liệu, còn bộ test có đáp án do người của khách duyệt cho họ thứ để tự kiểm chứng. Kháng cự về văn hoá và giới hạn hạ tầng thì không kỹ thuật nào ở trên giải quyết được, và bạn nên nói rõ điều đó với khách từ đầu.
Khi đọc JD của các vị trí FDE hay solutions engineer về dữ liệu, hãy để ý các cụm như “semantic layer”, “metrics definition” hay “evaluation”. Trong CV, thay vì ghi “xây chatbot text-to-SQL”, hãy ghi bạn đã chốt bao nhiêu định nghĩa metric với bên nghiệp vụ, dựng bộ kiểm thử bao nhiêu câu, và tỷ lệ trả lời đúng tăng từ bao nhiêu lên bao nhiêu.
Agent bạn dựng tuần này rồi sẽ được thay bằng model tốt hơn. File định nghĩa doanh thu mà khách đã gật đầu thì vẫn dùng được khi đó.
6 nguồn
- Building Your Own Database Agent · 2025-10-07
- How AI Will Transform Data Analysis in 2025 · 2024-12-23
- How AI Has Changed The World Of Analytics And Data Science · 2025-01-28
- Building Production Analytics Agents with Semantic Layer Integration · 2025
- Simplifying Text-to-SQL Agents by Removing 80% of Tools · 2025
- Context Engineering for Data Agents · 2026-09-10